這些年在公司資訊部門工作,我有一個越來越強烈的感覺:
我們可能一直在拿法拉利送外賣。
現在公司只要談到 AI,不管碰到什麼問題,第一個反應通常都是:「丟給大型語言模型。」
要整理文件,丟給 ChatGPT。
要分析資料,丟給 Claude。
要分類客服問題,還是丟給大型模型。
甚至連「這封信是不是垃圾郵件」、「這個操作有沒有風險」、「這個任務應該交給哪一個 Agent」這種只有幾個答案的問題,我們也習慣呼叫大型語言模型。
一開始我也覺得這很正常。
直到最近看到 TypeSafe AI 推出的 Jev,我才開始重新思考一件事情:
企業真的需要每一件 AI 工作,都出動大型語言模型嗎?
大型語言模型很強,但不代表什麼都該給它做
ChatGPT、Claude、Gemini 這類大型語言模型最厲害的地方,就是它們能理解複雜內容,再生成文字。
例如寫文章、整理會議紀錄、分析技術文件、修改程式、回答複雜問題,這些工作本來就需要理解與生成能力。
這時候使用大型模型很合理。
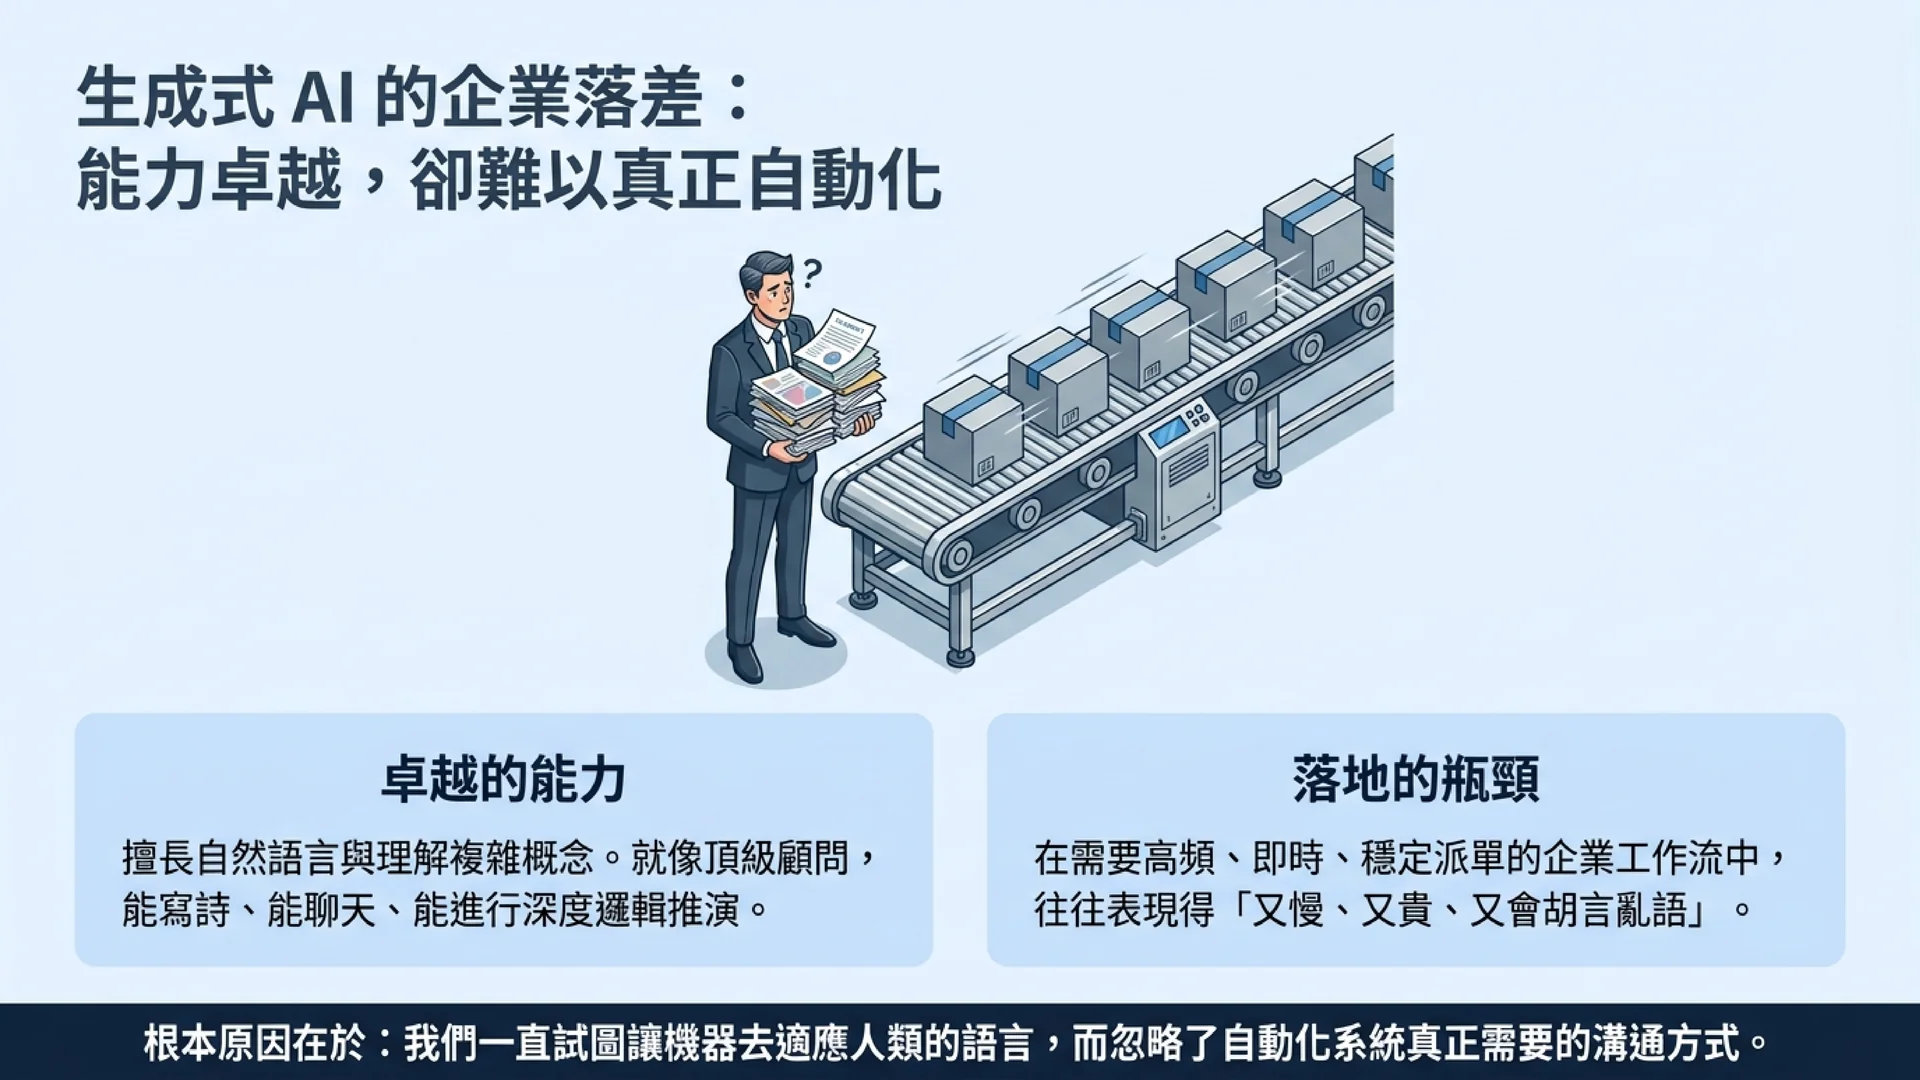
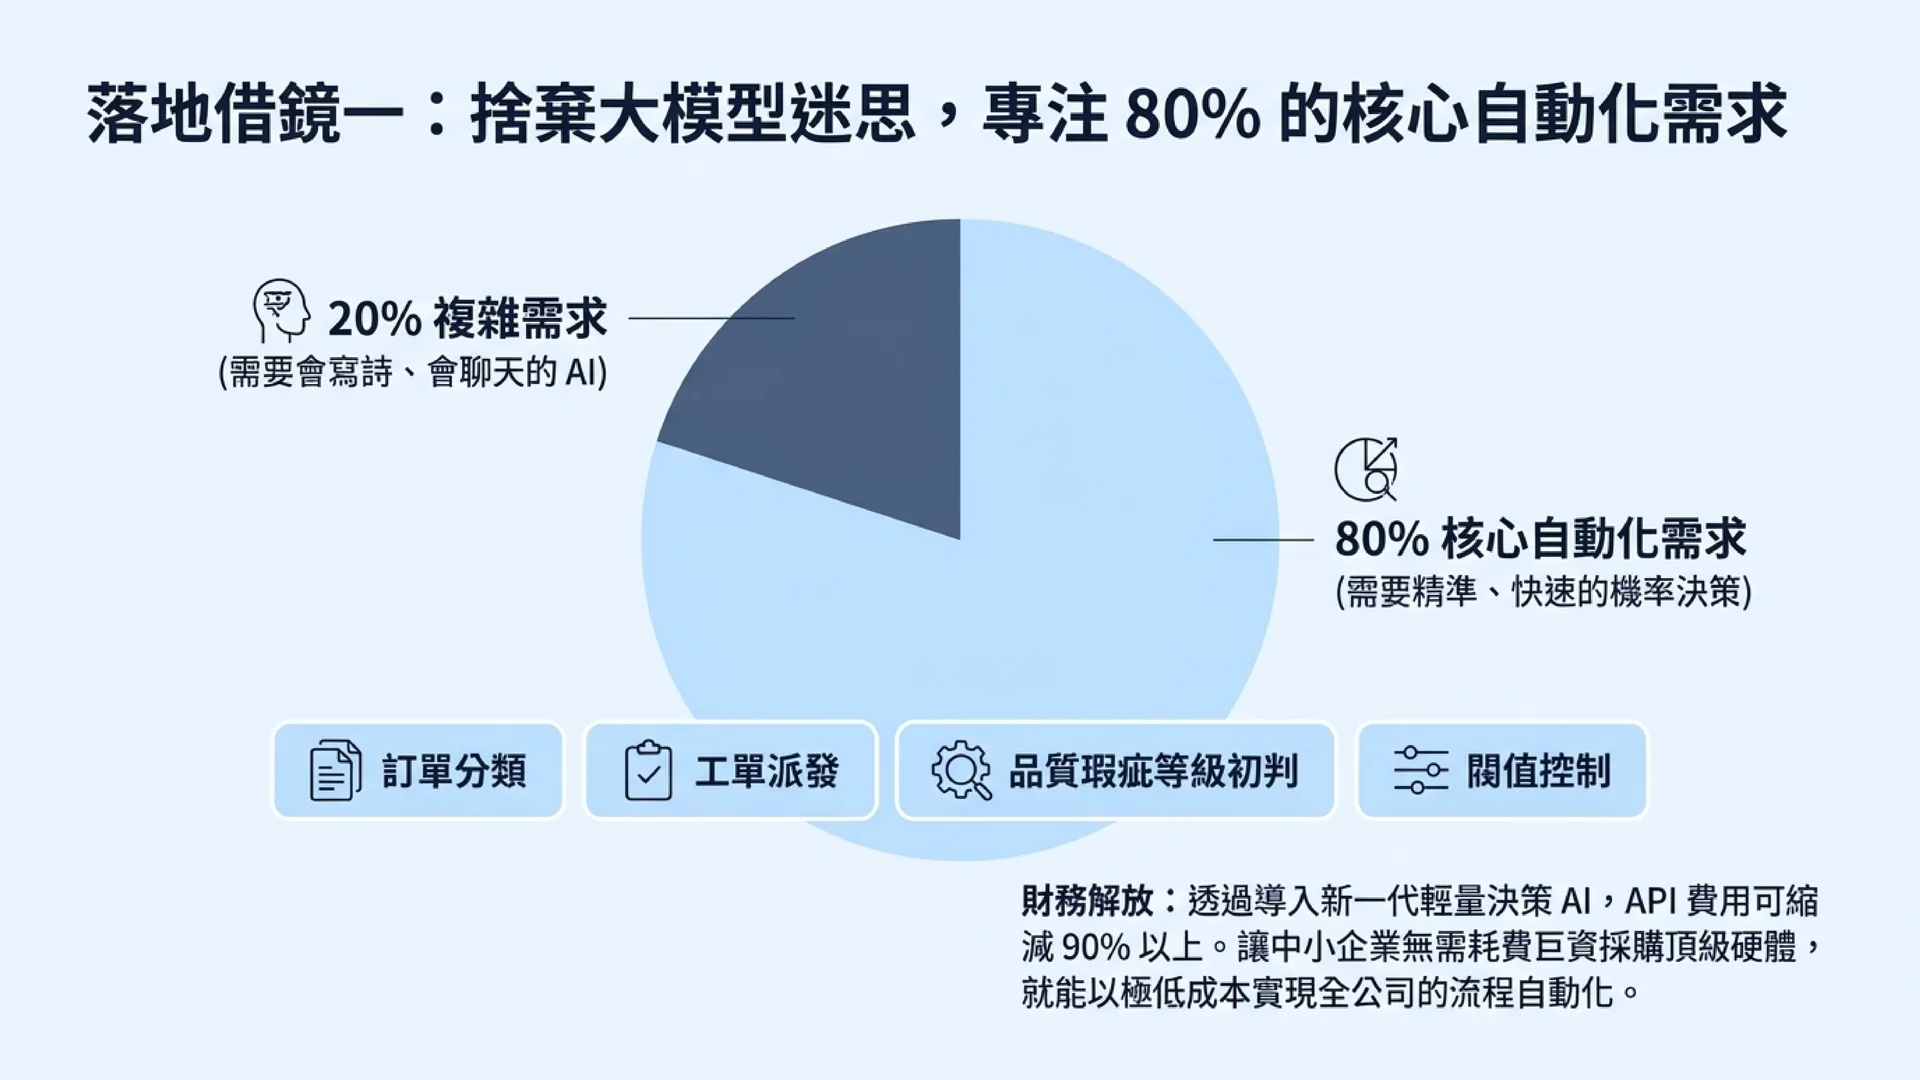
問題是,企業真正導入 AI 之後,會發現大量工作根本不是「生成」。
而是「判斷」。
例如:
收到一封 Email,要判斷是不是垃圾郵件。
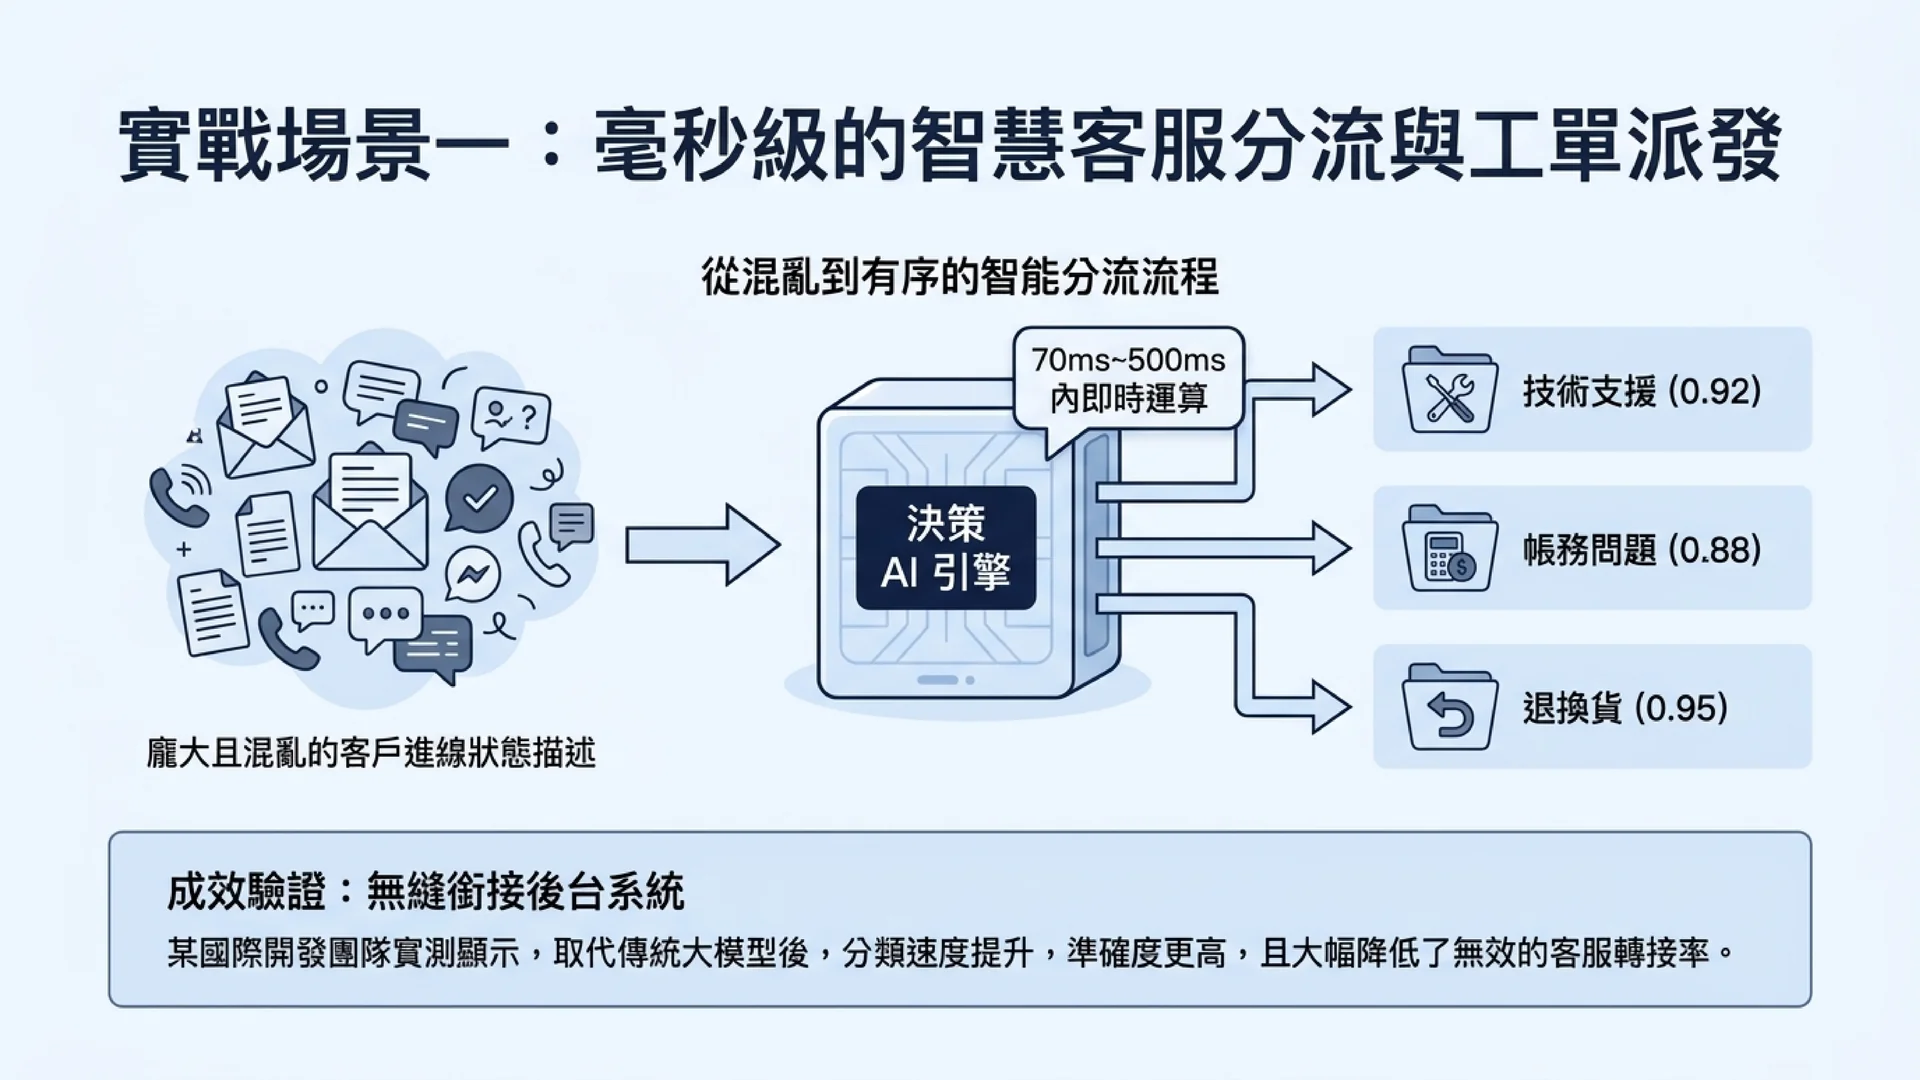
收到客服問題,要判斷應該送給業務、客服還是技術部門。
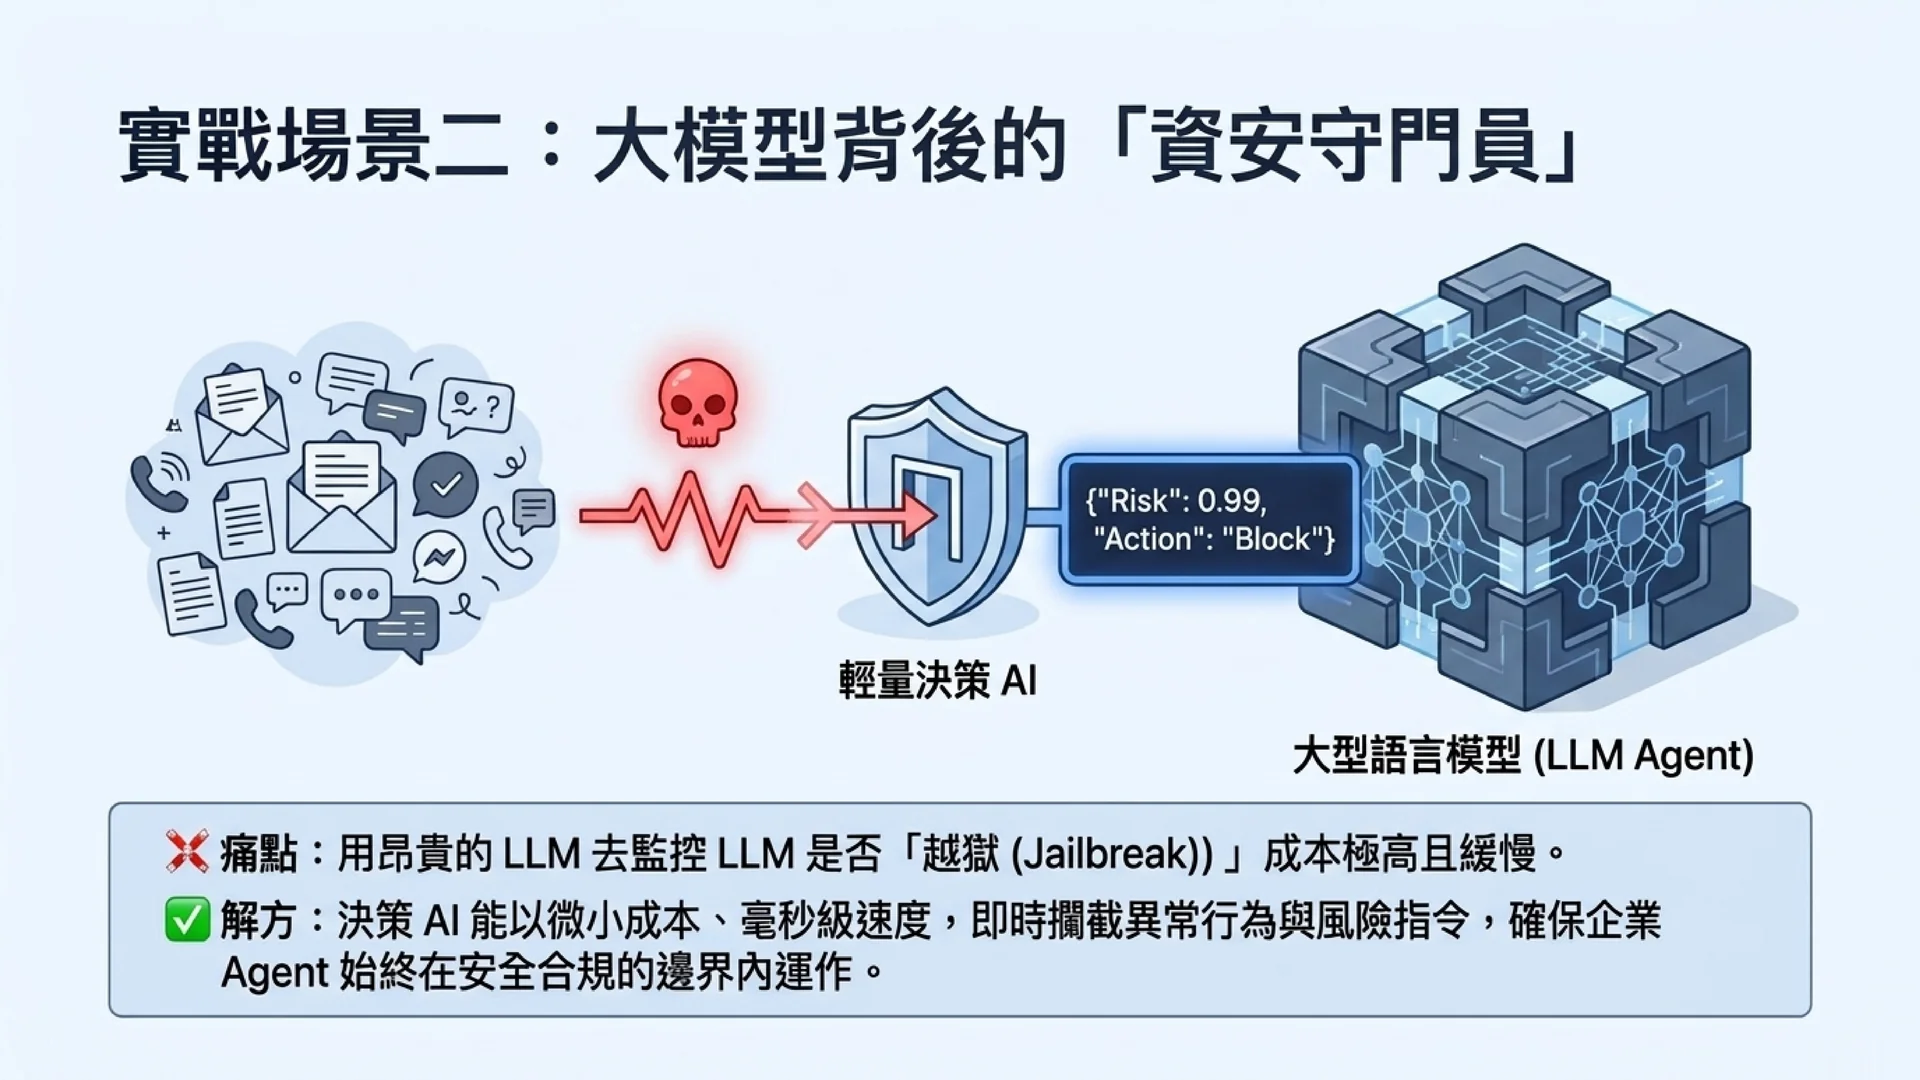
AI Agent 準備執行一個 Shell Command,要判斷這個操作是否安全。
一個 Coding Agent 已經累積大量 Context,要判斷哪些資訊值得保留。
甚至 Multi-Agent System 裡面,也需要決定下一個工作到底要交給哪一個 Agent。
這些工作都有一個共同特色:
我們其實不需要 AI 寫一篇文章給我們。
我們需要的可能只是 Yes 或 No。
或者從 A、B、C 三個答案裡選一個。
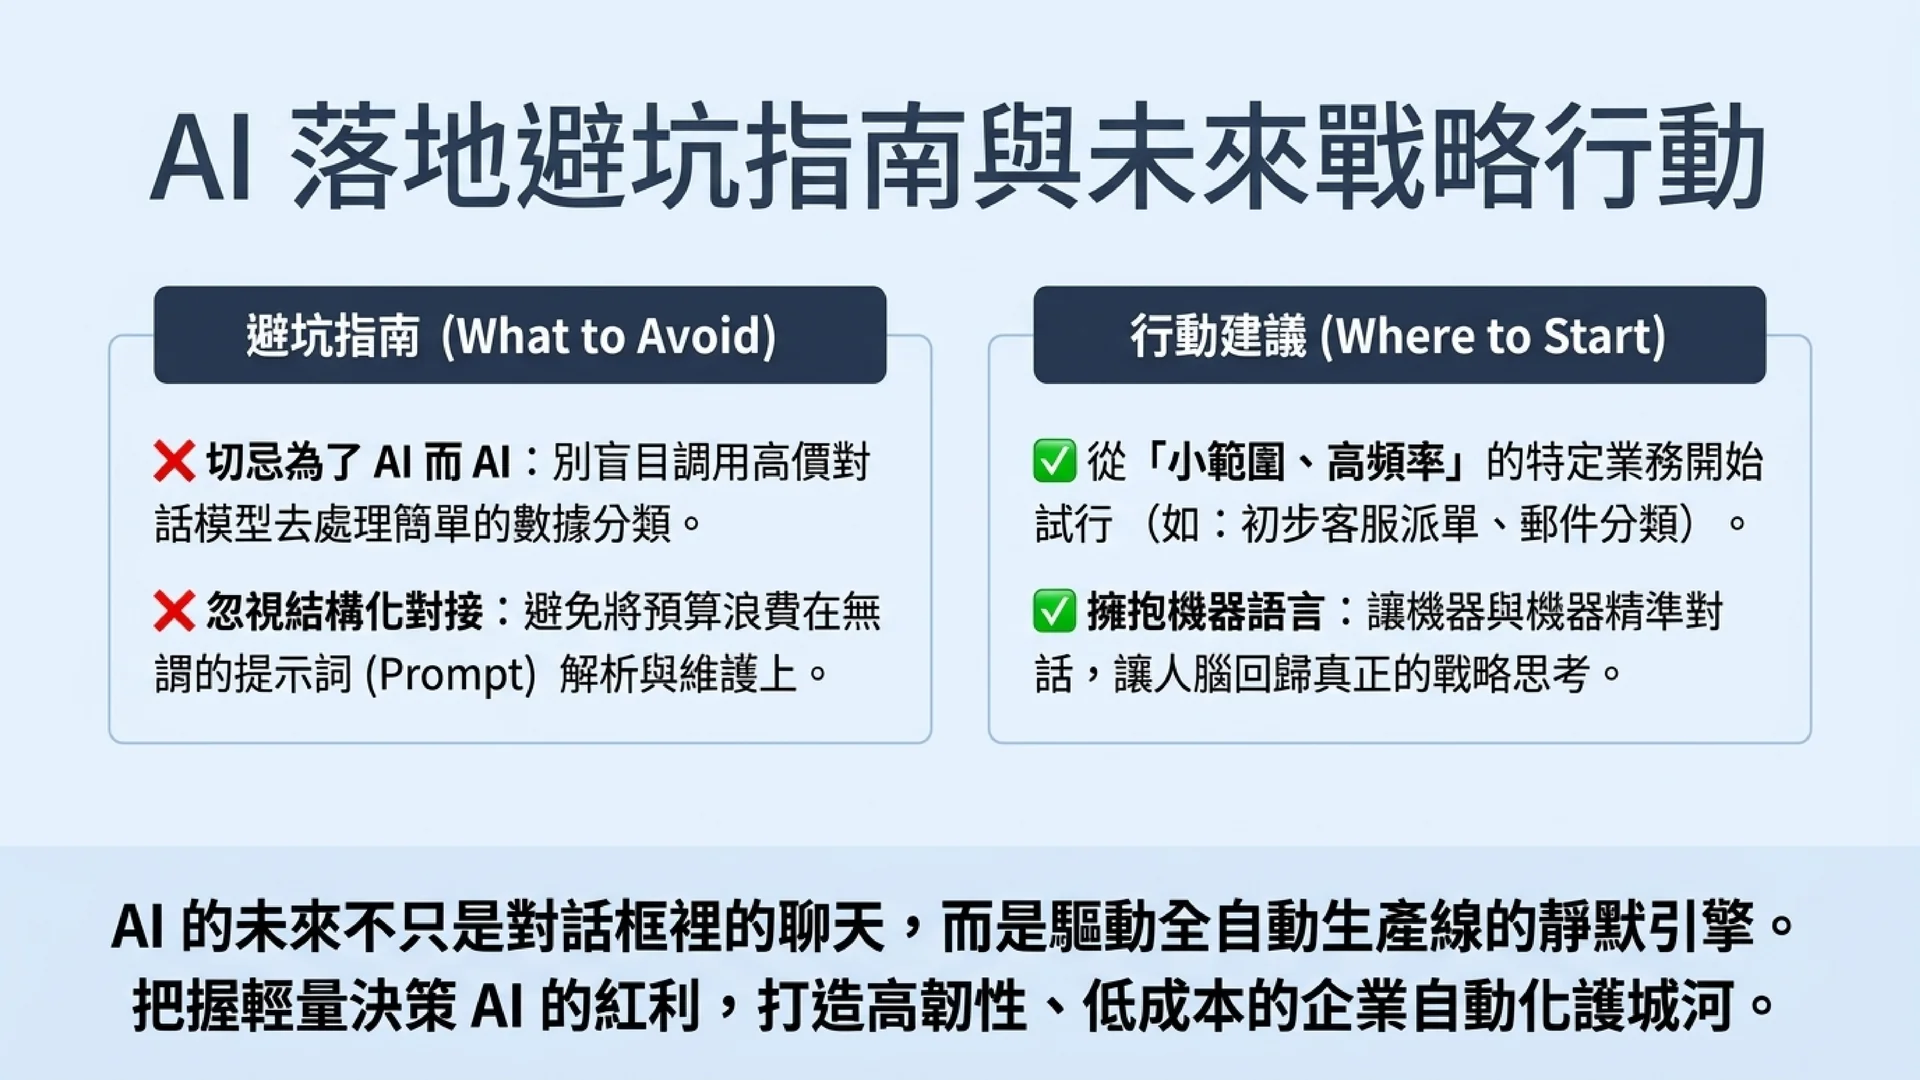
如果只是做這種事情,還每次都叫大型模型出來工作,就有點像開著一台法拉利去巷口送便當。
不是不能送。
而是成本結構不太合理。
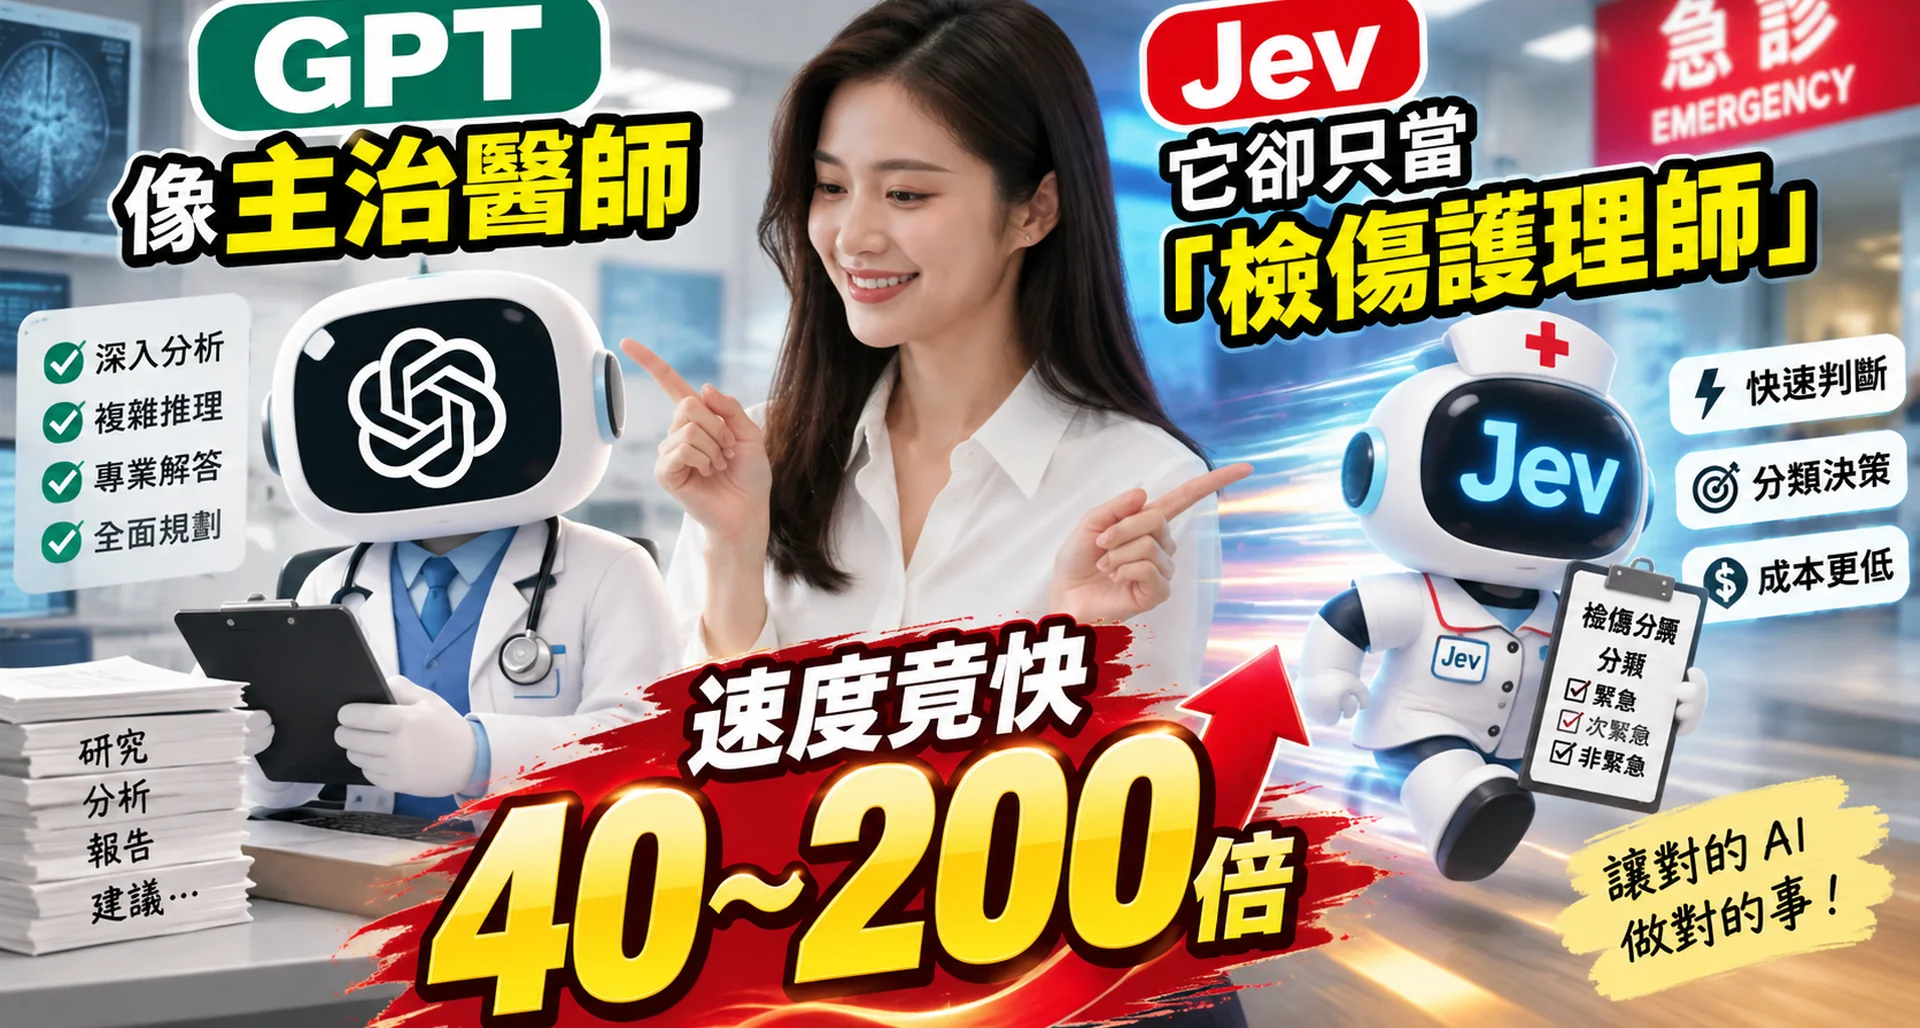
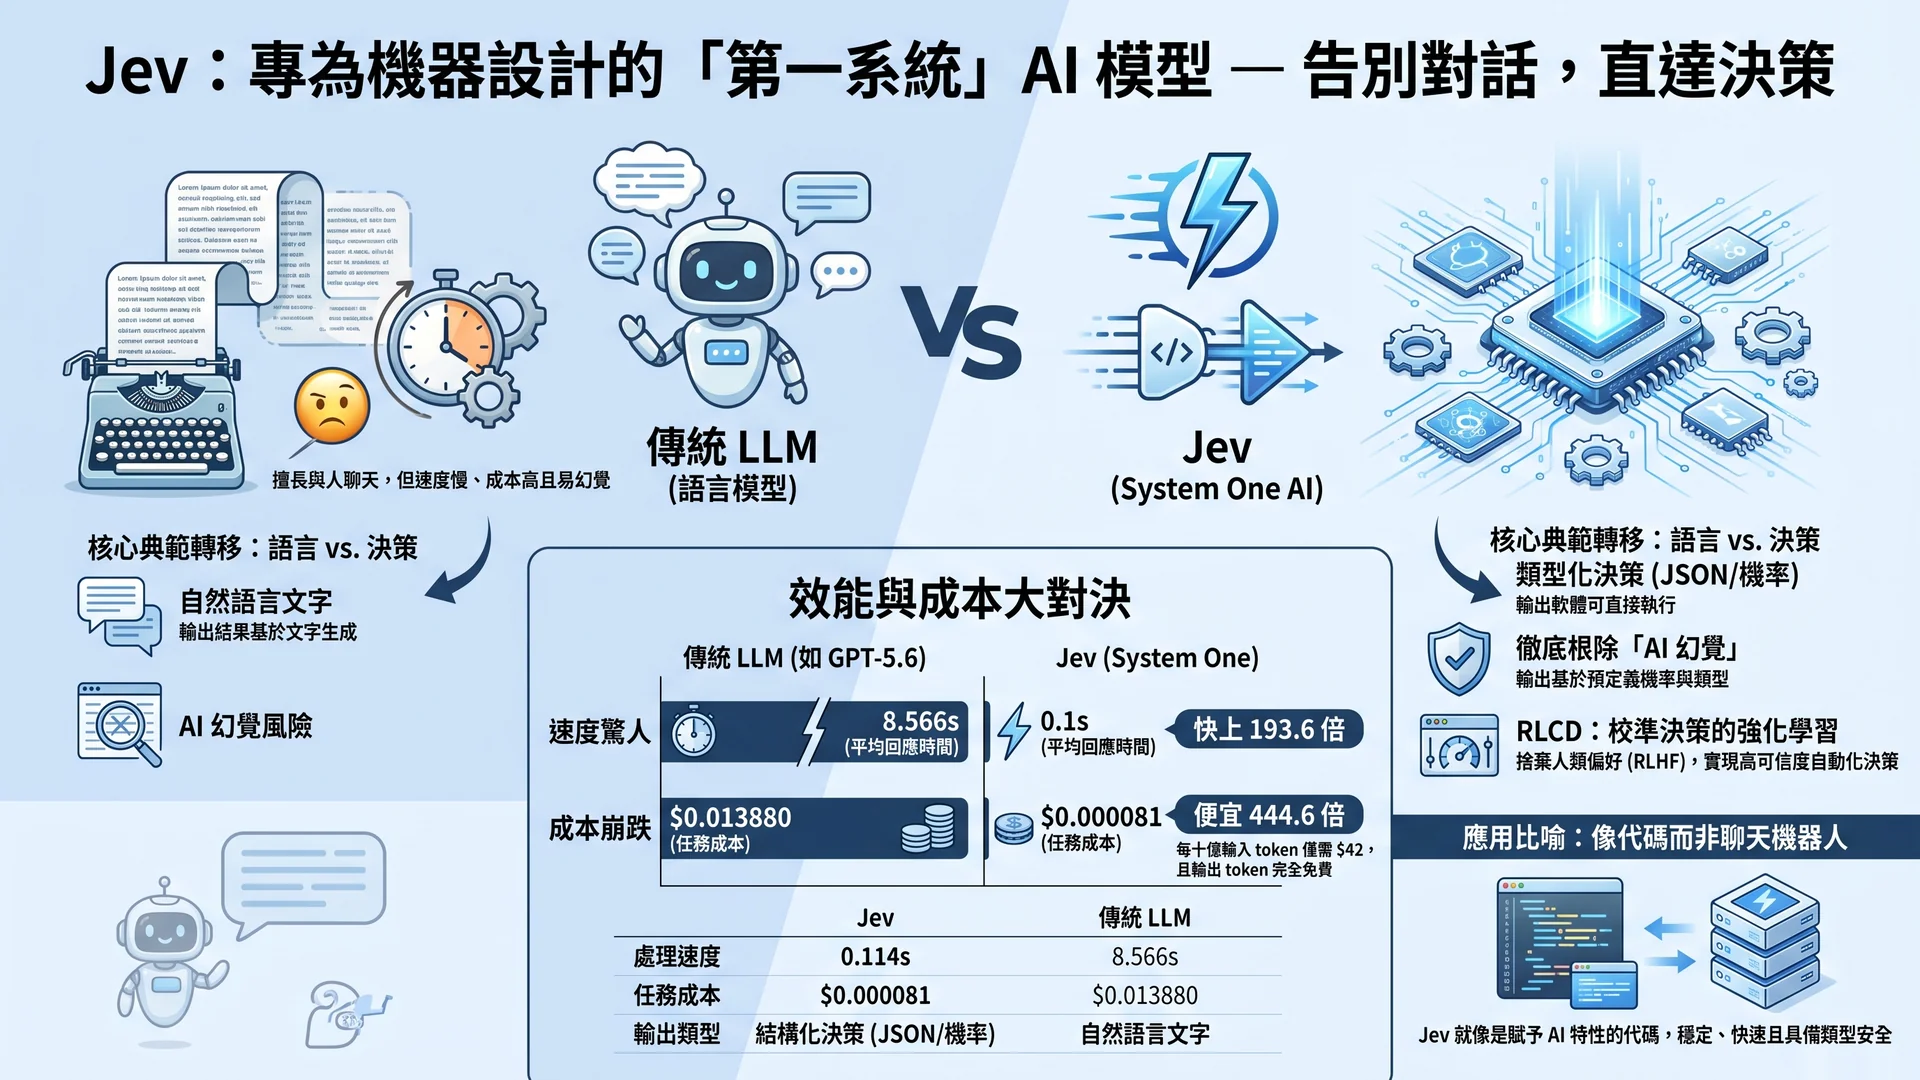
Jev 最有趣的地方,就是它不跟 ChatGPT 搶工作
我第一次看到 Jev 時,覺得最有意思的反而不是它有多「聰明」。
而是它很清楚自己不要做什麼。
Jev 不是拿來聊天的,也不是拿來幫你寫 2,000 字文章。
它專注在比較窄的決策型工作。
例如從幾個選項裡選一個、對某件事情評分,或者回答 Yes/No。
對企業資訊部門來說,這種定位其實很有意思。
因為我們在設計系統時,本來就不會希望所有工作全部塞進同一個程式。
資料庫有資料庫的工作。
Web Server 有 Web Server 的工作。
Queue 有 Queue 的工作。
Load Balancer 也有自己的工作。
可是進入生成式 AI 時代之後,我們反而常常犯了一個很奇怪的錯誤:
所有事情都叫同一個大型模型處理。
這可能只是因為過去沒有更適合的工具。
如果 Jev 這類專門負責 Decision 的模型逐漸成熟,未來 AI 架構很可能也會開始出現更清楚的分工。
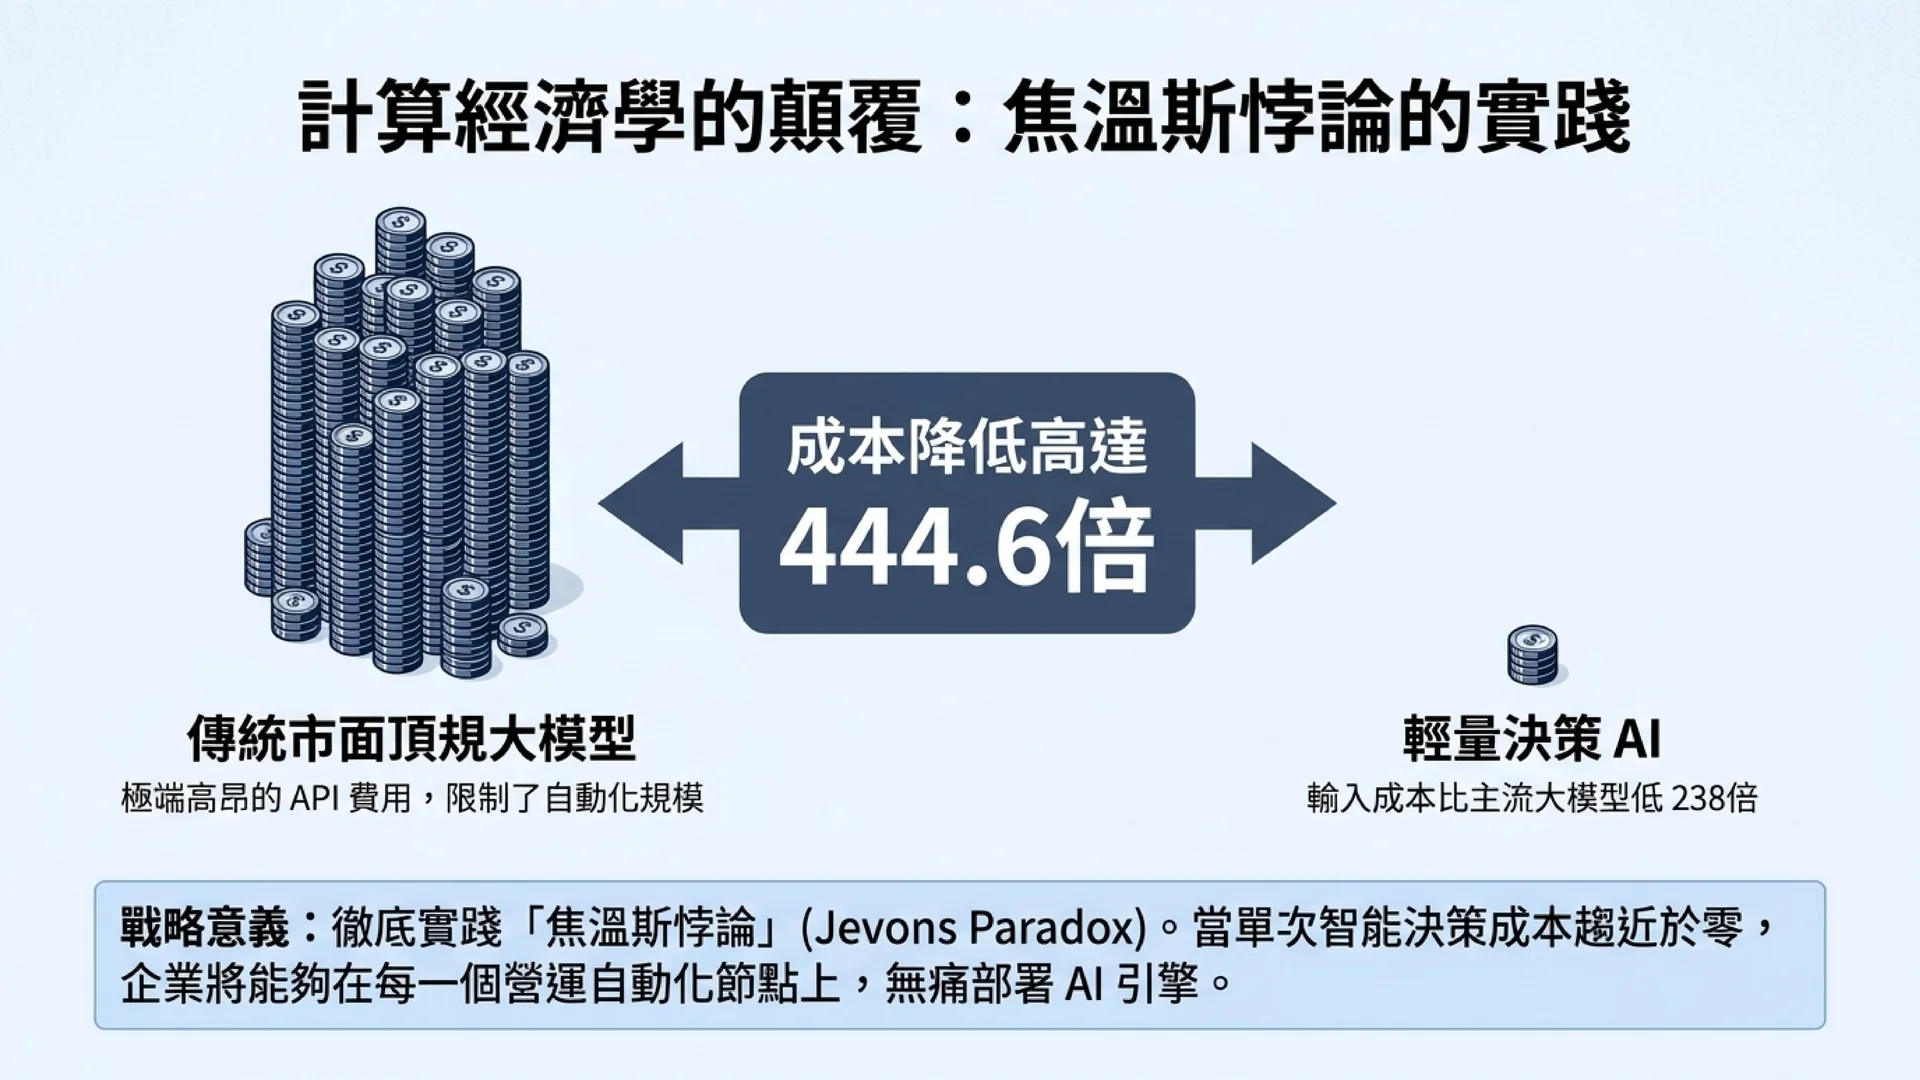
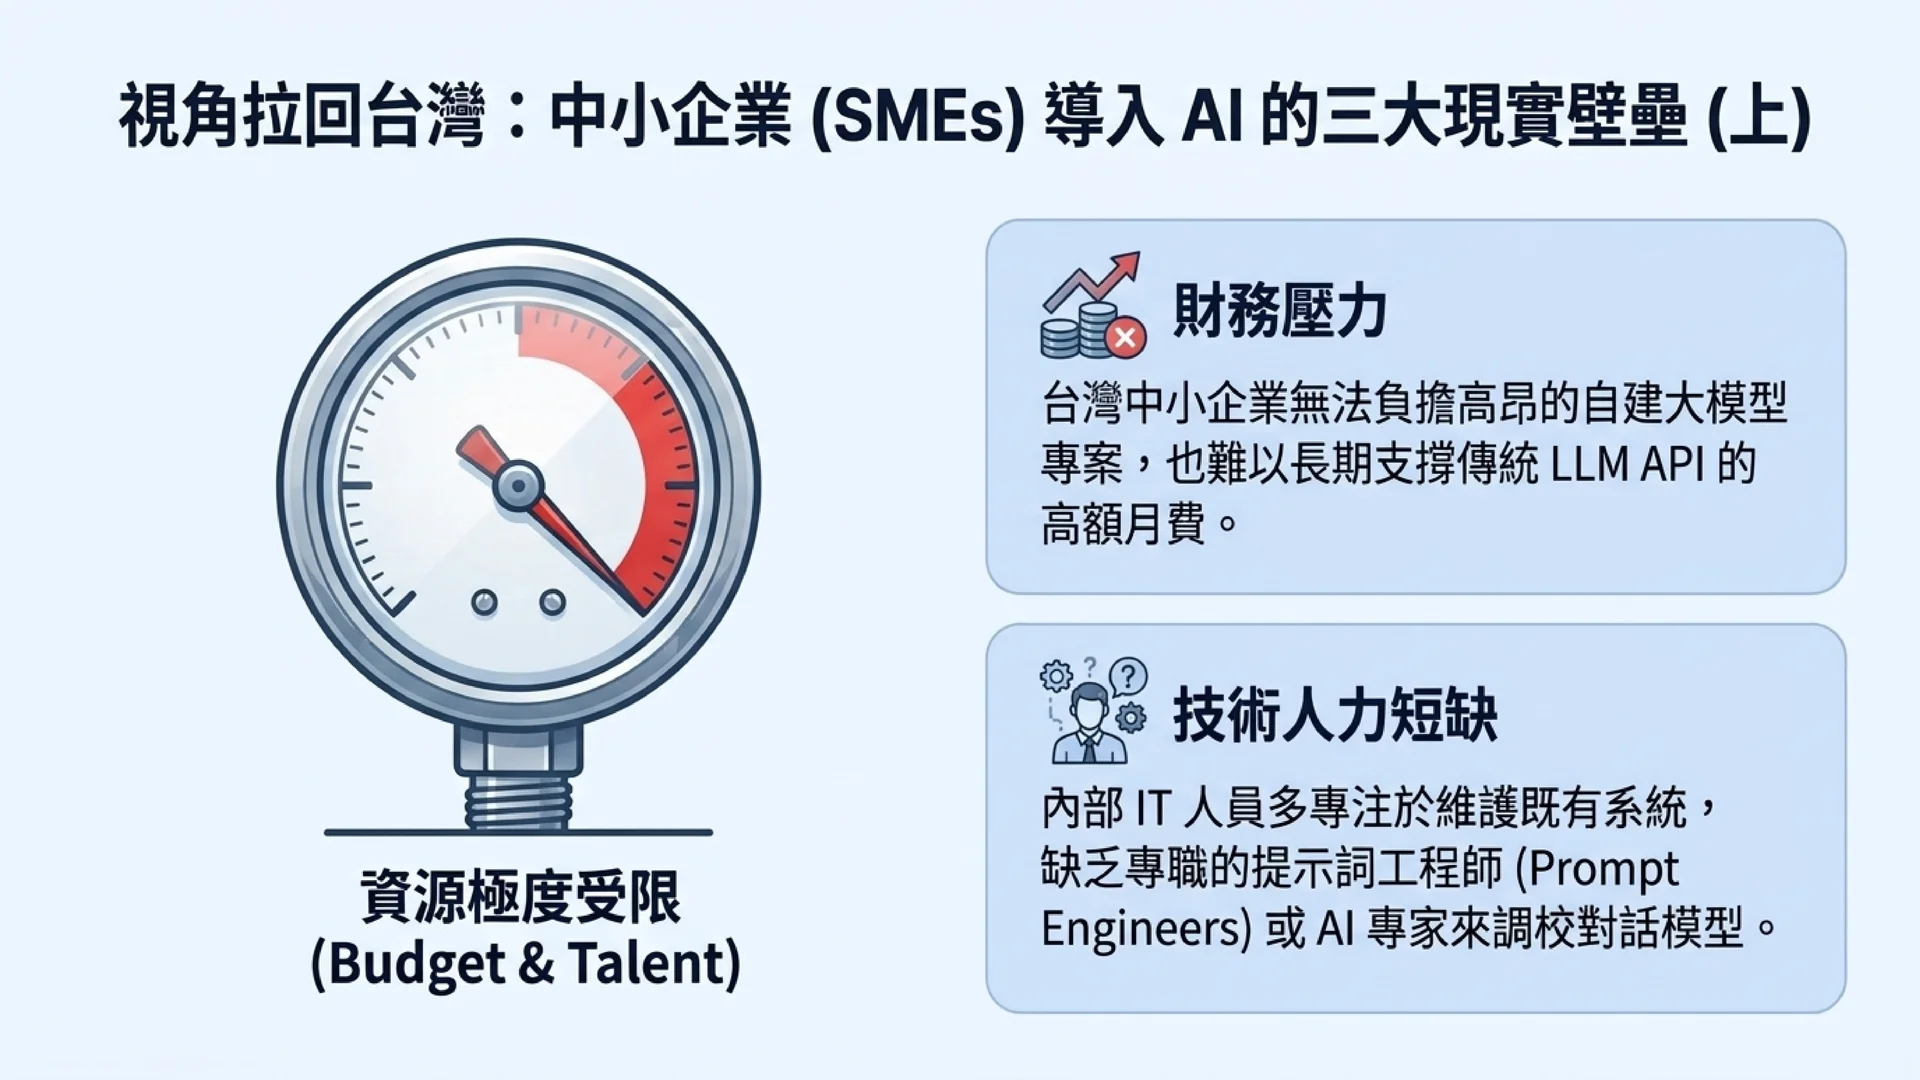
對中小企業來說,真正重要的是 Token 經濟學
站在中小企業資訊人員的角度,我最關心的其實不是 Benchmark 第一名到底是誰。
我更在意的是:
公司一個月到底要花多少錢?
剛開始導入 AI 時,API 費用可能看起來沒什麼。
一天幾十次、一百次呼叫,成本通常不是大問題。
可是當公司真的開始把 AI 接進工作流程,情況就完全不同。
假設未來有客服 Agent、Coding Agent、文件 Agent、業務 Agent、內部知識庫 Agent。
每一個 Agent 在真正執行工作之前,又需要做好幾次判斷。
「這份文件屬於哪一類?」
「這個要求有沒有風險?」
「下一步應該使用哪個 Tool?」
「這段 Context 還有沒有價值?」
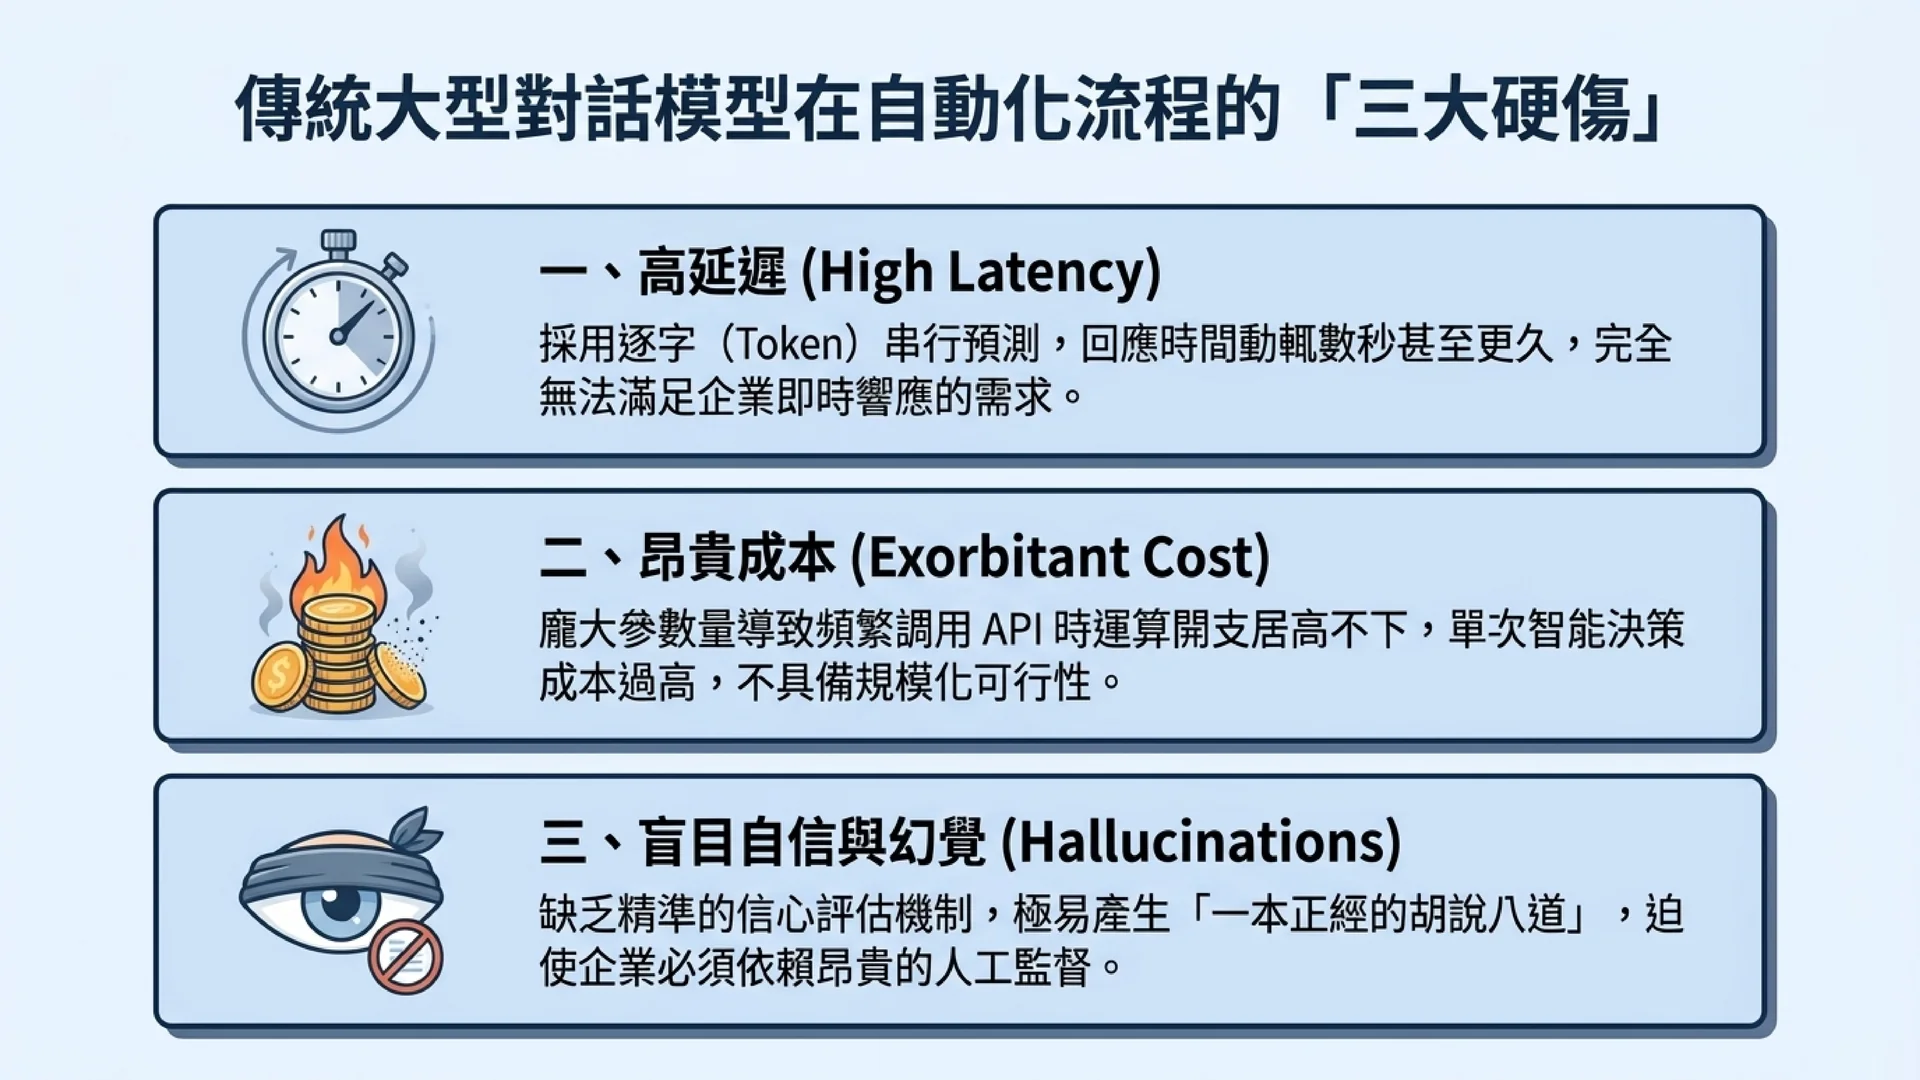
如果每一個小判斷都呼叫一次大型語言模型,一個工作背後可能就不是一次 API Call,而是十次、二十次甚至更多。
這時候企業真正要看的,就不只是單次 API 到底幾美分。
而是整條 Workflow 跑一萬次、一百萬次之後的總成本。
這也是為什麼我覺得 Jev 這種模型值得注意。
它不一定要取代大型模型。
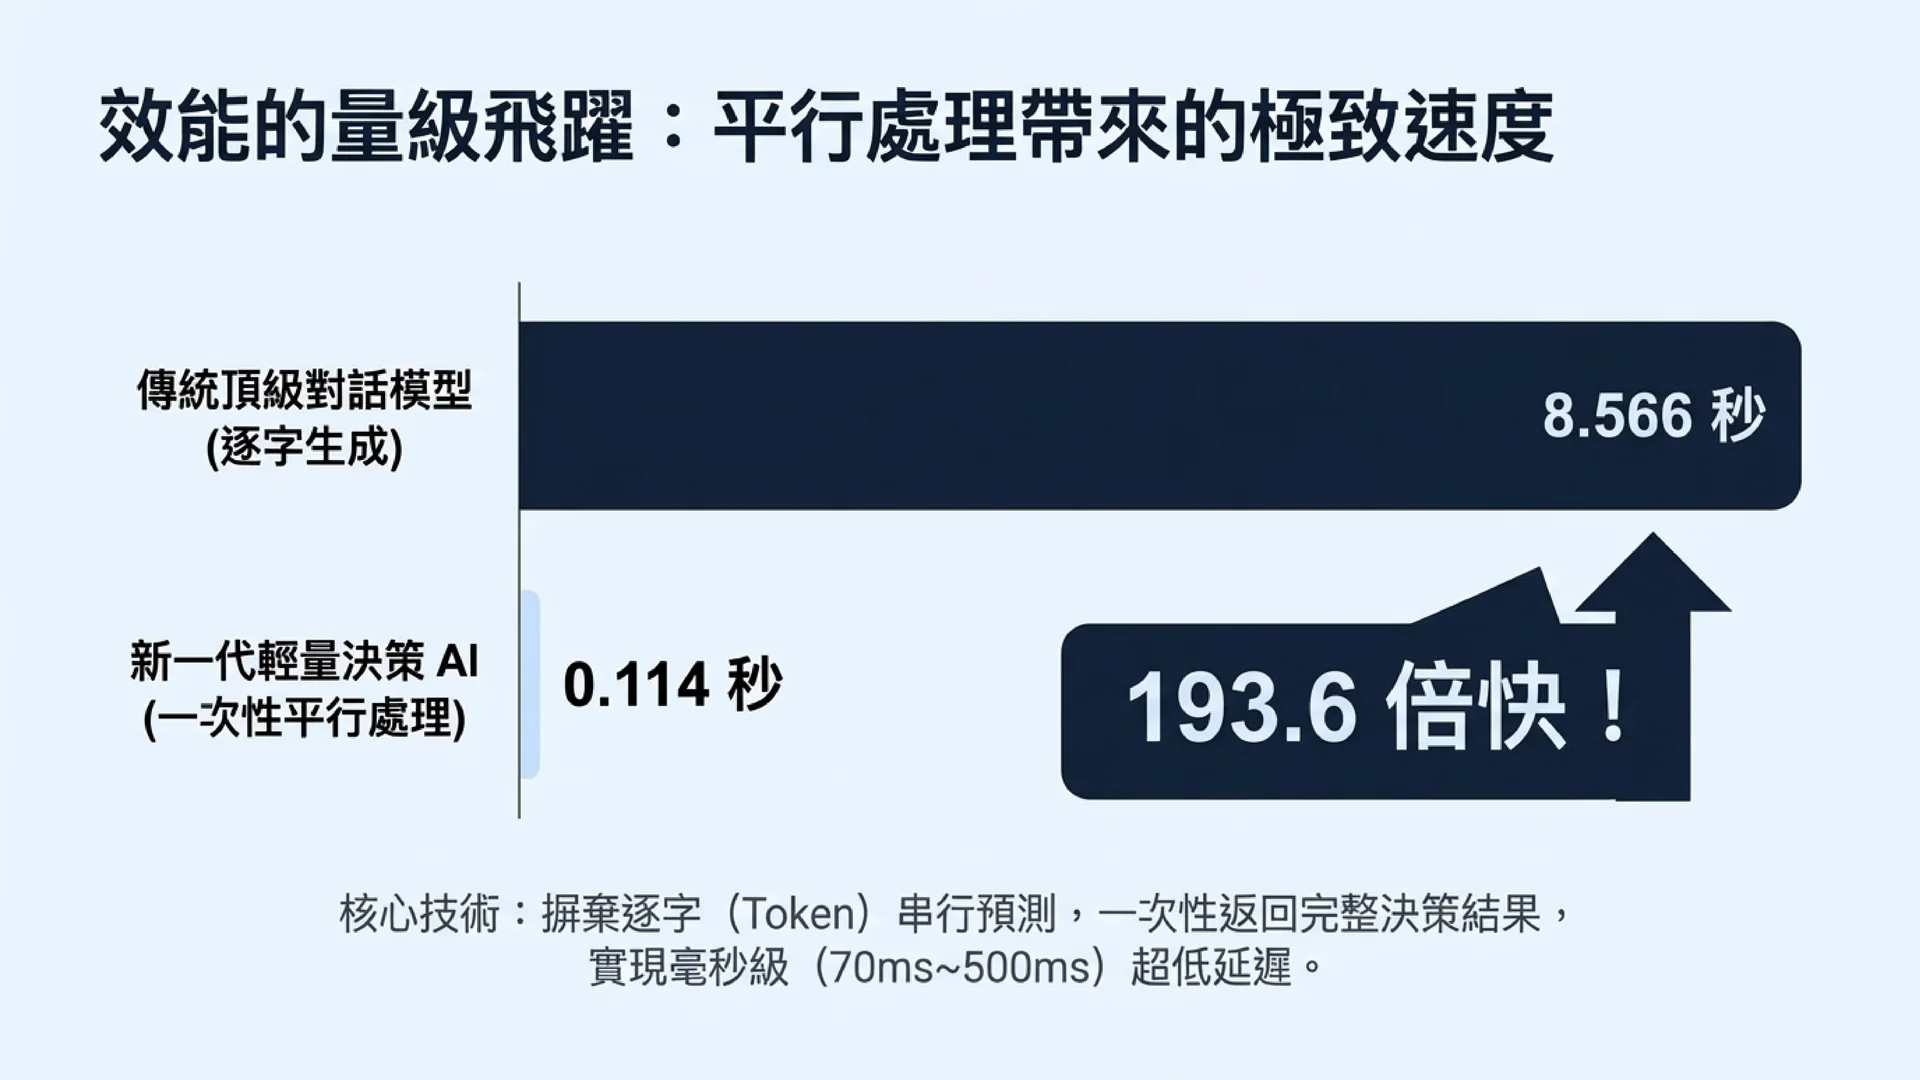
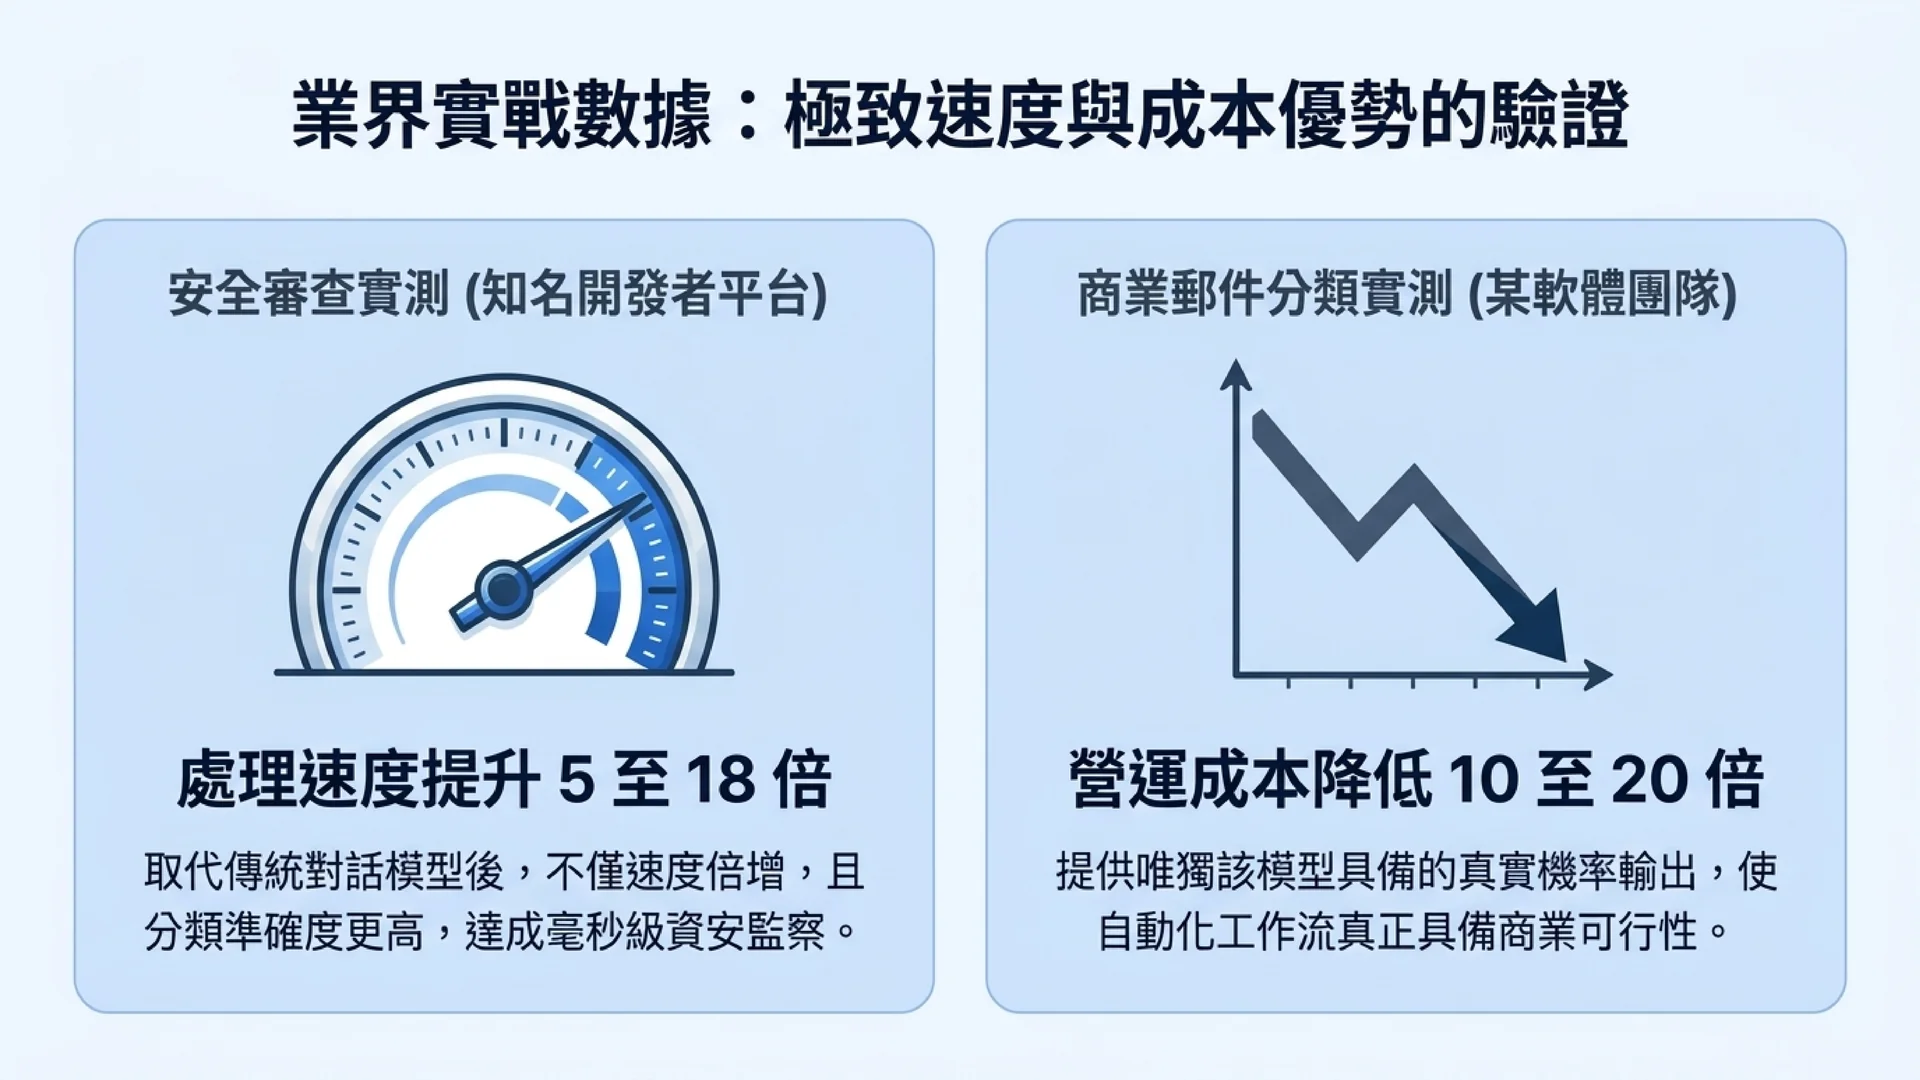
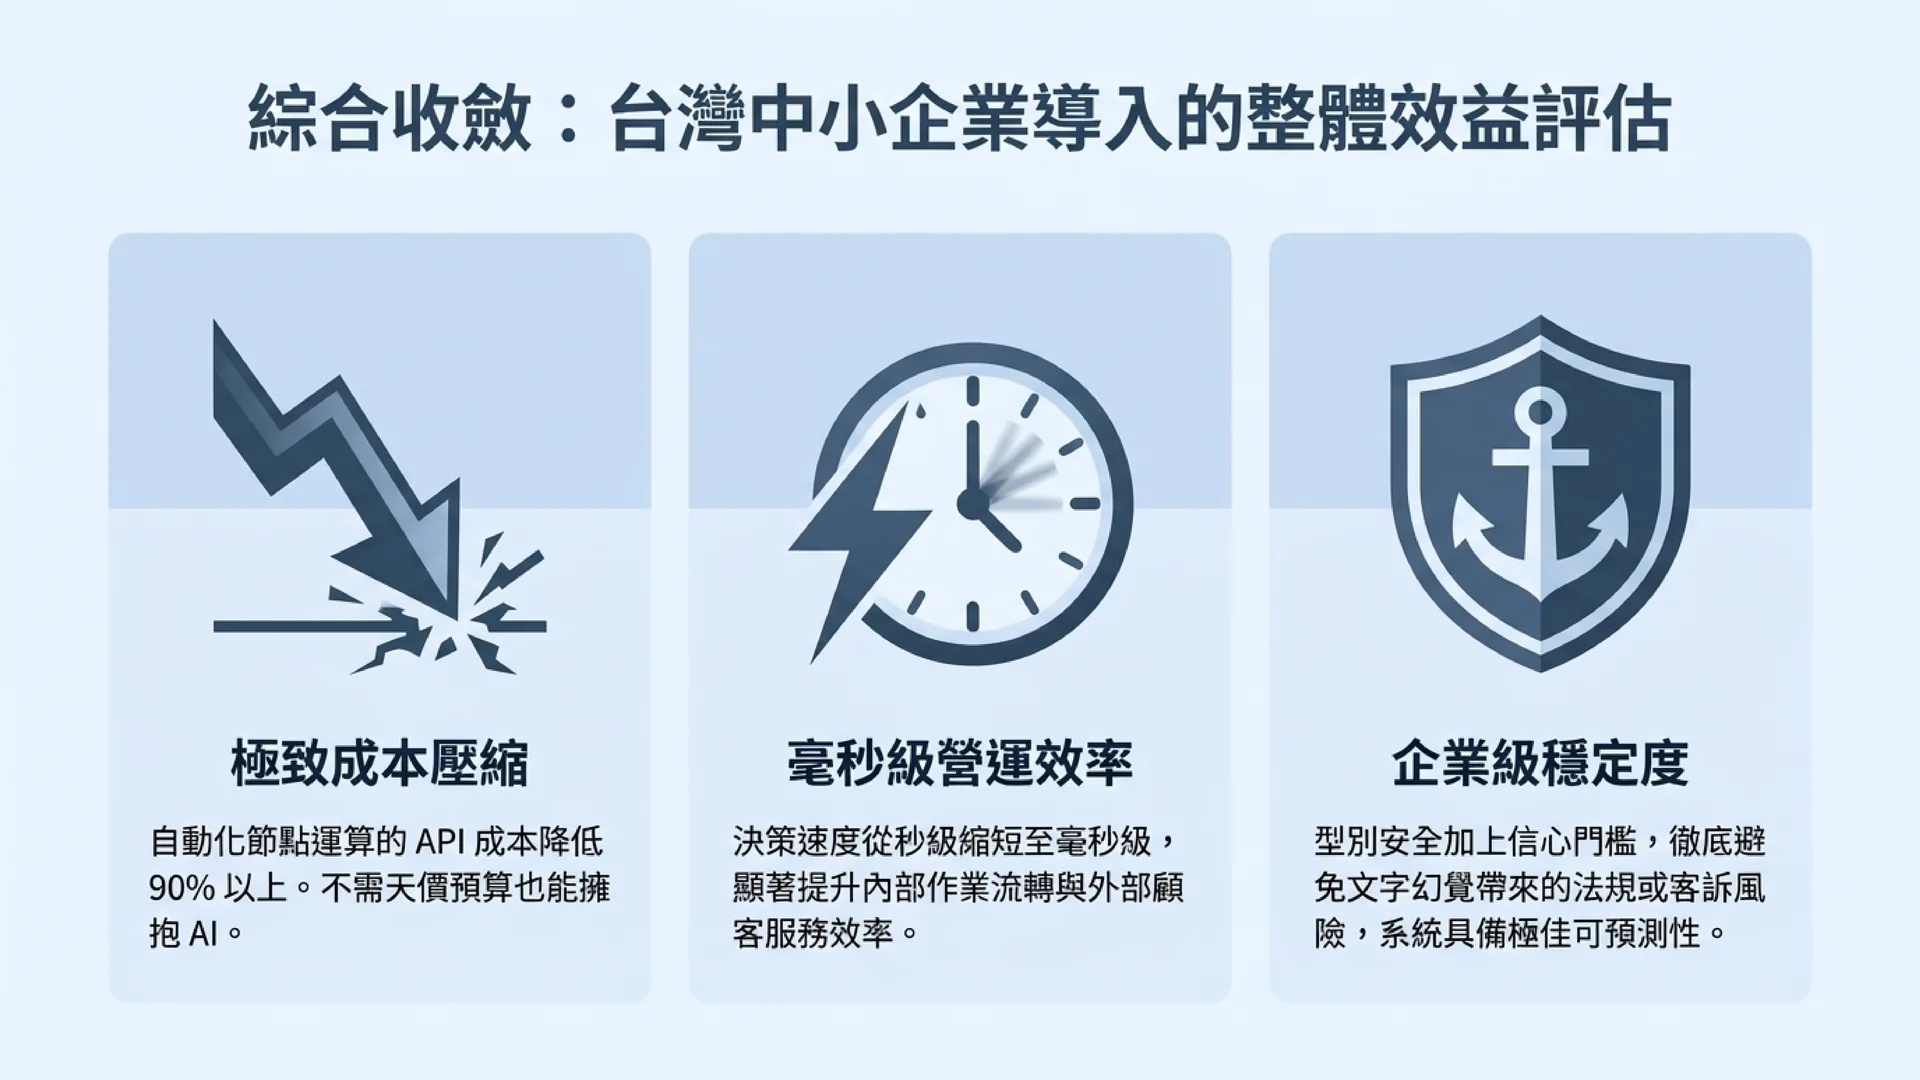
只要能把其中大量簡單判斷工作接走,整套 AI 系統的成本結構就可能開始改變。
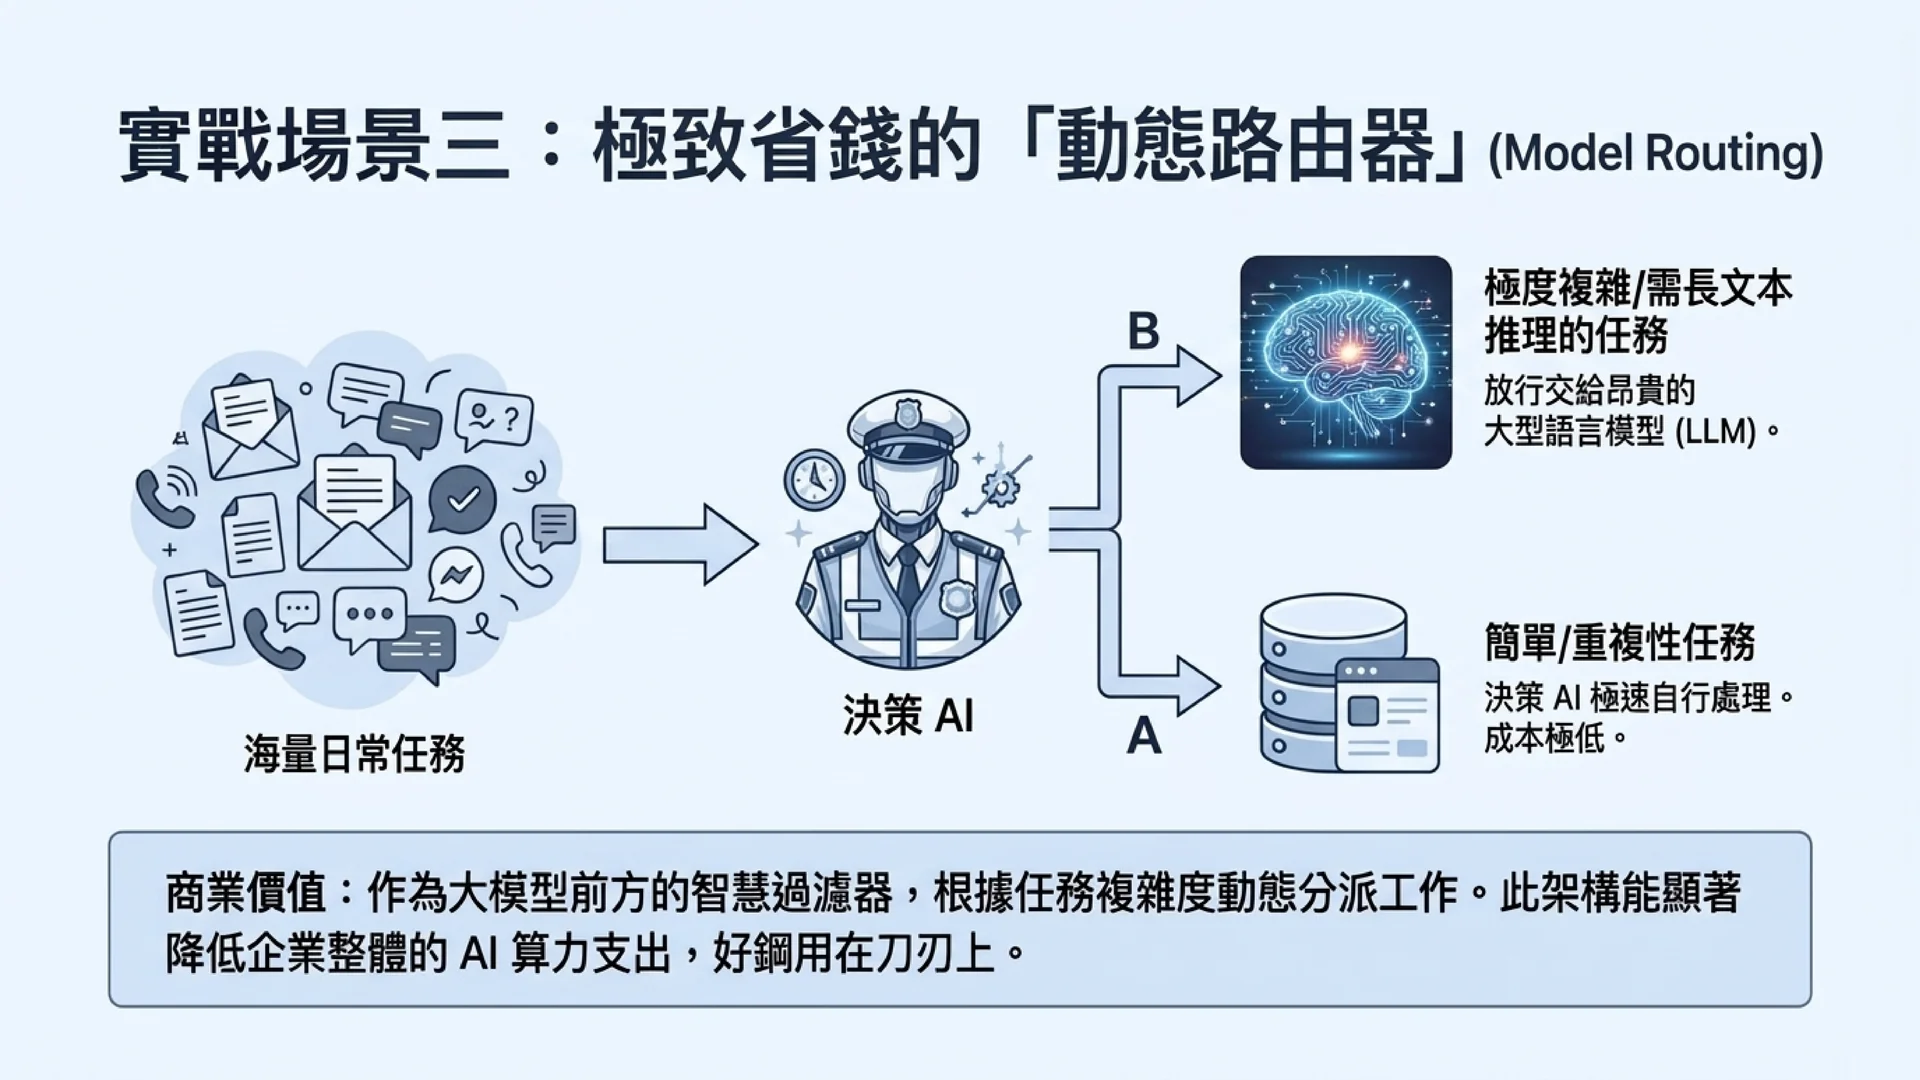
未來的 AI Agent,可能真的需要「交通警察」
我會把 Jev 想像成 AI 世界裡的交通警察。
交通警察自己不需要開救護車,也不用開消防車。
他的工作是看到狀況之後快速決定:
你往這邊。
你走那邊。
這件事情交給誰。
這件事情現在能不能做。
未來企業 AI 系統也可能採用類似架構。
使用者提出需求後,不一定第一時間就直接丟給最昂貴、最大的模型。
而是先經過一層快速判斷。
簡單問題,直接處理。
分類問題,交給專門模型。
需要搜尋資料,就送給 Search Agent。
需要寫程式,再交給 Coding Agent。
真的碰到複雜推理與內容生成,才讓大型語言模型出場。
這時候大型模型反而更像公司的資深工程師。
你不會叫一個月薪十幾萬元的資深工程師,每天花時間幫大家判斷 Email 要丟到哪個資料夾。
你會希望他把時間留給真正困難的事情。
AI 其實也是一樣。
但「不會亂回答」不等於「不會答錯」
這也是我認為企業導入時最容易誤會的一點。
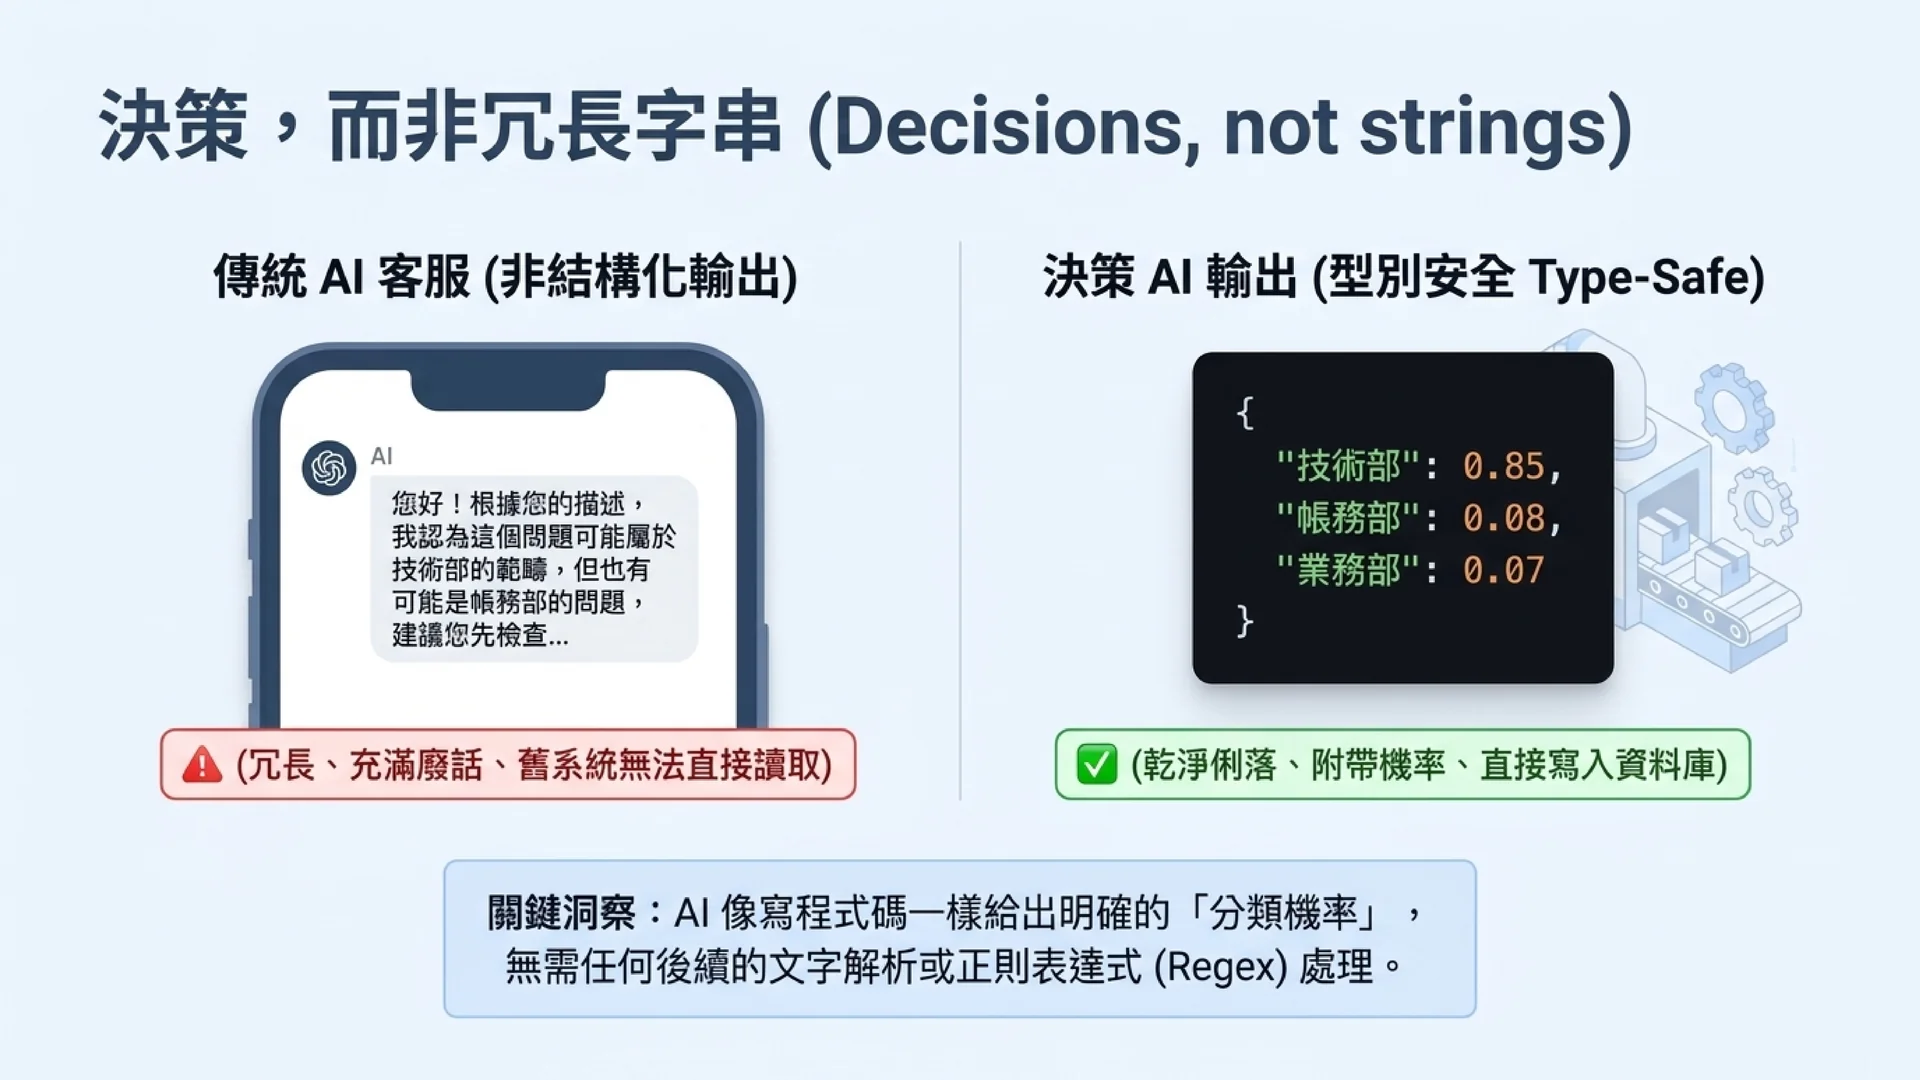
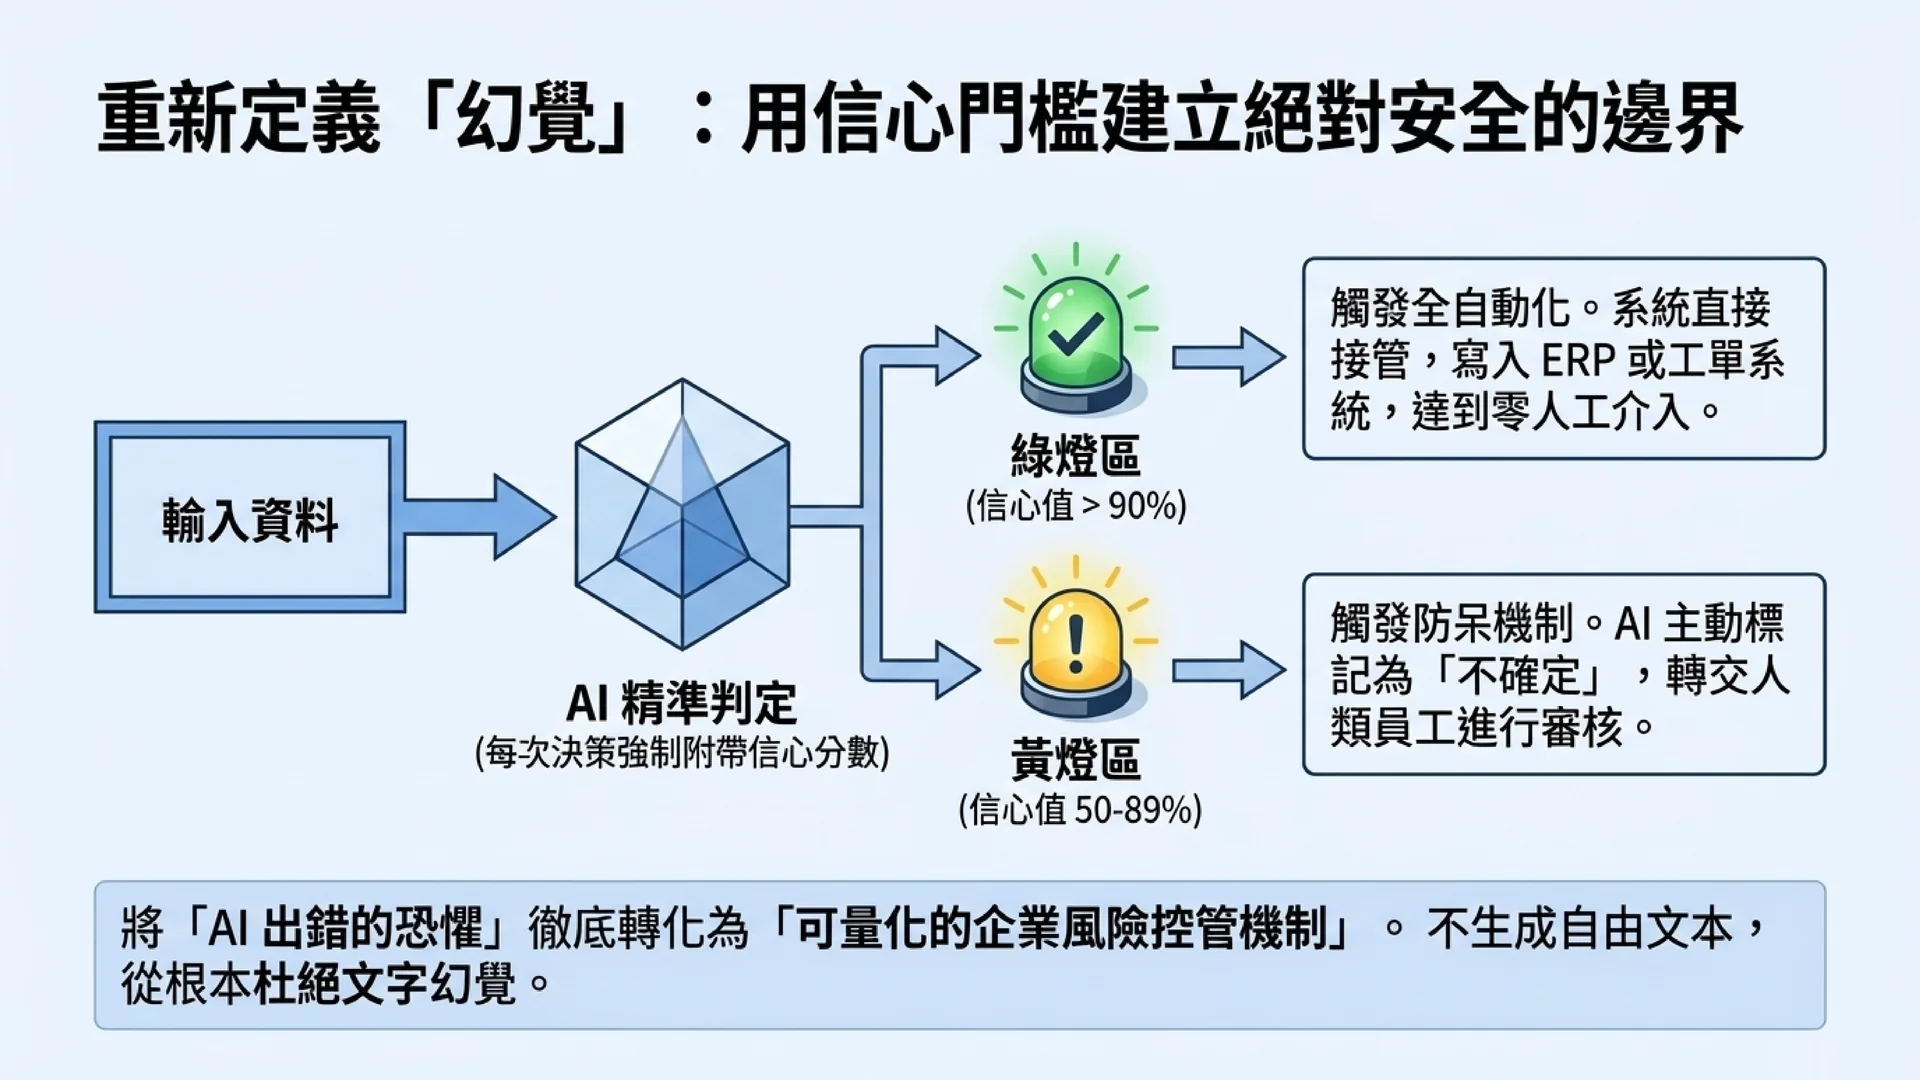
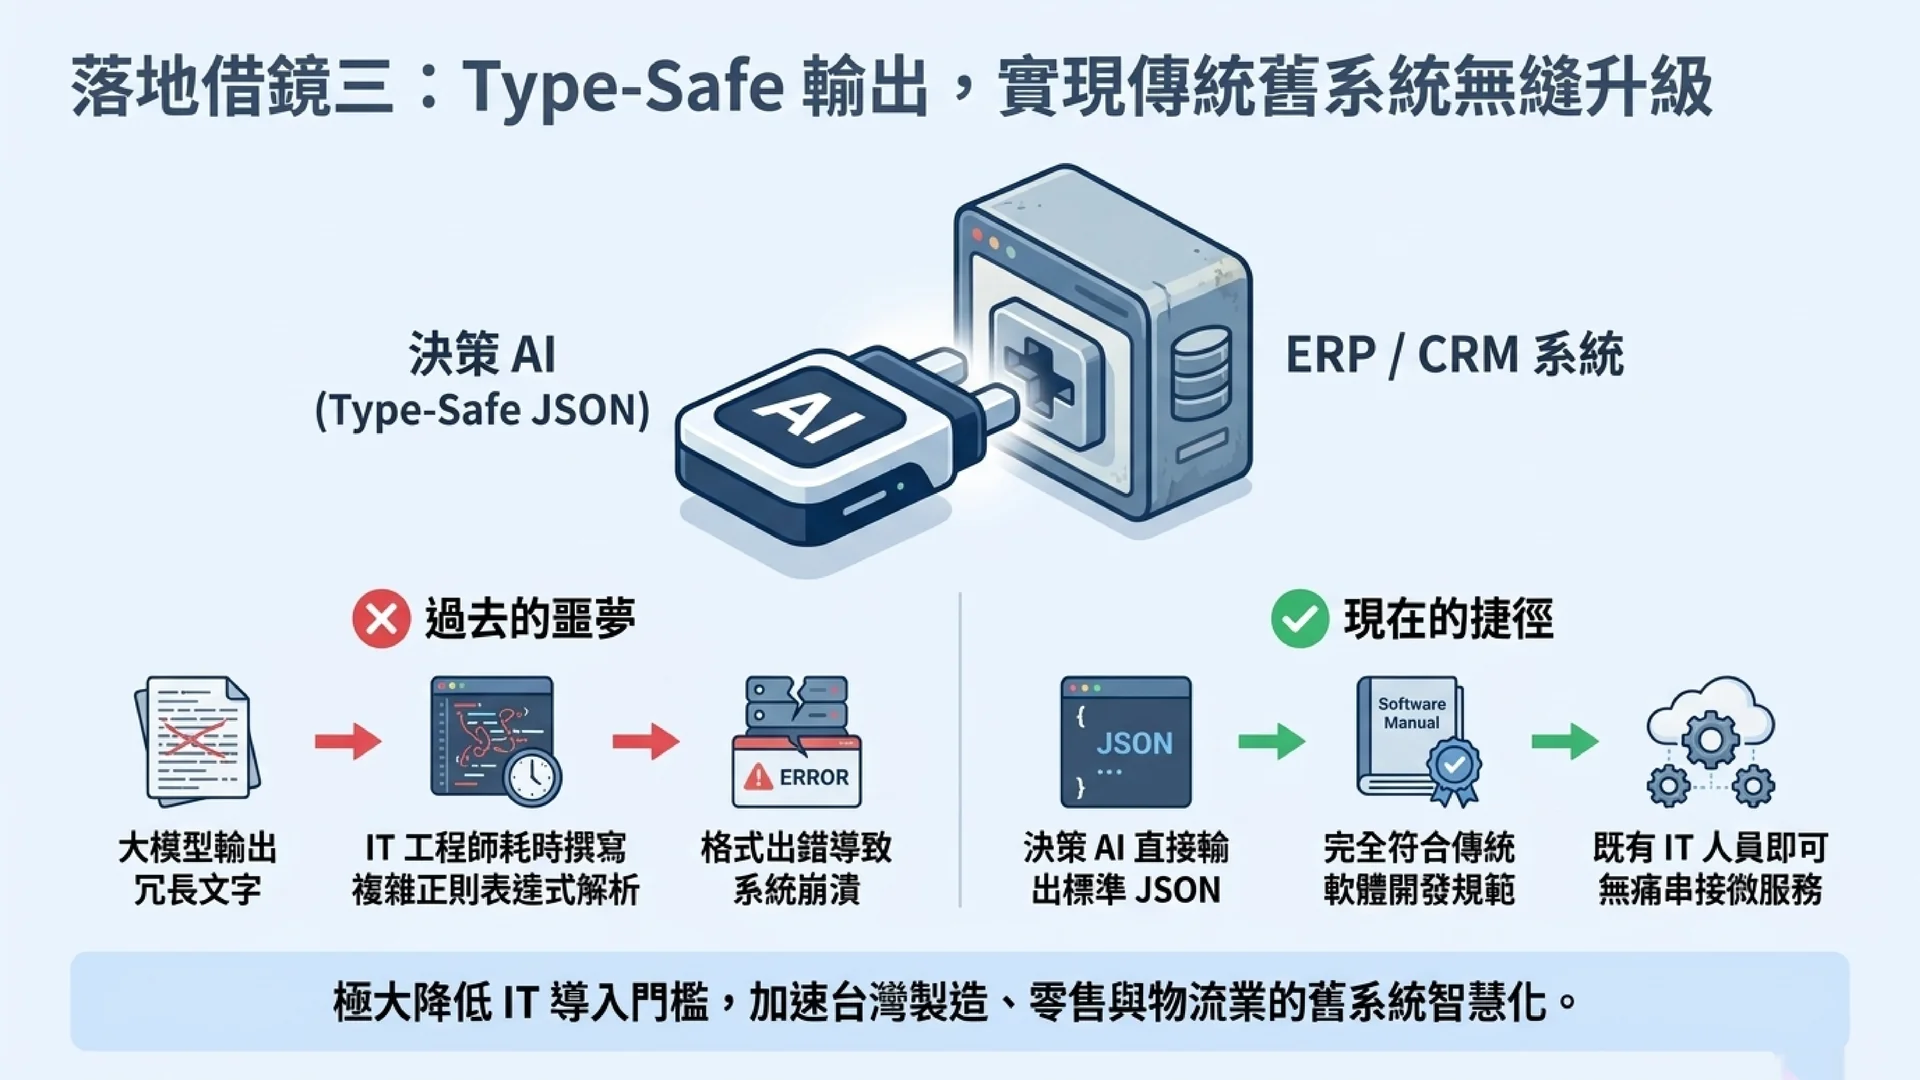
如果系統事先規定答案只能是 A、B、C,Jev 不會突然跑出一個 D。
這對程式整合非常有價值。
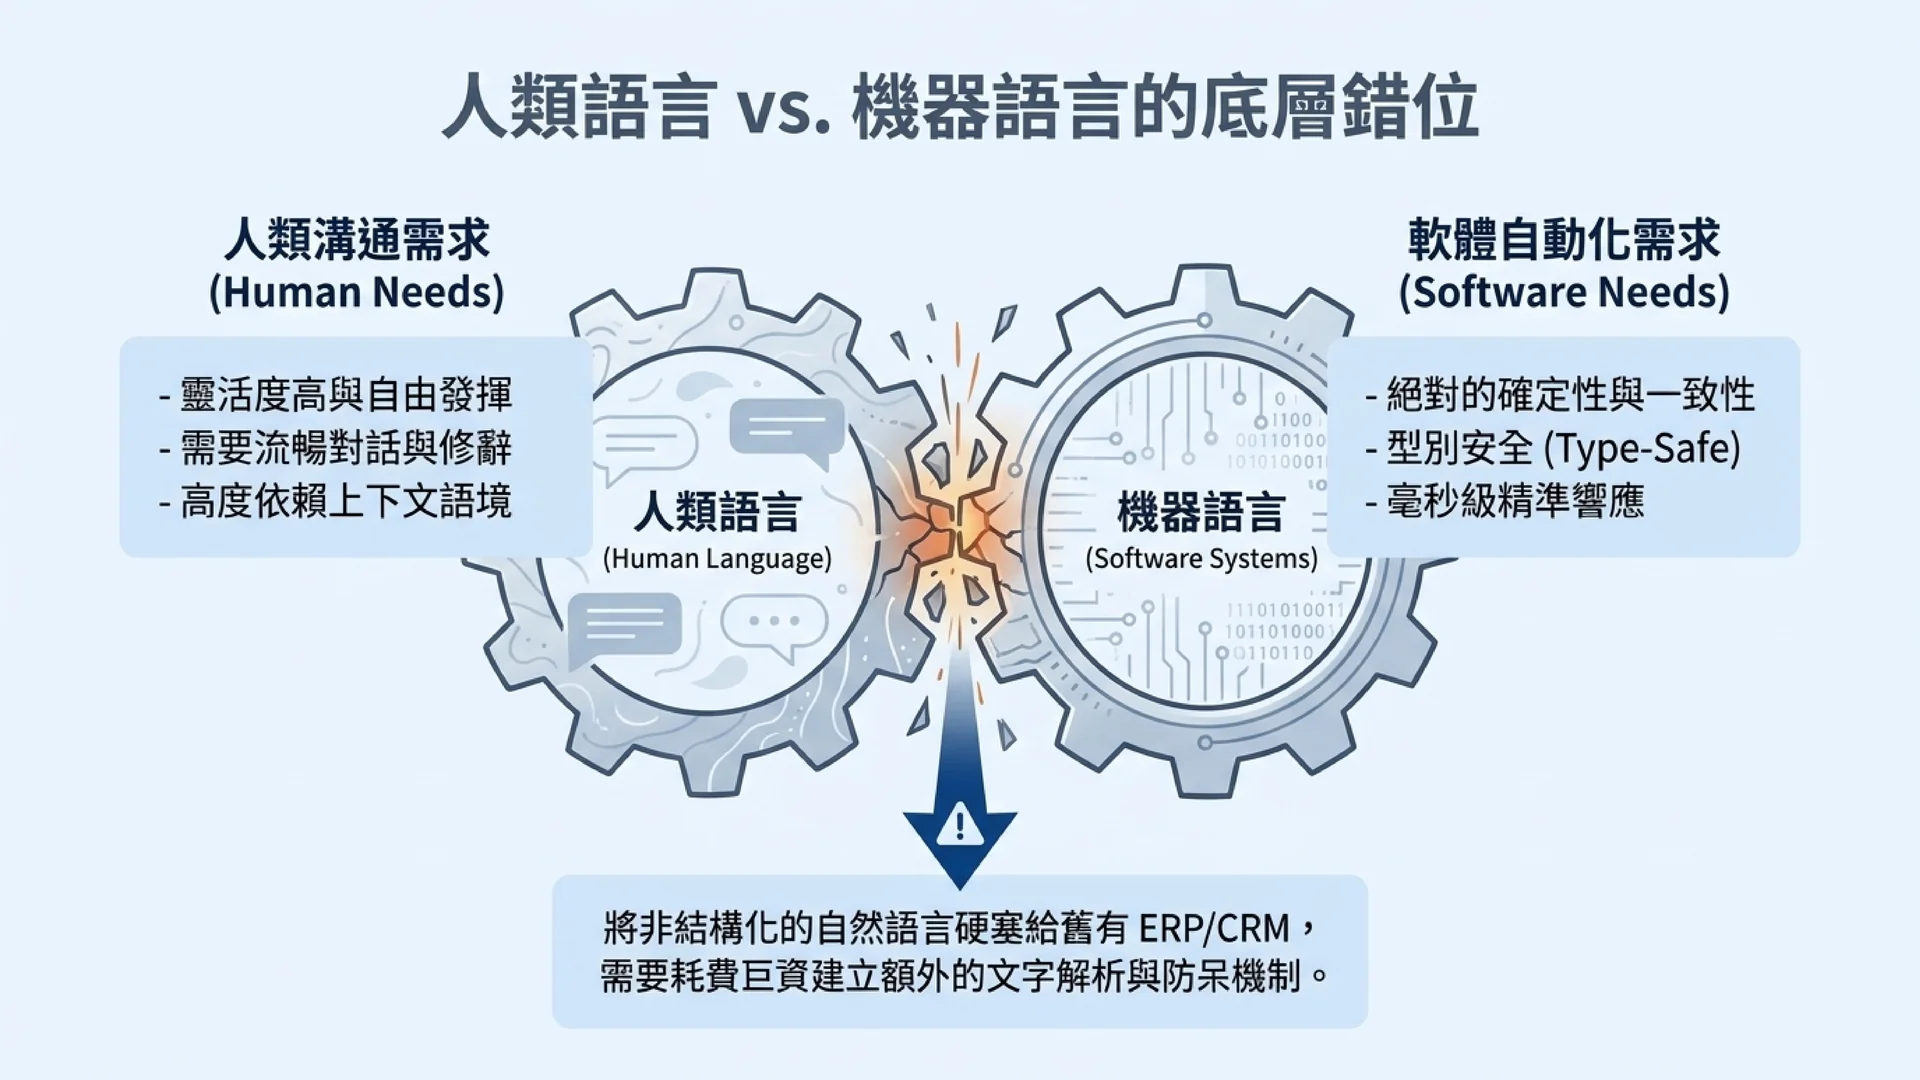
因為後端系統不用一直擔心模型突然多講一句話,或者輸出一個完全不符合 Schema 的內容。
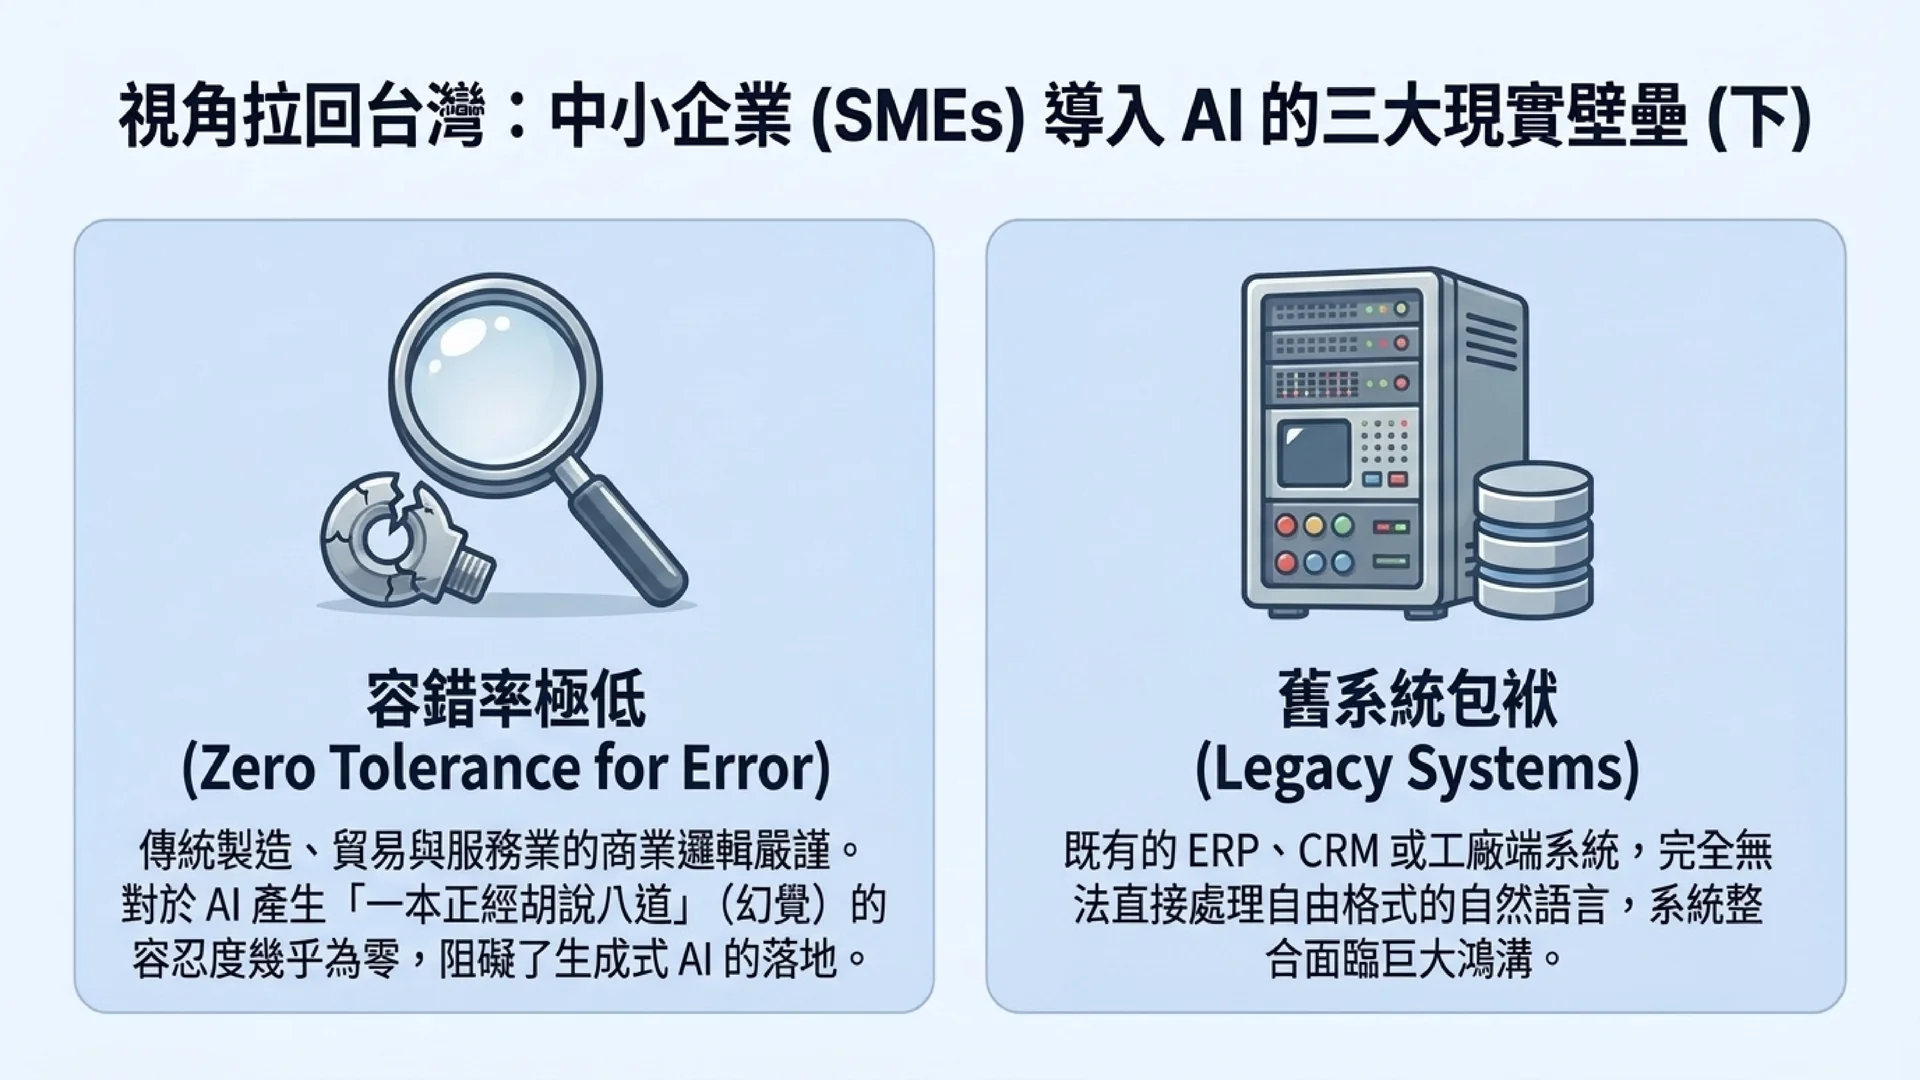
可是這並不代表它一定選對。
格式正確與判斷正確,是兩件完全不同的事情。
例如公司規定:
A 是安全。
B 是需要人工確認。
C 是禁止執行。
模型確實只會從 A、B、C 裡面選擇。
但它仍然可能把原本應該是 C 的危險操作判成 A。
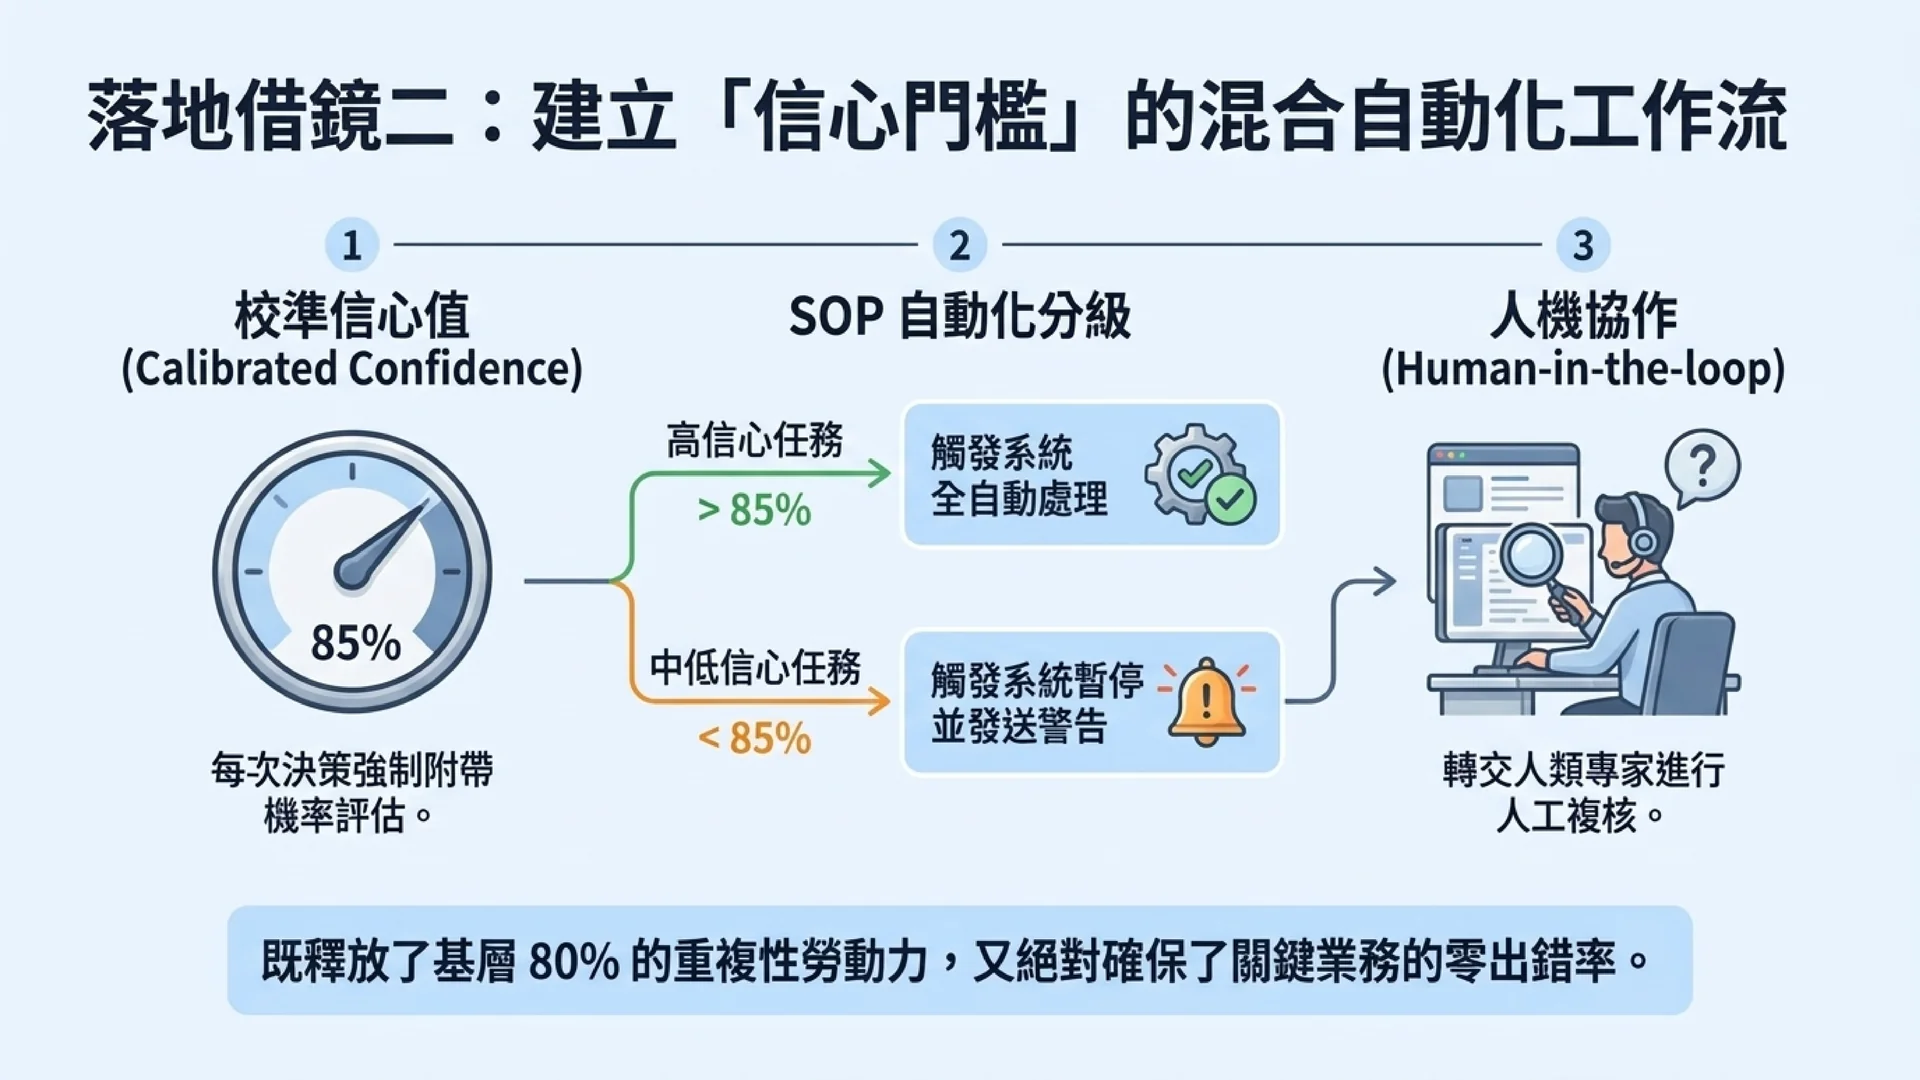
所以如果是資安、金融、權限管理或其他高風險工作,我不會因為模型只能輸出固定答案,就直接把人工審核全部拿掉。
企業真正需要的,仍然是風險分級、權限控制、Log、人工確認與例外處理。
我更期待的不是更大的模型,而是更好的分工
這幾年 AI 產業很容易讓人產生一種錯覺:
模型參數越大越好。
Context 越長越好。
推理能力越強越好。
但站在每天真的要維護系統的資訊人員角度,我現在反而越來越在意另外一件事情:
這個工作到底需不需要這麼大的模型?
有些事情需要 GPT、Claude、Gemini 這種大型模型。
有些事情可能交給小模型。
有些事情甚至根本不需要生成式 AI,用傳統規則就能解決。
而現在 Jev 又提供另外一種思考方式:
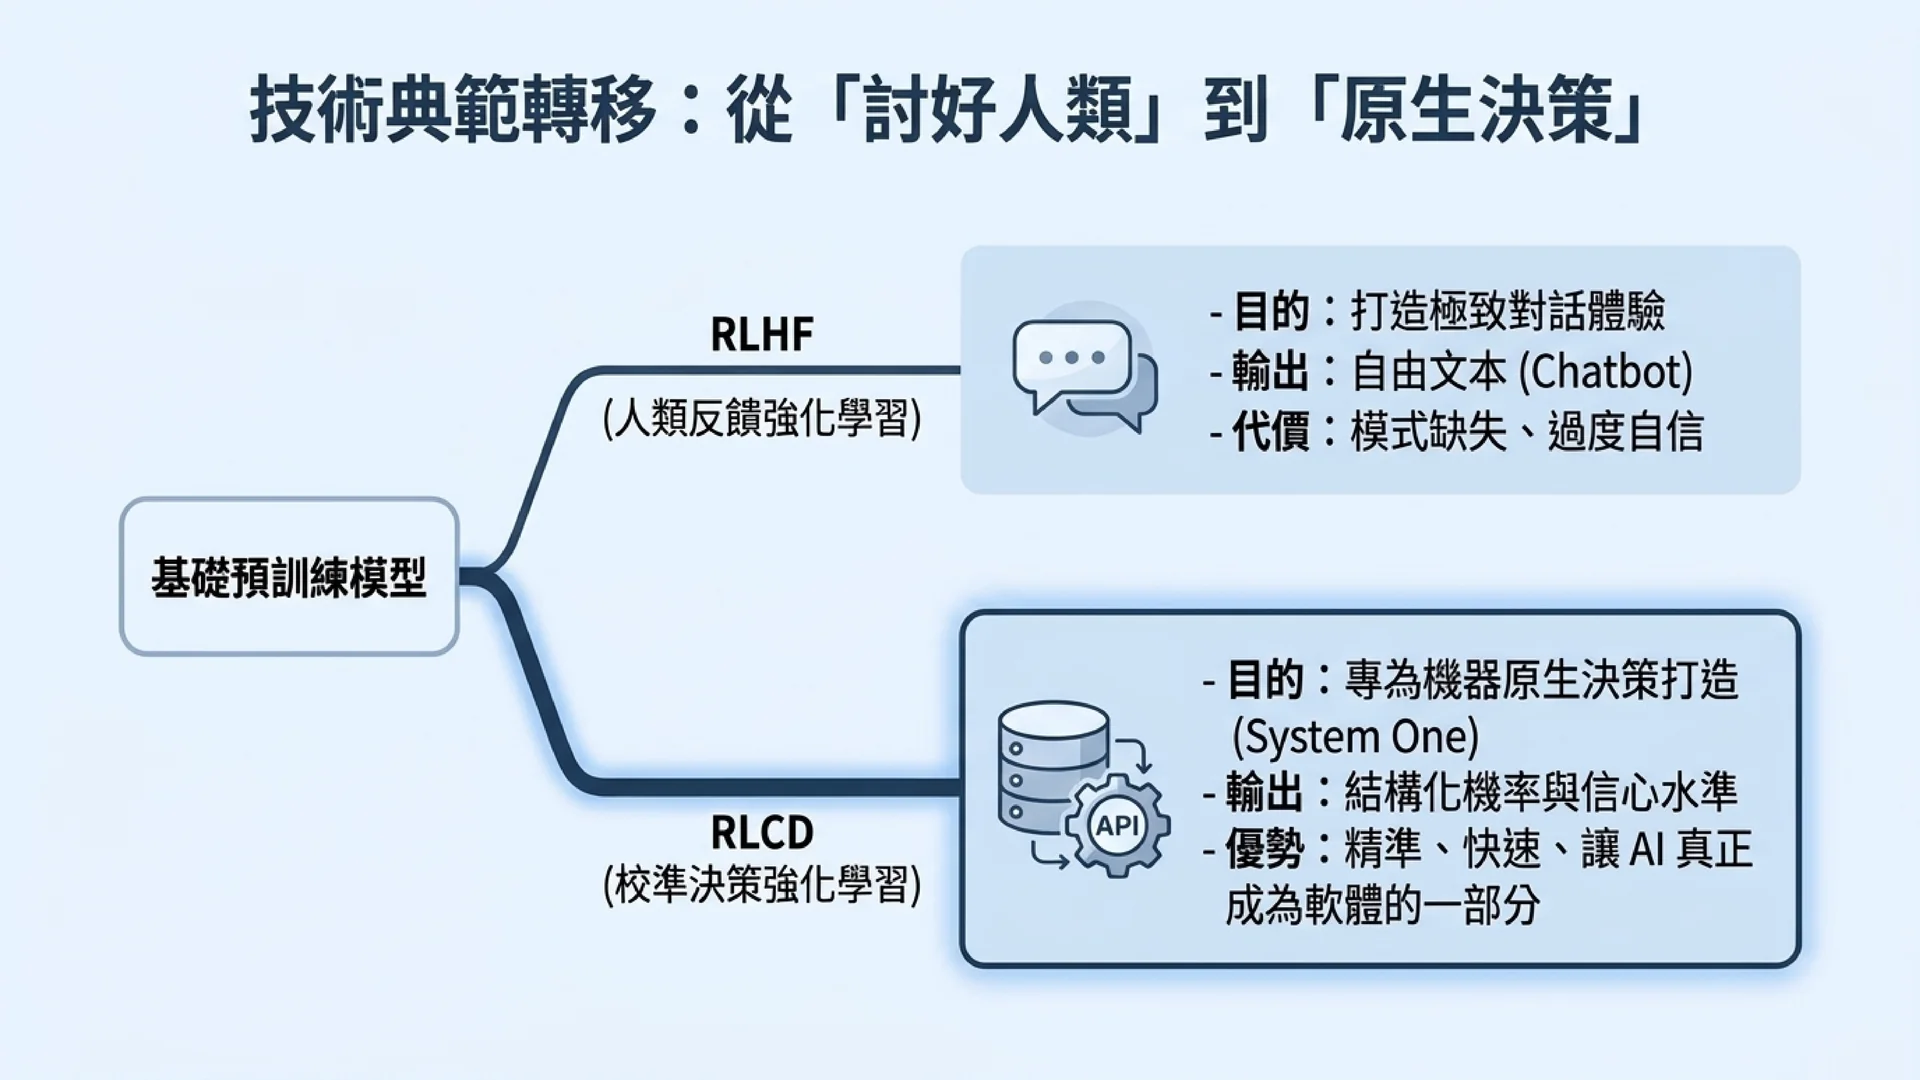
有一類工作,我們需要的不是「生成」,而只是「決策」。
如果未來能把這些工作拆開,AI 系統可能不只是更快、更便宜,也會變得更容易控制。
中小企業真正該建立的是 AI 團隊,而不是迷信單一模型
如果今天老闆問我:「公司是不是應該全部改用 Jev?」
我的答案反而會是:不應該這樣想。
因為 Jev 的價值不是取代 ChatGPT。
就像公司的櫃台不會取代工程師,工程師也不會取代會計。
每個角色處理自己最適合的工作,整家公司才有效率。
未來的企業 AI 也可能一樣。
大型語言模型負責複雜推理與生成。
小型模型負責特定任務。
Jev 這類模型負責大量快速決策。
傳統程式負責明確規則。
人類則負責高風險決策、例外狀況與最終責任。
當這些角色真正串起來之後,我們得到的才不是「一個很厲害的聊天機器人」,而是一支真正能工作的 AI 團隊。
對我這種在中小企業資訊部門工作的人來說,這可能才是 Jev 最值得關注的地方。
下一階段 AI 的競爭,未必只是看誰能做出更大的模型。
而是看誰能把不同能力、不同成本、不同速度的 AI,放到最適合的位置。
簡單工作交給便宜又快速的模型,困難工作才叫大型 AI 出場。
當企業開始這樣思考 AI 架構時,我們才真正從「什麼都丟給 ChatGPT」,走向下一個階段。
因為真正成熟的 AI 系統,不是每一件事情都派最強的人去做。
而是知道——
什麼事情,該交給誰。