DeepSeek 自建搜尋引擎,AI Agent 的權力正在重新分配!當 OpenCode、Codex 都會搜尋,誰才是真正的指揮官?

DeepSeek 自建搜尋引擎,AI Agent 的權力正在重新分配!當 OpenCode、Codex 都會搜尋,誰才是真正的指揮官?

DeepSeek 正式開放自研搜尋引擎的 Search API 與 Fetch API,代表 AI 競爭正從模型能力延伸至搜尋與工具基礎設施。當 OpenCode、Codex 搭配 DeepSeek LLM 時,究竟由誰執行搜尋?關鍵在於 Harness 的工具調度與設定,而非模型本身。若同時啟用不同搜尋路徑,甚至可能產生重複搜尋與額外成本。從企業 AI 技術主管的角度,未來應建立統一的 Search Gateway,集中管理搜尋服務、API 成本、權限與執行紀錄。AI 下一場競爭,不只是誰的模型最聰明,而是誰能掌握工具調度權,建立高效率、可監控且不受單一平台綁定的 AI Agent 架構!

Continue Reading DeepSeek 自建搜尋引擎,AI Agent 的權力正在重新分配!當 OpenCode、Codex 都會搜尋,誰才是真正的指揮官?
一台 Mac,開始有資格成為公司的 AI 伺服器了:從 Splash 看中小企業地端 AI 的下一步
一台 Mac,開始有資格成為公司的 AI 伺服器了:從 Splash 看中小企業地端 AI 的下一步​

一台 Mac,開始有資格成為公司的 AI 伺服器了:從 Splash 看中小企業地端 AI 的下一步

Inco AI 推出的 Splash,正在改變中小企業部署地端 AI 的想像。它不是追求支援大量模型的通用推論引擎,而是針對特定模型打造專屬核心、記憶體配置與推論最佳化。目前 Qwen3.8-27B 已能在 Apple Silicon 上展現高速推論與多人併發能力,讓一台大記憶體 Mac 有機會從個人 AI 實驗機,進一步成為企業內部 AI Server。除了文字生成與 Coding,也能支援 RAG、文件分析、圖片理解與 Agent Tool Calling。對中小企業而言,真正值得注意的不是單純每秒多少 Token,而是能否讓 2~4 位員工共同使用、降低部署維護成本,同時讓重要資料留在公司內部。Splash 顯示了一個新方向:未來企業導入 Local AI,可能真的只需要一台開機就能生產的 Mac。

Continue Reading 一台 Mac,開始有資格成為公司的 AI 伺服器了:從 Splash 看中小企業地端 AI 的下一步
短片:Grok 4.7別只看Token單價🔥
Grok 4.7別只看Token單價🔥

短片:Grok 4.7別只看Token單價🔥

Grok 4.7 最值得注意的,不只是模型能力變強,而是 AI 的「單價」與「實際使用成本」可能完全是兩回事。表面上,每百萬輸出 Token 的價格可以低至 6 美元,看起來相當便宜,但真正影響帳單的關鍵,是完成一項任務究竟需要消耗多少 Token。 如果 Grok 4.7 為了完成相同工作,比上一代消耗更多 Token,即使每百萬 Token 單價下降,最終任務成本仍可能增加。部分測試甚至顯示,單一任務平均可能消耗約 8.1 萬 Token。因此企業評估 AI 模型時,不能只比較官方 Token 報價,更應觀察「每項任務總成本」。模型跑得快不快、能力強不強固然重要,但真正決定荷包的,是完成工作到底花了多少錢。

Continue Reading 短片:Grok 4.7別只看Token單價🔥
短片:AI 邊看邊聽影片!🔥
短片:AI 邊看邊聽影片!🔥​

短片:AI 邊看邊聽影片!🔥

Qwen3.8-Omni-Flash 是阿里巴巴推出的原生全模態 AI 模型,最大特色是能同時理解影片的「畫面+聲音」。直接丟入一支有聲影片,AI 就能一邊看畫面、一邊聽對白,進行跨模態分析。 它具備 100 萬 Token 超長上下文,適合長影片理解、逐字稿、摘要、章節整理、關鍵字標籤及精彩片段搜尋。相較傳統只靠聲音辨識的字幕流程,AI 還能利用畫面協助判斷人物、產品名稱、簡報與專有名詞。 未來影片 AI 不只是自動上字幕,而是把影片丟進去,AI 幫你看完、聽完、理解完,再把一支影片轉化成更多可用內容。

Continue Reading 短片:AI 邊看邊聽影片!🔥
短片:台積追聯發?🔥
台積追聯發?🔥

短片:台積追聯發?🔥

台積電董事長暨總裁魏哲家日前接待退休主管時,當著聯發科副董事長暨執行長蔡力行的面開玩笑表示,希望台積電股價「趕快趕上聯發科」,一句話迅速引發市場熱議。9 月 21 日台積電收在 2,480 元,聯發科則收在 5,010 元,兩者每股價差達 2,530 元,讓部分投資人聯想到台積電是否仍有上漲空間。不過,5,010 元並非魏哲家提出的目標價,兩家公司股本、市值及營運規模也不同,單純比較每股價格並不能直接衡量企業價值。甚至有網友幽默表示,若聯發科跌到 2,480 元,也算是「趕上」。這句話究竟只是場合上的幽默,還是展現魏哲家對台積電未來發展的信心,也成為投資人討論焦點。

Continue Reading 短片:台積追聯發?🔥
短片:AI 沒單就去挖礦 🔥
AI 沒單就去挖礦 🔥​

短片:AI 沒單就去挖礦 🔥

企業導入 AI,真的每件工作都需要出動 ChatGPT、Claude、Gemini 這類大型模型嗎?TypeSafe AI 推出的 Jev 提供另一種思路:它不負責聊天或長篇文字生成,而是專注於選擇、評分與 Yes/No 等快速決策。對中小企業而言,垃圾郵件判斷、任務分類、Agent 路由、Context 篩選等工作,如果都交給大型模型,不只速度可能受影響,也會累積大量 Token 與 API 成本。Jev 的價值並非取代大型語言模型,而是成為 AI 系統中的「交通警察」,讓簡單工作快速分流,複雜任務再交給大型 AI。未來企業 AI 的關鍵,可能不再只是追求更強模型,而是建立大型模型、小模型、決策模型與人工審核各司其職的 AI 團隊。

Continue Reading 短片:AI 沒單就去挖礦 🔥

RTX 5090 閒著也是零:AI 工程師怎麼看 Pearl(PRL)挖礦?

Pearl(PRL)挖礦的真正價值,可能不是讓人為了挖幣購買 RTX 5090,而是讓原本就用於 AI 生產的昂貴 GPU,在沒有工作時多一條營收管道。 對 AI 工程師而言,VRAM 與 GPU 算力極為珍貴,MiniMax H3、大型語言模型與 AI 圖像生成甚至需要量化、Offload 才能執行,因此正式 AI 工作永遠應該優先於挖礦。合理模式應是「AI 有工作就生產,GPU 閒置才挖 PRL」。 Pearl 更大的願景則是 Proof of Useful Work,讓 AI 矩陣運算同時產生區塊鏈價值。但 PRL 能否從挖礦經濟真正成長為 AI 算力經濟,關鍵不在幣價,而在於未來有多少不在乎 PRL 的企業,願意付費使用 Pearl 提供的 AI 算力服務。

Continue Reading RTX 5090 閒著也是零:AI 工程師怎麼看 Pearl(PRL)挖礦?
短片:⚡ 你正在拿 ChatGPT 法拉利送外賣?
法拉利送外賣?

短片:⚡ 你正在拿 ChatGPT 法拉利送外賣?

企業導入 AI,真的每件工作都需要出動 ChatGPT、Claude、Gemini 這類大型模型嗎?TypeSafe AI 推出的 Jev 提供另一種思路:它不負責聊天或長篇文字生成,而是專注於選擇、評分與 Yes/No 等快速決策。對中小企業而言,垃圾郵件判斷、任務分類、Agent 路由、Context 篩選等工作,如果都交給大型模型,不只速度可能受影響,也會累積大量 Token 與 API 成本。Jev 的價值並非取代大型語言模型,而是成為 AI 系統中的「交通警察」,讓簡單工作快速分流,複雜任務再交給大型 AI。未來企業 AI 的關鍵,可能不再只是追求更強模型,而是建立大型模型、小模型、決策模型與人工審核各司其職的 AI 團隊。

Continue Reading 短片:⚡ 你正在拿 ChatGPT 法拉利送外賣?
別再拿法拉利送外賣:Jev 出現後,我開始重新思考企業 AI 的分工方式
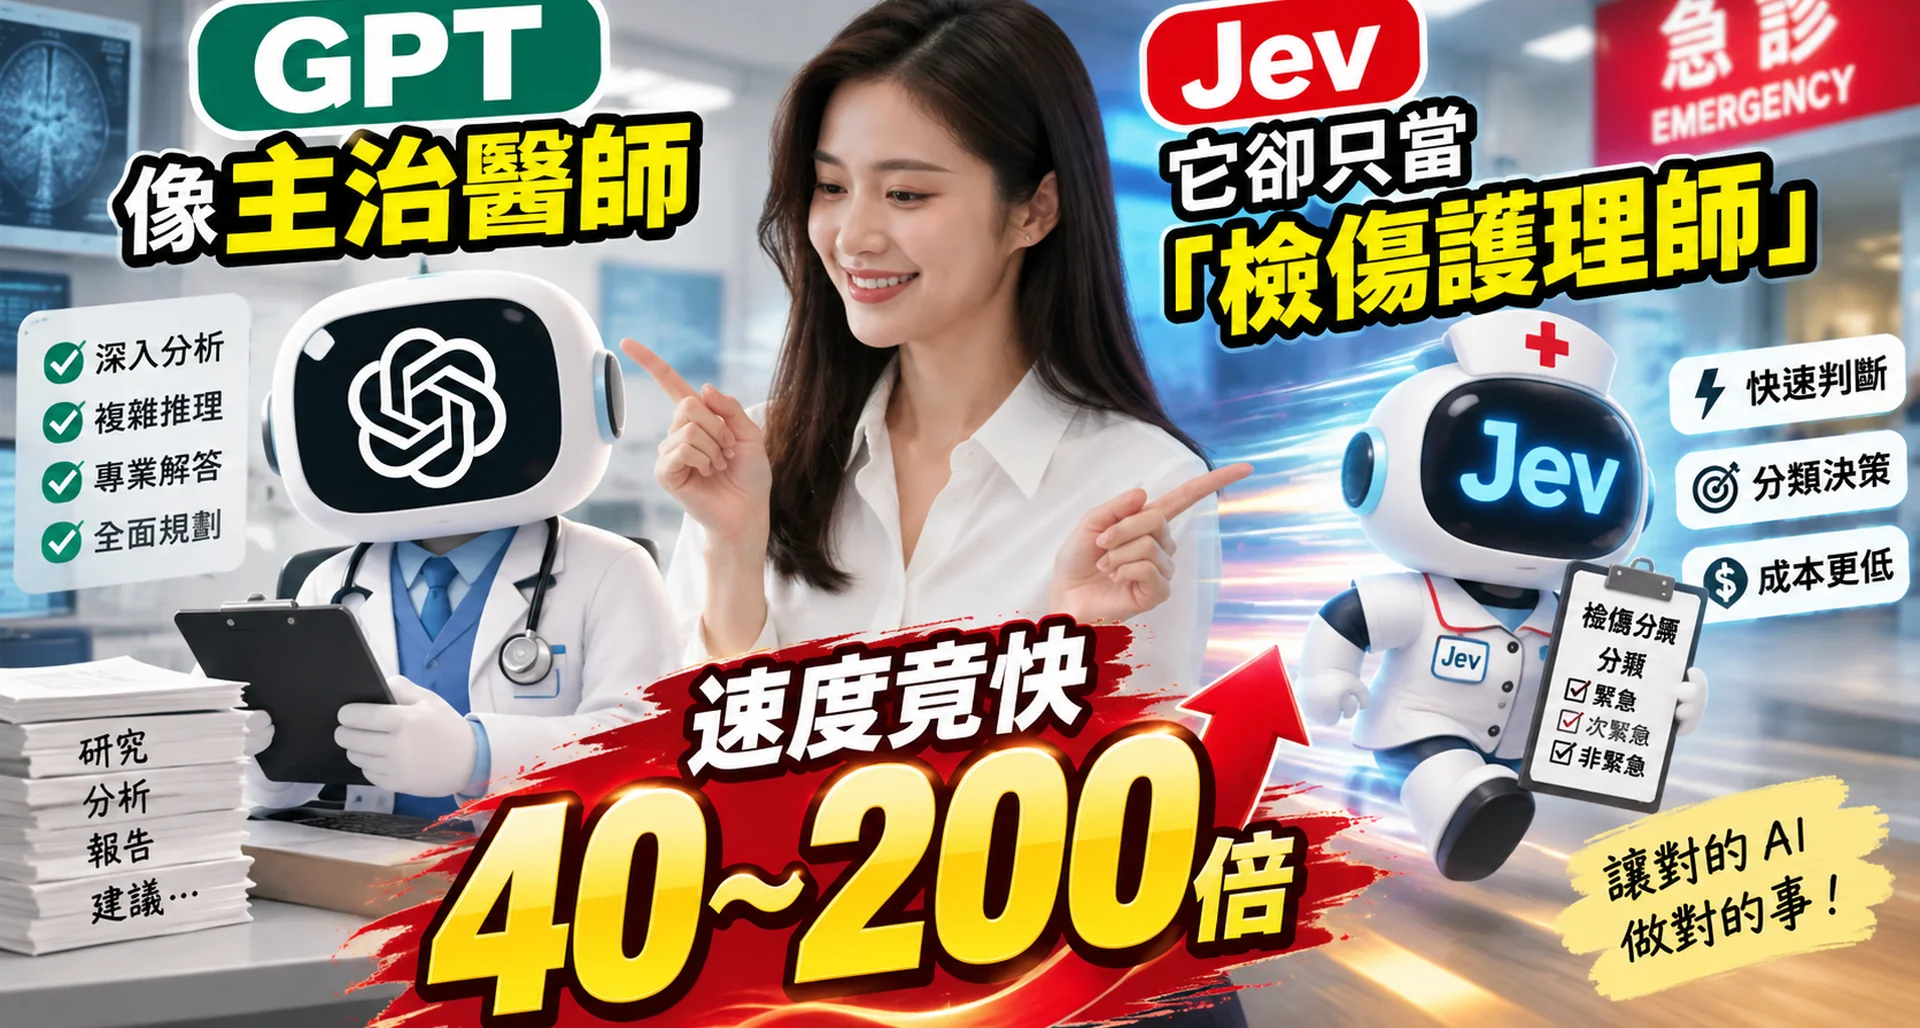
GPT 像主治醫師,Jev 它卻只當「檢傷護理師」🏥 速度竟快 40~200 倍

別再拿法拉利送外賣:Jev 出現後,我開始重新思考企業 AI 的分工方式

企業導入 AI,真的每件工作都需要出動 ChatGPT、Claude、Gemini 這類大型模型嗎?TypeSafe AI 推出的 Jev 提供另一種思路:它不負責聊天或長篇文字生成,而是專注於選擇、評分與 Yes/No 等快速決策。對中小企業而言,垃圾郵件判斷、任務分類、Agent 路由、Context 篩選等工作,如果都交給大型模型,不只速度可能受影響,也會累積大量 Token 與 API 成本。Jev 的價值並非取代大型語言模型,而是成為 AI 系統中的「交通警察」,讓簡單工作快速分流,複雜任務再交給大型 AI。未來企業 AI 的關鍵,可能不再只是追求更強模型,而是建立大型模型、小模型、決策模型與人工審核各司其職的 AI 團隊。

Continue Reading 別再拿法拉利送外賣:Jev 出現後,我開始重新思考企業 AI 的分工方式
短片:🔥 AMD R9700 暴力解鎖!27B 模型狂飆
💥 AMD R9700 暴力解鎖!27B 模型狂飆

短片:🔥 AMD R9700 暴力解鎖!27B 模型狂飆

AMD Radeon R9700 32GB 最近在開源 AI 社群引發熱議,透過軟體與推論框架優化,單卡運行 27B 大模型時,Prefill 可達每秒 3619 Tokens,Decode 更達每秒 153 Tokens。關鍵在於將 NVFP4 即時轉換為 MXFP4,降低資料搬運與記憶體頻寬壓力,讓同一張顯卡發揮更高效能。不過高跑分背後仍有 Prefix Caching、PCIe 頻寬、散熱功耗,以及 ROCm、vLLM、Docker 部署等挑戰。R9700 雖展現高 CP 值潛力,但更像一台需要工程師調校的 AI F1 賽車。

Continue Reading 短片:🔥 AMD R9700 暴力解鎖!27B 模型狂飆

End of content

No more pages to load