一台 Mac,開始有資格成為公司的 AI 伺服器了:從 Splash 看中小企業地端 AI 的下一步
一台 Mac,開始有資格成為公司的 AI 伺服器了:從 Splash 看中小企業地端 AI 的下一步​

一台 Mac,開始有資格成為公司的 AI 伺服器了:從 Splash 看中小企業地端 AI 的下一步

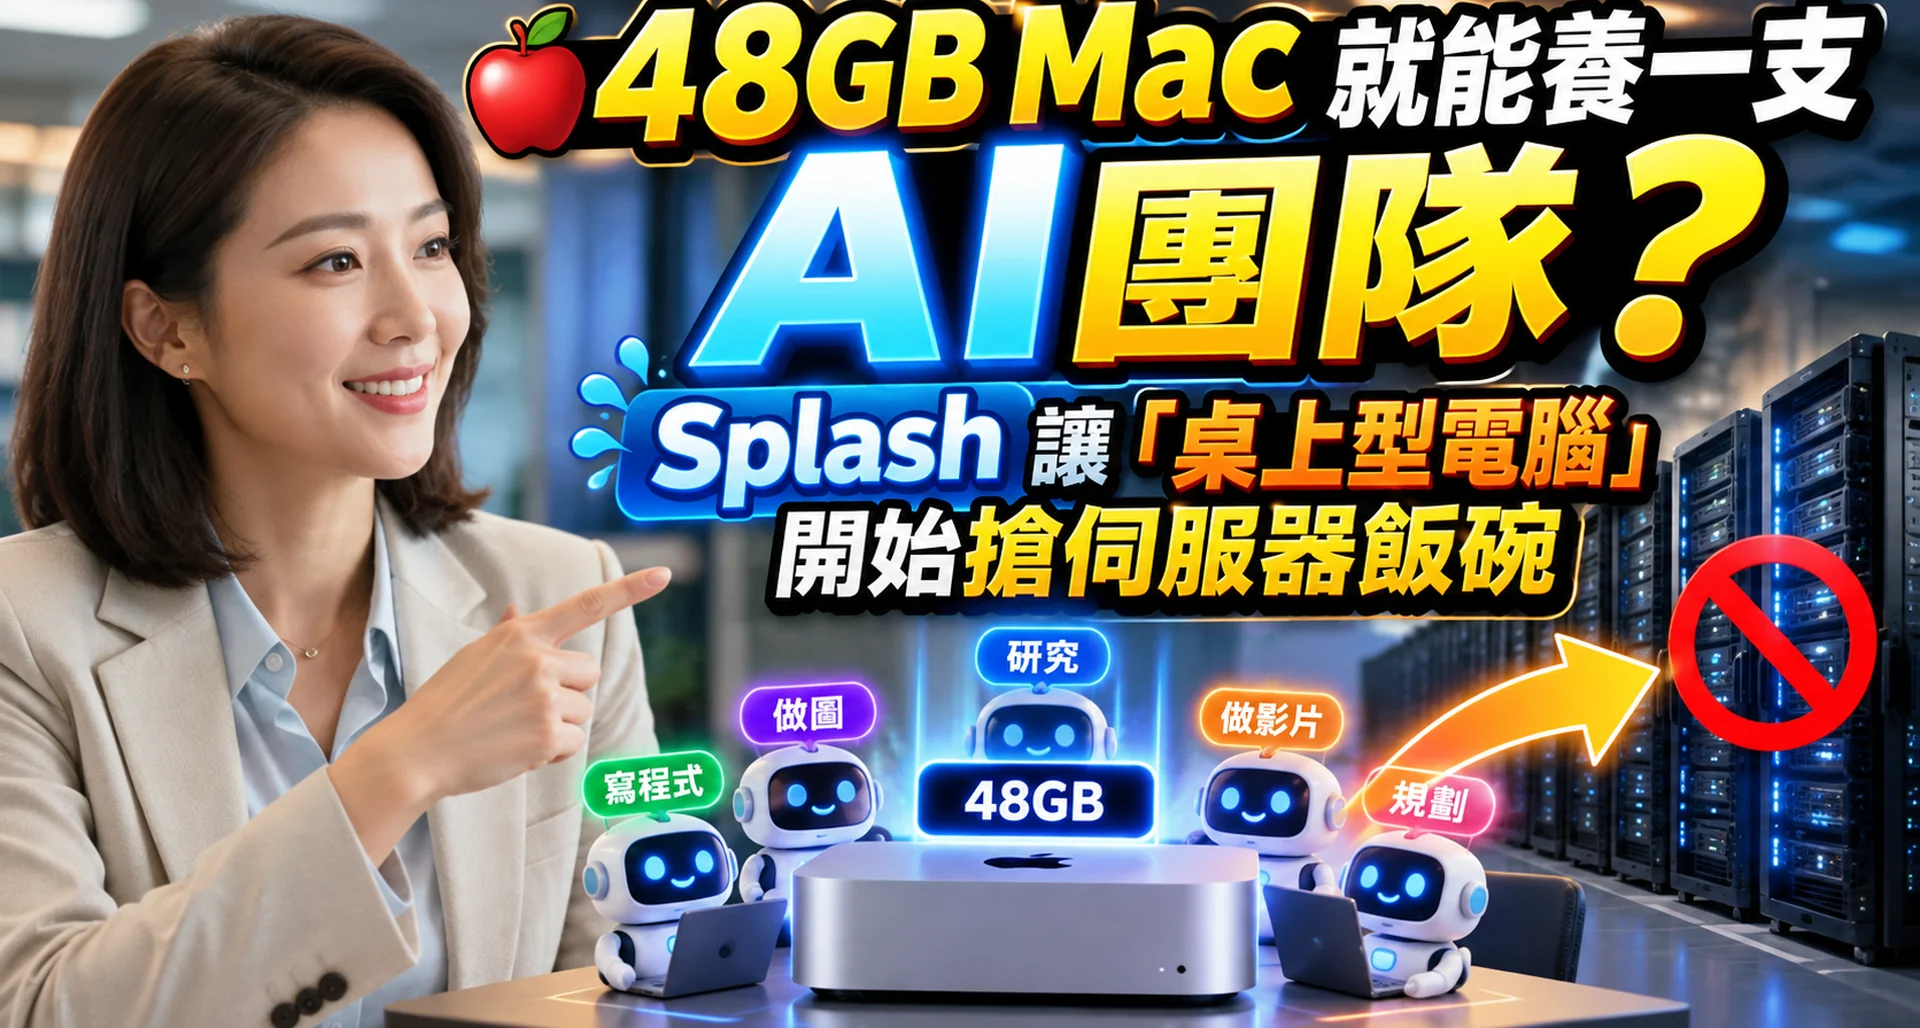
Inco AI 推出的 Splash,正在改變中小企業部署地端 AI 的想像。它不是追求支援大量模型的通用推論引擎,而是針對特定模型打造專屬核心、記憶體配置與推論最佳化。目前 Qwen3.8-27B 已能在 Apple Silicon 上展現高速推論與多人併發能力,讓一台大記憶體 Mac 有機會從個人 AI 實驗機,進一步成為企業內部 AI Server。除了文字生成與 Coding,也能支援 RAG、文件分析、圖片理解與 Agent Tool Calling。對中小企業而言,真正值得注意的不是單純每秒多少 Token,而是能否讓 2~4 位員工共同使用、降低部署維護成本,同時讓重要資料留在公司內部。Splash 顯示了一個新方向:未來企業導入 Local AI,可能真的只需要一台開機就能生產的 Mac。

Continue Reading 一台 Mac,開始有資格成為公司的 AI 伺服器了:從 Splash 看中小企業地端 AI 的下一步
短片:台積追聯發?🔥
台積追聯發?🔥

短片:台積追聯發?🔥

台積電董事長暨總裁魏哲家日前接待退休主管時,當著聯發科副董事長暨執行長蔡力行的面開玩笑表示,希望台積電股價「趕快趕上聯發科」,一句話迅速引發市場熱議。9 月 21 日台積電收在 2,480 元,聯發科則收在 5,010 元,兩者每股價差達 2,530 元,讓部分投資人聯想到台積電是否仍有上漲空間。不過,5,010 元並非魏哲家提出的目標價,兩家公司股本、市值及營運規模也不同,單純比較每股價格並不能直接衡量企業價值。甚至有網友幽默表示,若聯發科跌到 2,480 元,也算是「趕上」。這句話究竟只是場合上的幽默,還是展現魏哲家對台積電未來發展的信心,也成為投資人討論焦點。

Continue Reading 短片:台積追聯發?🔥
短片:AI 沒單就去挖礦 🔥
AI 沒單就去挖礦 🔥​

短片:AI 沒單就去挖礦 🔥

企業導入 AI,真的每件工作都需要出動 ChatGPT、Claude、Gemini 這類大型模型嗎?TypeSafe AI 推出的 Jev 提供另一種思路:它不負責聊天或長篇文字生成,而是專注於選擇、評分與 Yes/No 等快速決策。對中小企業而言,垃圾郵件判斷、任務分類、Agent 路由、Context 篩選等工作,如果都交給大型模型,不只速度可能受影響,也會累積大量 Token 與 API 成本。Jev 的價值並非取代大型語言模型,而是成為 AI 系統中的「交通警察」,讓簡單工作快速分流,複雜任務再交給大型 AI。未來企業 AI 的關鍵,可能不再只是追求更強模型,而是建立大型模型、小模型、決策模型與人工審核各司其職的 AI 團隊。

Continue Reading 短片:AI 沒單就去挖礦 🔥
短片:⚡ 你正在拿 ChatGPT 法拉利送外賣?
法拉利送外賣?

短片:⚡ 你正在拿 ChatGPT 法拉利送外賣?

企業導入 AI,真的每件工作都需要出動 ChatGPT、Claude、Gemini 這類大型模型嗎?TypeSafe AI 推出的 Jev 提供另一種思路:它不負責聊天或長篇文字生成,而是專注於選擇、評分與 Yes/No 等快速決策。對中小企業而言,垃圾郵件判斷、任務分類、Agent 路由、Context 篩選等工作,如果都交給大型模型,不只速度可能受影響,也會累積大量 Token 與 API 成本。Jev 的價值並非取代大型語言模型,而是成為 AI 系統中的「交通警察」,讓簡單工作快速分流,複雜任務再交給大型 AI。未來企業 AI 的關鍵,可能不再只是追求更強模型,而是建立大型模型、小模型、決策模型與人工審核各司其職的 AI 團隊。

Continue Reading 短片:⚡ 你正在拿 ChatGPT 法拉利送外賣?
別再拿法拉利送外賣:Jev 出現後,我開始重新思考企業 AI 的分工方式
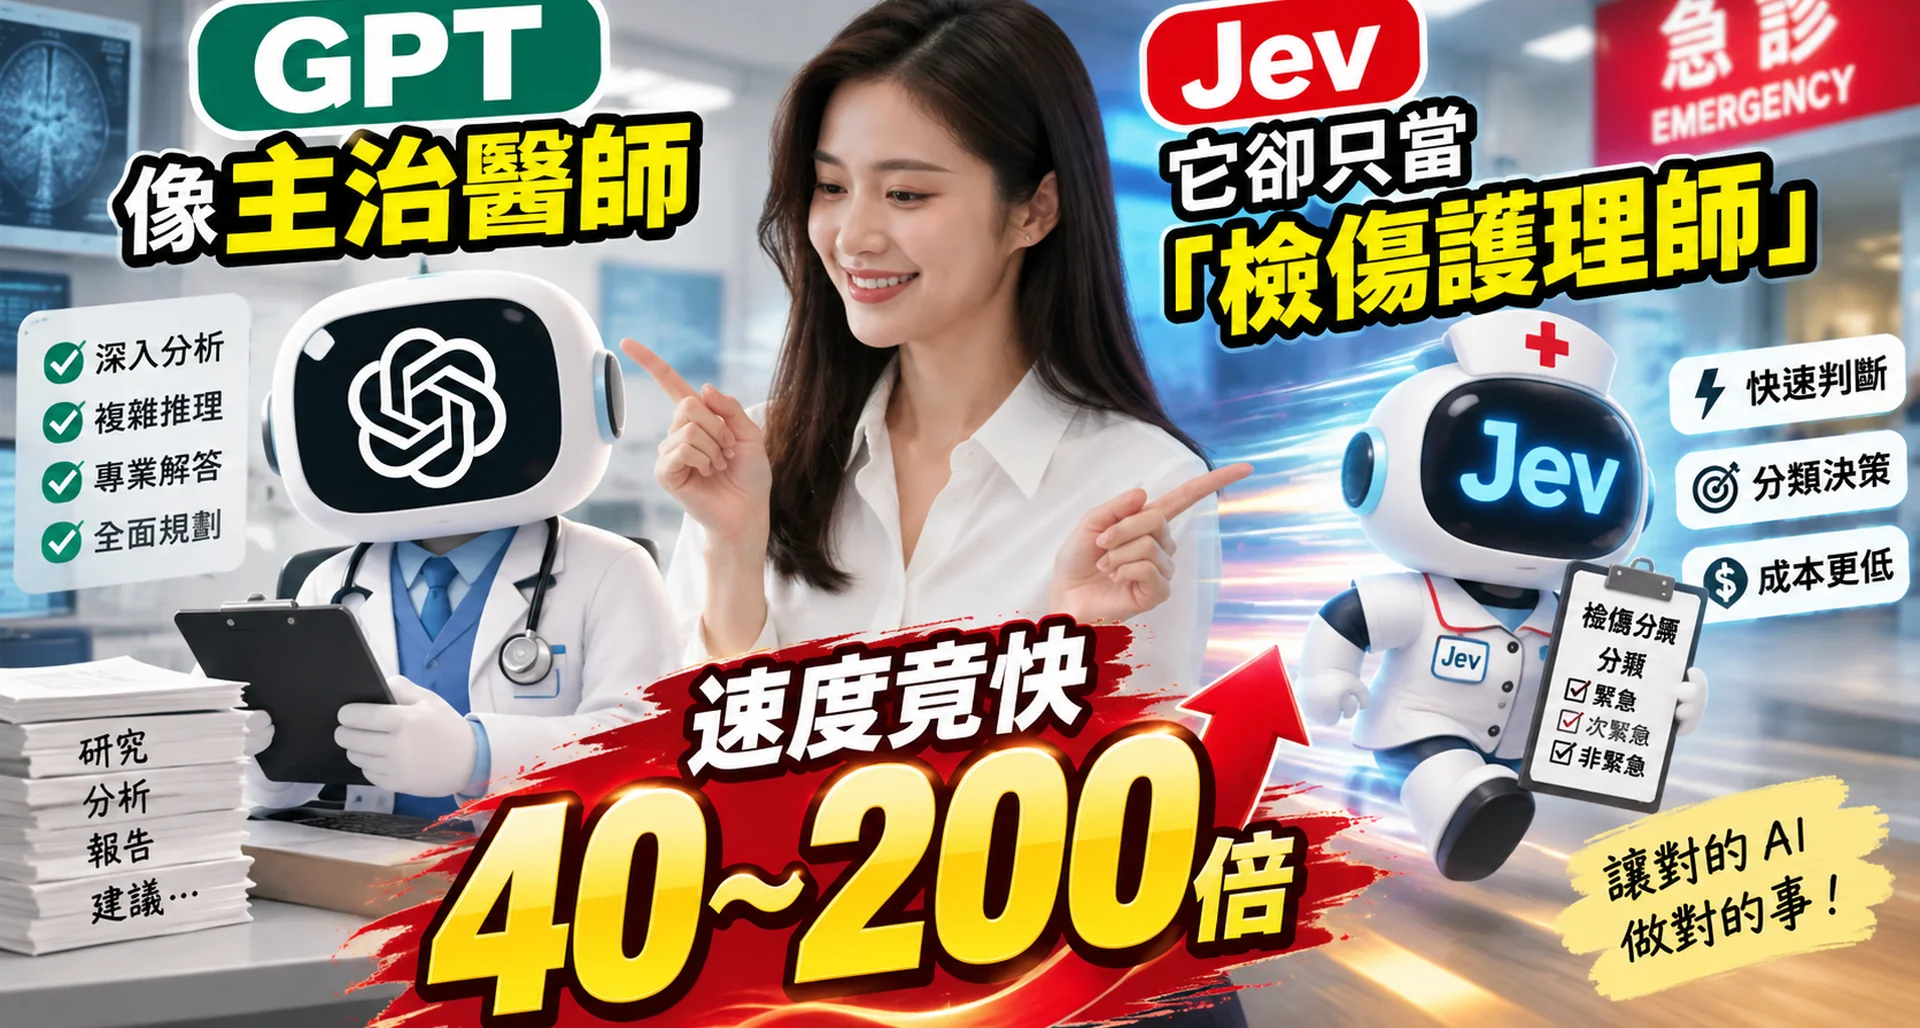
GPT 像主治醫師,Jev 它卻只當「檢傷護理師」🏥 速度竟快 40~200 倍

別再拿法拉利送外賣:Jev 出現後,我開始重新思考企業 AI 的分工方式

企業導入 AI,真的每件工作都需要出動 ChatGPT、Claude、Gemini 這類大型模型嗎?TypeSafe AI 推出的 Jev 提供另一種思路:它不負責聊天或長篇文字生成,而是專注於選擇、評分與 Yes/No 等快速決策。對中小企業而言,垃圾郵件判斷、任務分類、Agent 路由、Context 篩選等工作,如果都交給大型模型,不只速度可能受影響,也會累積大量 Token 與 API 成本。Jev 的價值並非取代大型語言模型,而是成為 AI 系統中的「交通警察」,讓簡單工作快速分流,複雜任務再交給大型 AI。未來企業 AI 的關鍵,可能不再只是追求更強模型,而是建立大型模型、小模型、決策模型與人工審核各司其職的 AI 團隊。

Continue Reading 別再拿法拉利送外賣:Jev 出現後,我開始重新思考企業 AI 的分工方式
短片:🔥 AMD R9700 暴力解鎖!27B 模型狂飆
💥 AMD R9700 暴力解鎖!27B 模型狂飆

短片:🔥 AMD R9700 暴力解鎖!27B 模型狂飆

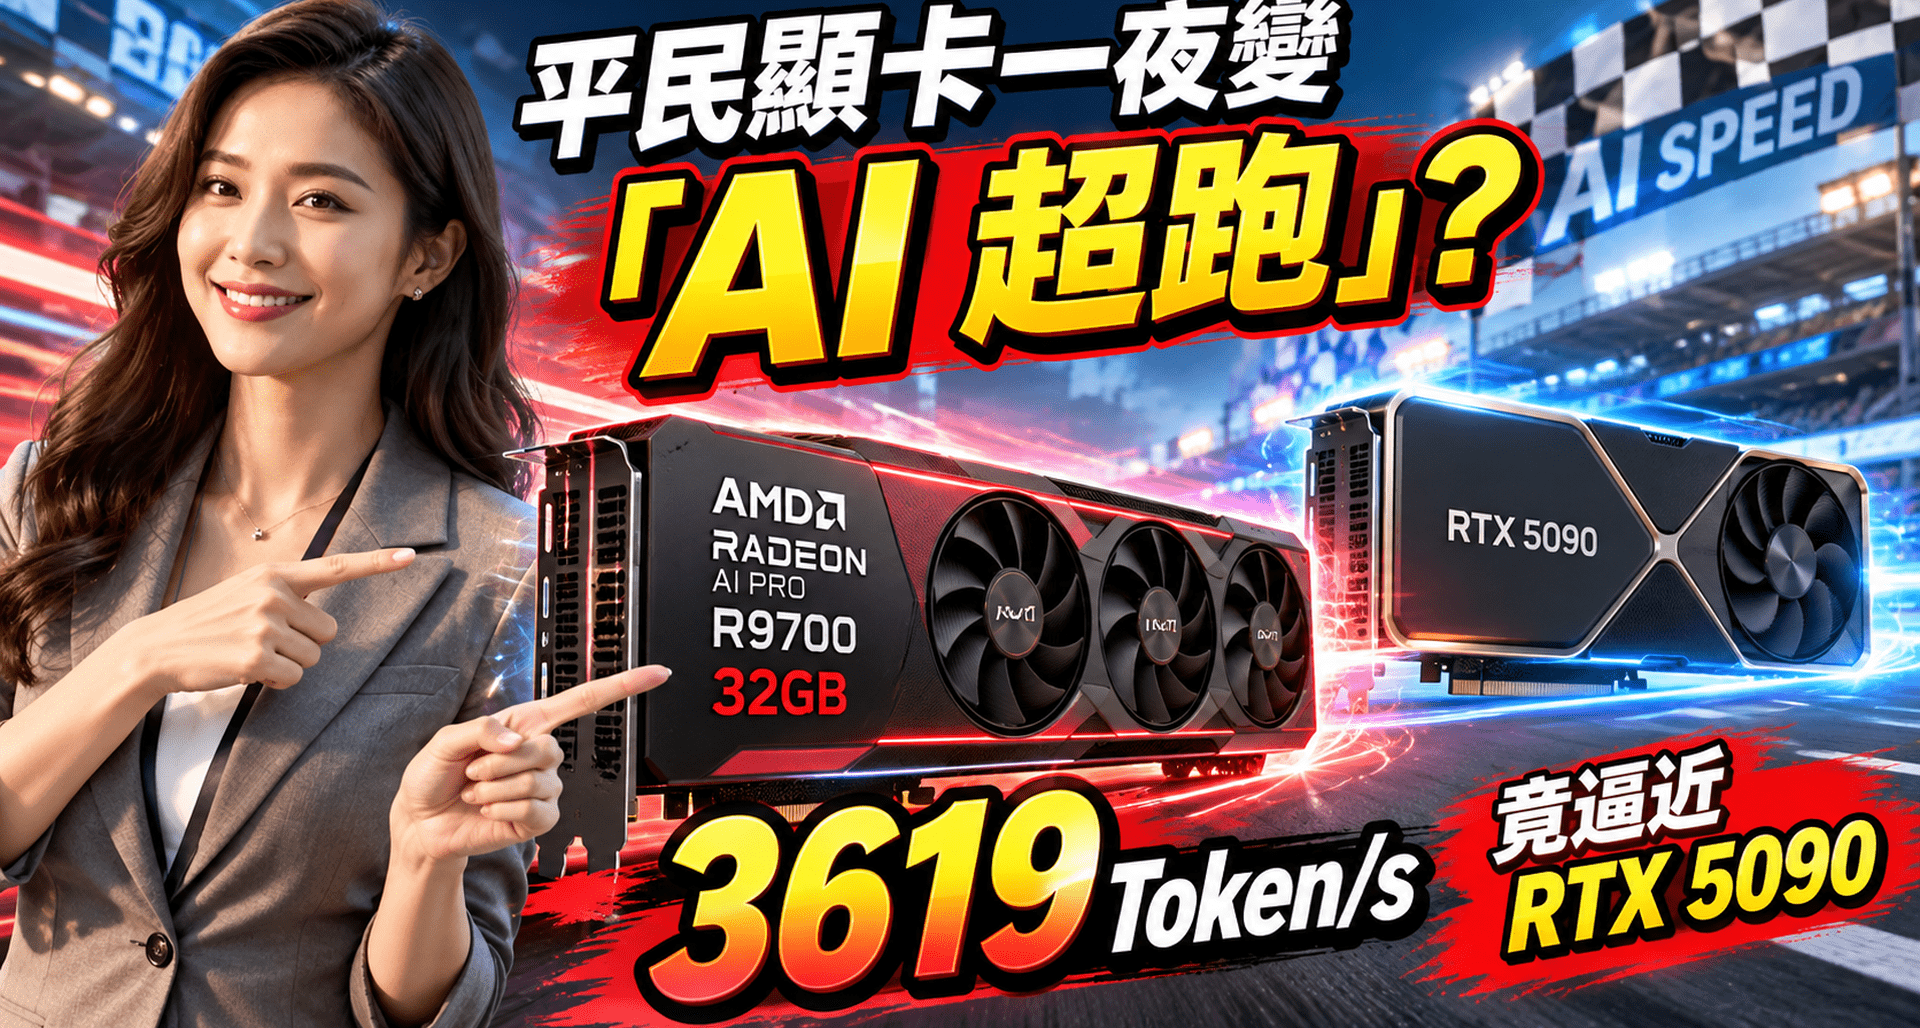
AMD Radeon R9700 32GB 最近在開源 AI 社群引發熱議,透過軟體與推論框架優化,單卡運行 27B 大模型時,Prefill 可達每秒 3619 Tokens,Decode 更達每秒 153 Tokens。關鍵在於將 NVFP4 即時轉換為 MXFP4,降低資料搬運與記憶體頻寬壓力,讓同一張顯卡發揮更高效能。不過高跑分背後仍有 Prefix Caching、PCIe 頻寬、散熱功耗,以及 ROCm、vLLM、Docker 部署等挑戰。R9700 雖展現高 CP 值潛力,但更像一台需要工程師調校的 AI F1 賽車。

Continue Reading 短片:🔥 AMD R9700 暴力解鎖!27B 模型狂飆
短片:🔥顯卡沒換 效能直接翻倍!🚀
掌心裡的顯卡沒換 mini 助理

短片:🔥顯卡沒換 效能直接翻倍!🚀

開發者最新實測顯示,AMD Radeon AI PRO R9700 32GB 不需更換硬體,只靠軟體優化,就能讓地端 AI 推論效能大幅提升。透過將 NVIDIA NVFP4 模型載入時轉為 MXFP4,搭配針對 AMD RDNA4 優化的推論 Kernel,執行 Qwen3.8 27B 時,Coding 超過每秒 120 Tokens,JSON 更達 153 Tokens,8 路並行總吞吐達 471 Tokens。這代表 AMD 地端 AI 生態正逐漸成熟。對熟悉 Linux、Docker、ROCm 的開發者而言,已值得測試;但中小企業真正需要的,不只是高跑分 GPU,而是能讓多人共用、資料不外流、開機即用且有人維護的地端 AI Server。

Continue Reading 短片:🔥顯卡沒換 效能直接翻倍!🚀
顯卡沒換,AI 效能卻翻倍:從 AMD R9700 看地端 AI 正在發生的真正變化​
AMD R9700 透過軟體優化提升地端 AI 推理效能,展現不用更換 GPU 也能大幅提升效能的可能性。

顯卡沒換,AI 效能卻翻倍:從 AMD R9700 看地端 AI 正在發生的真正變化​

AMD Radeon AI PRO R9700 32GB 最近在 Local LLM 社群引發關注。開發者實測 Qwen3.8 27B,透過 NVFP4 轉 MXFP4、客製化 Kernel 與推論軟體優化,Coding 達 120 Tokens/s、JSON 更衝到 153 Tokens/s,8 路並發總吞吐達 471 Tokens/s,整體效能甚至接近翻倍。 這次真正值得注意的,不是 AMD 是否擊敗 NVIDIA,而是 AI 推論已從單純比 GPU 硬體,進入「硬體+量化格式+Kernel+推論引擎」的軟硬整合競爭。對有經驗的 AI 開發者,R9700 已值得進場測試;對中小企業,則不應只買顯卡,而應導入包含 Linux、Docker、RAG、Agent、監控與維護的完整地端 AI Server。未來企業真正該問的,可能不是用了哪張 GPU,而是軟體能把 GPU 發揮到幾成。

Continue Reading 顯卡沒換,AI 效能卻翻倍:從 AMD R9700 看地端 AI 正在發生的真正變化​

End of content

No more pages to load