這幾年如果你問企業資訊部門:「要在公司內部跑一套 AI,需要什麼?」
多數技術主管腦中第一個浮現的,大概都是 NVIDIA GPU。
RTX 4090、5090,甚至 RTX PRO、A 系列專業卡,再往上就是昂貴的企業級 GPU Server。接著還有 Linux、CUDA、Docker、Driver、vLLM、模型量化、API Server,以及一大堆部署與維護問題。
但最近 Inco AI 發表的 Splash,讓我開始重新思考一件事情:
中小企業的 AI Server,真的一定要長得像一台 GPU Server 嗎?
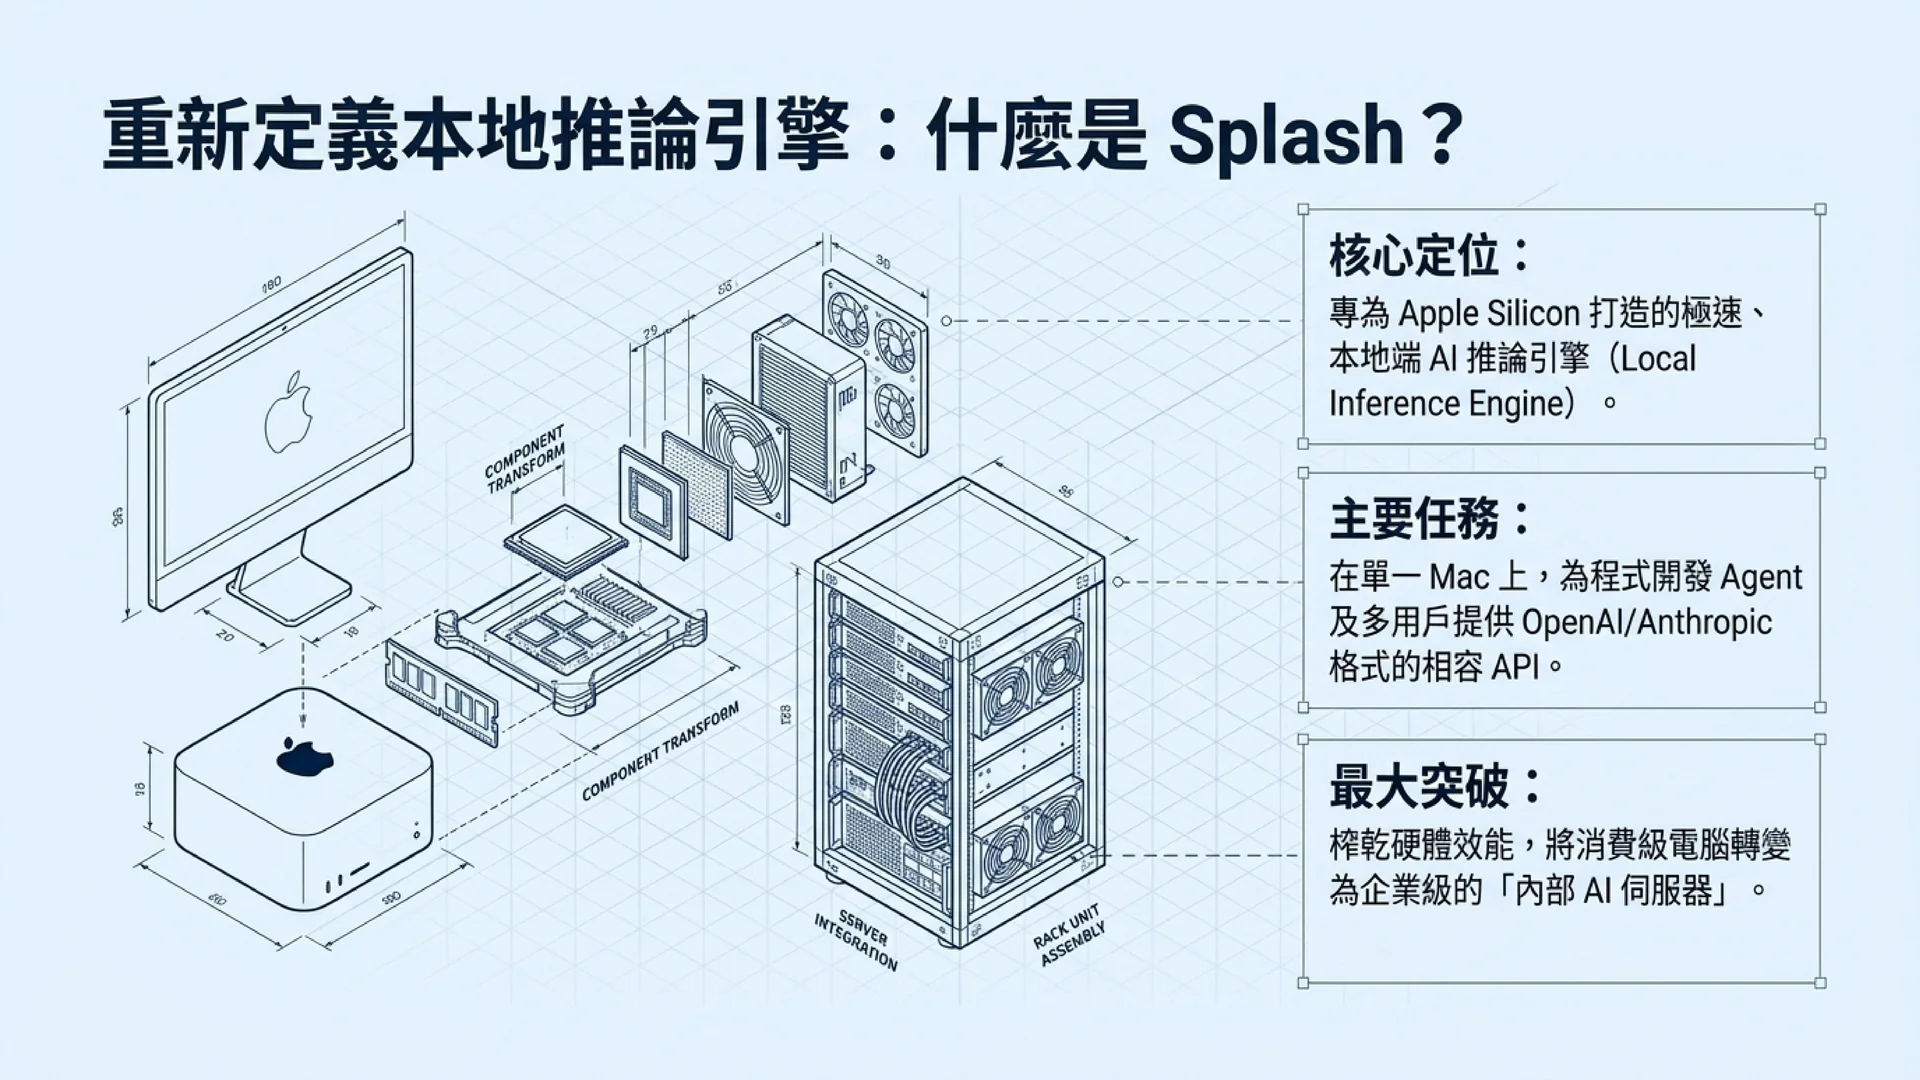
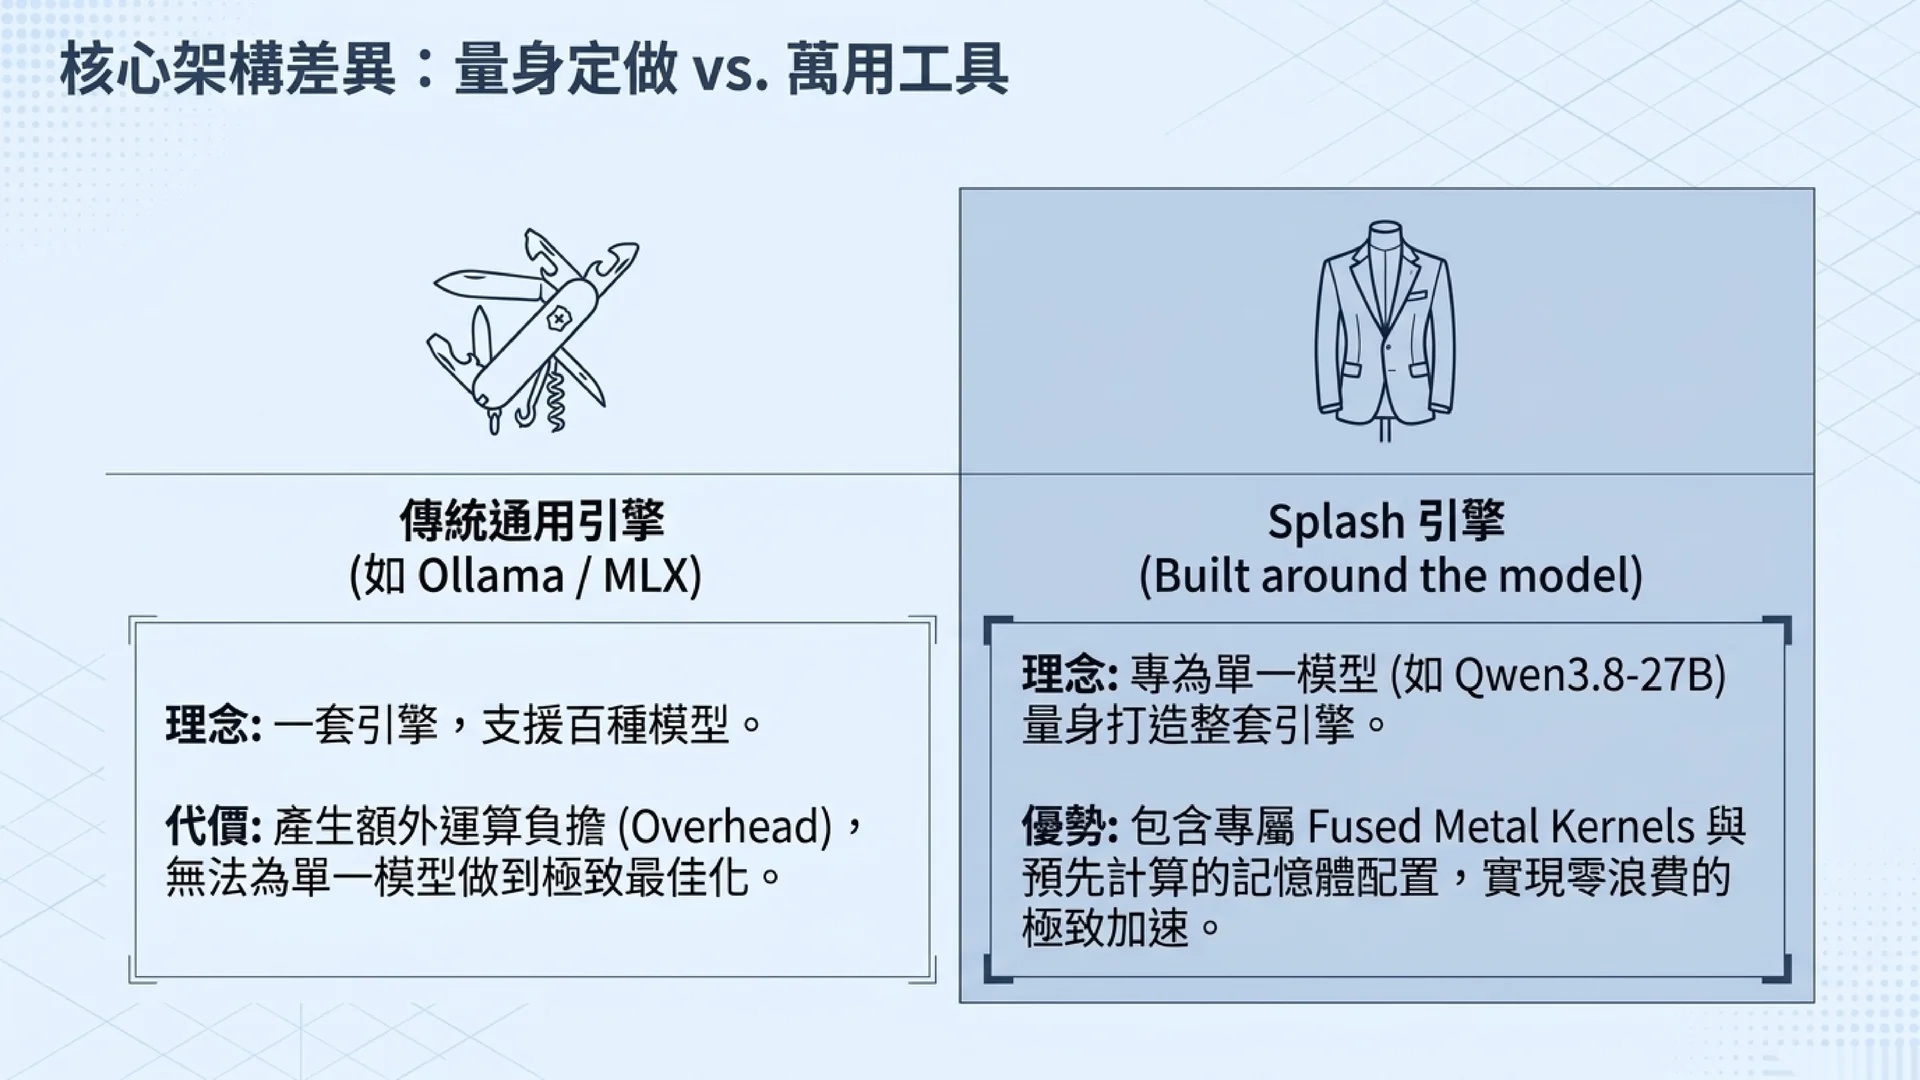
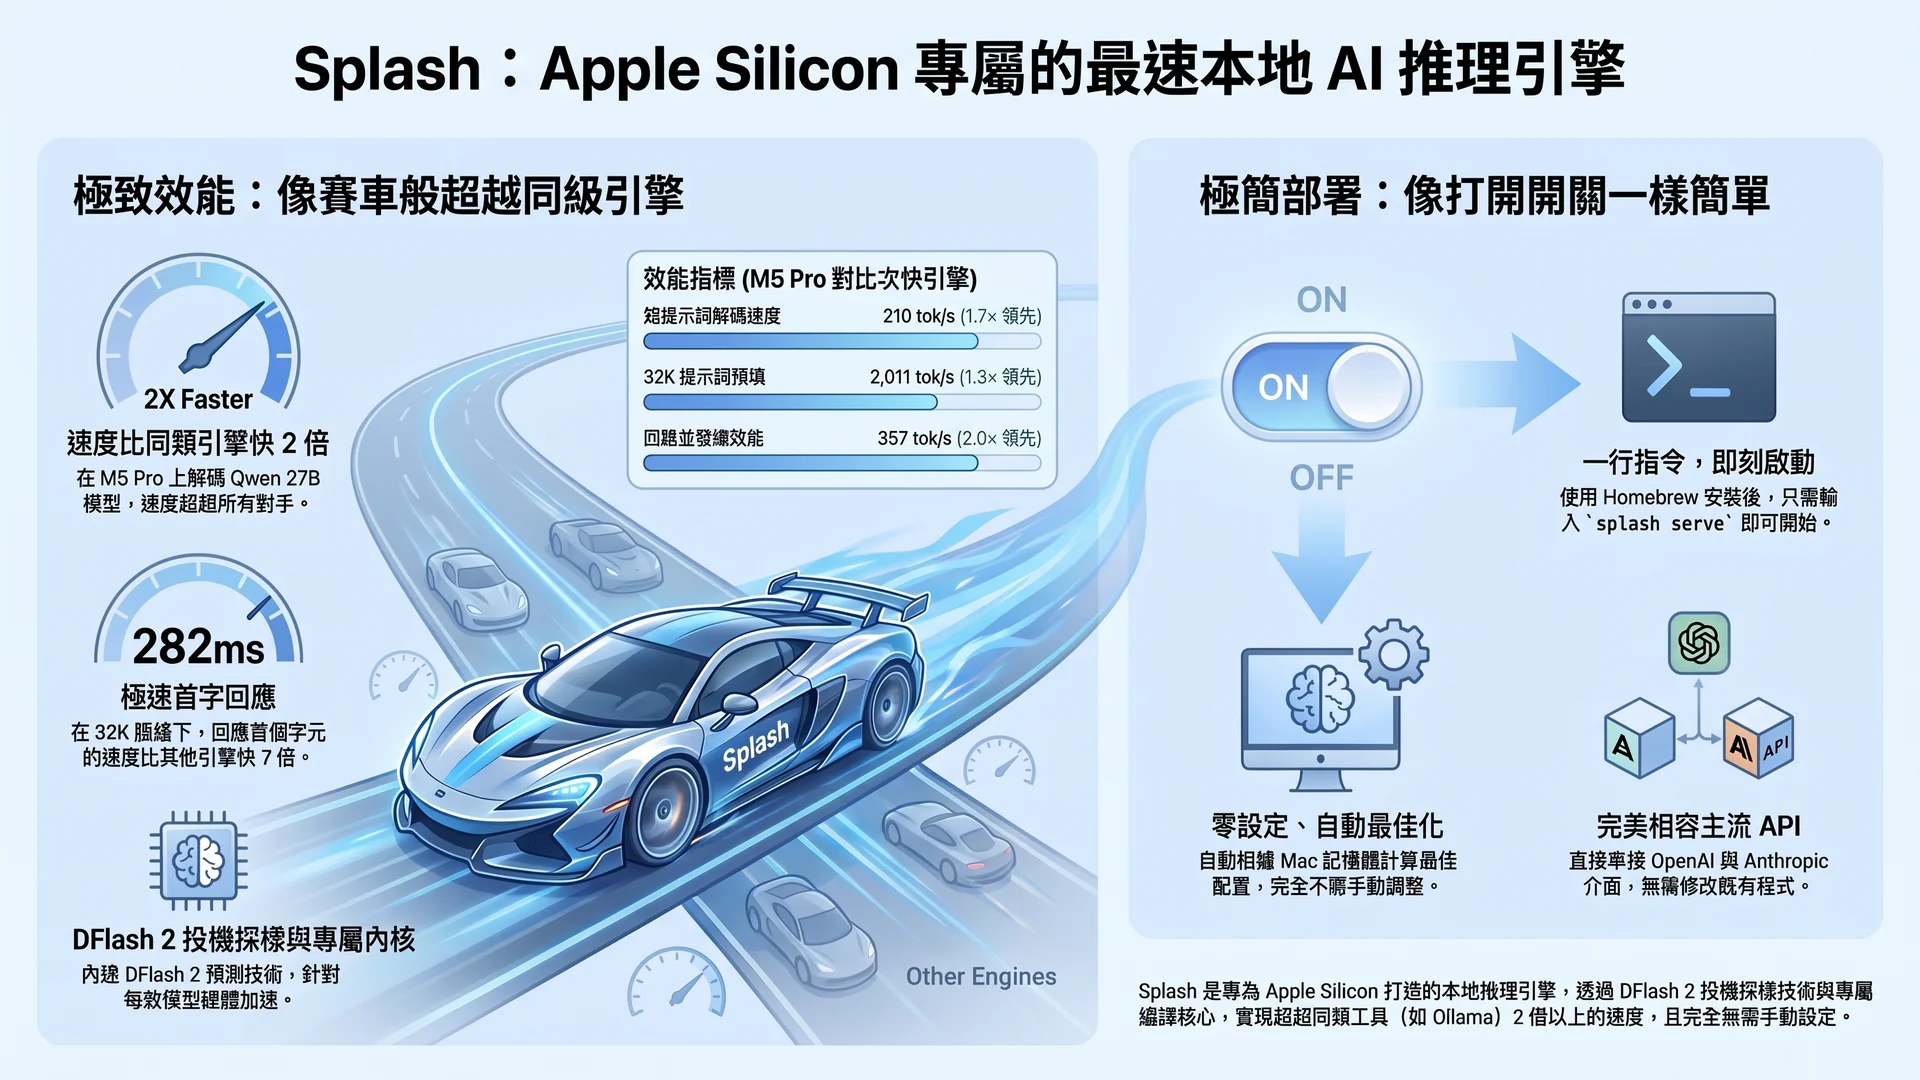
Splash 是一套專門針對 Apple Silicon 打造的開源 inference engine。它最有意思的地方,不只是「又多了一套推論引擎」,而是它走了一條和 Ollama、llama.cpp、MLX 等通用型方案不太一樣的路。
一般推論引擎追求的是:
一套引擎,盡量支援愈多模型愈好。
Splash 卻反過來:
我不追求什麼模型都跑,而是針對特定模型,把整個推論引擎做到極致。
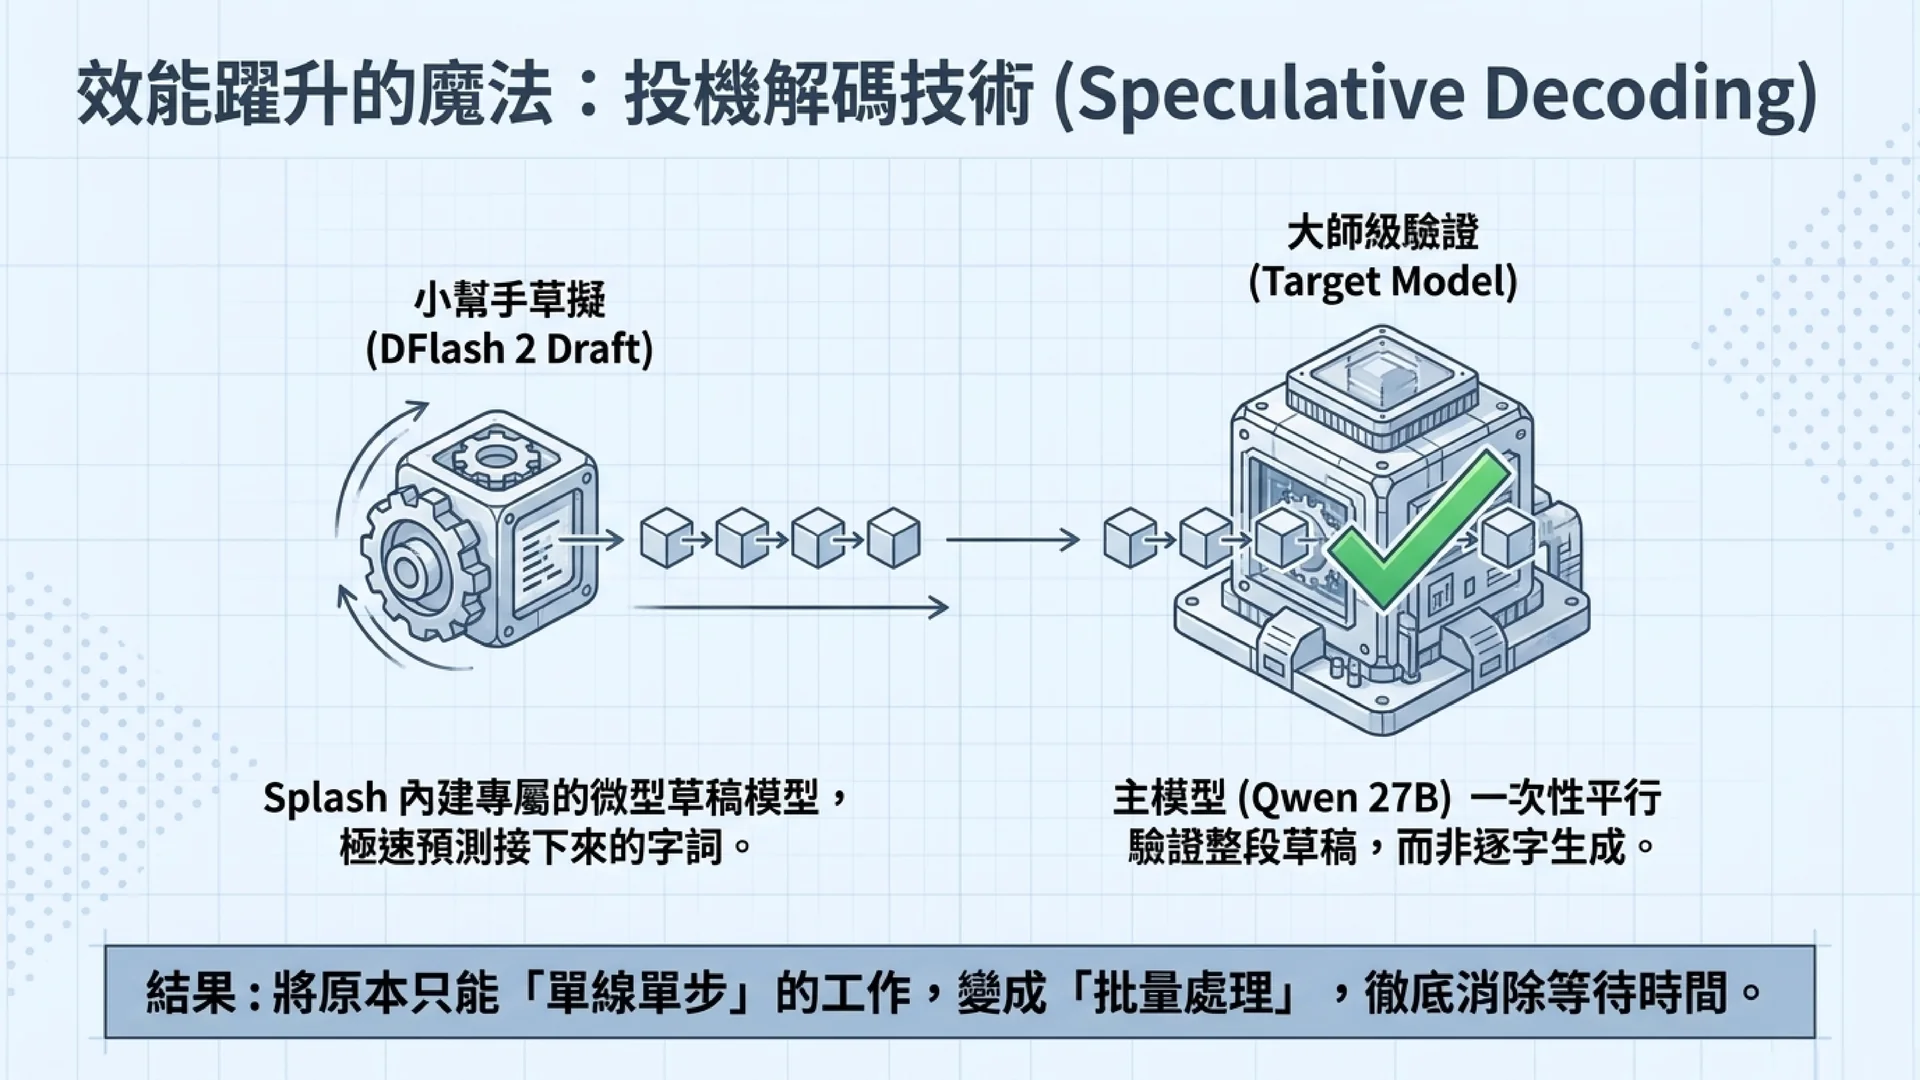
每個支援模型都有專屬的 fused Metal kernels、DFlash 2 draft model,以及針對該模型與硬體計算出來的記憶體配置。Runtime、Scheduler 與 API 可以共用,但真正執行模型的核心部分則高度專用化。
這個思維,我認為非常值得企業 IT 人員注意。
從「什麼都能跑」變成「把一件事情跑到最好」
企業正式上線的系統,和工程師實驗模型,其實是兩回事。
研發階段我們當然希望今天跑 Qwen、明天試 Gemma、後天再換另一個模型。
但真正進入 Production 之後,企業通常不希望每天換模型。
假設公司已經決定:
Qwen3.8-27B 就是我們內部 AI Agent 的主要模型。
接下來真正重要的問題就變成:
它能不能更快?
能不能穩定服務多個員工?
Context 能不能做大?
重複文件能不能快速 Cache?
部署能不能簡單?
維護成本能不能降低?
這恰好就是 Splash 的設計方向。
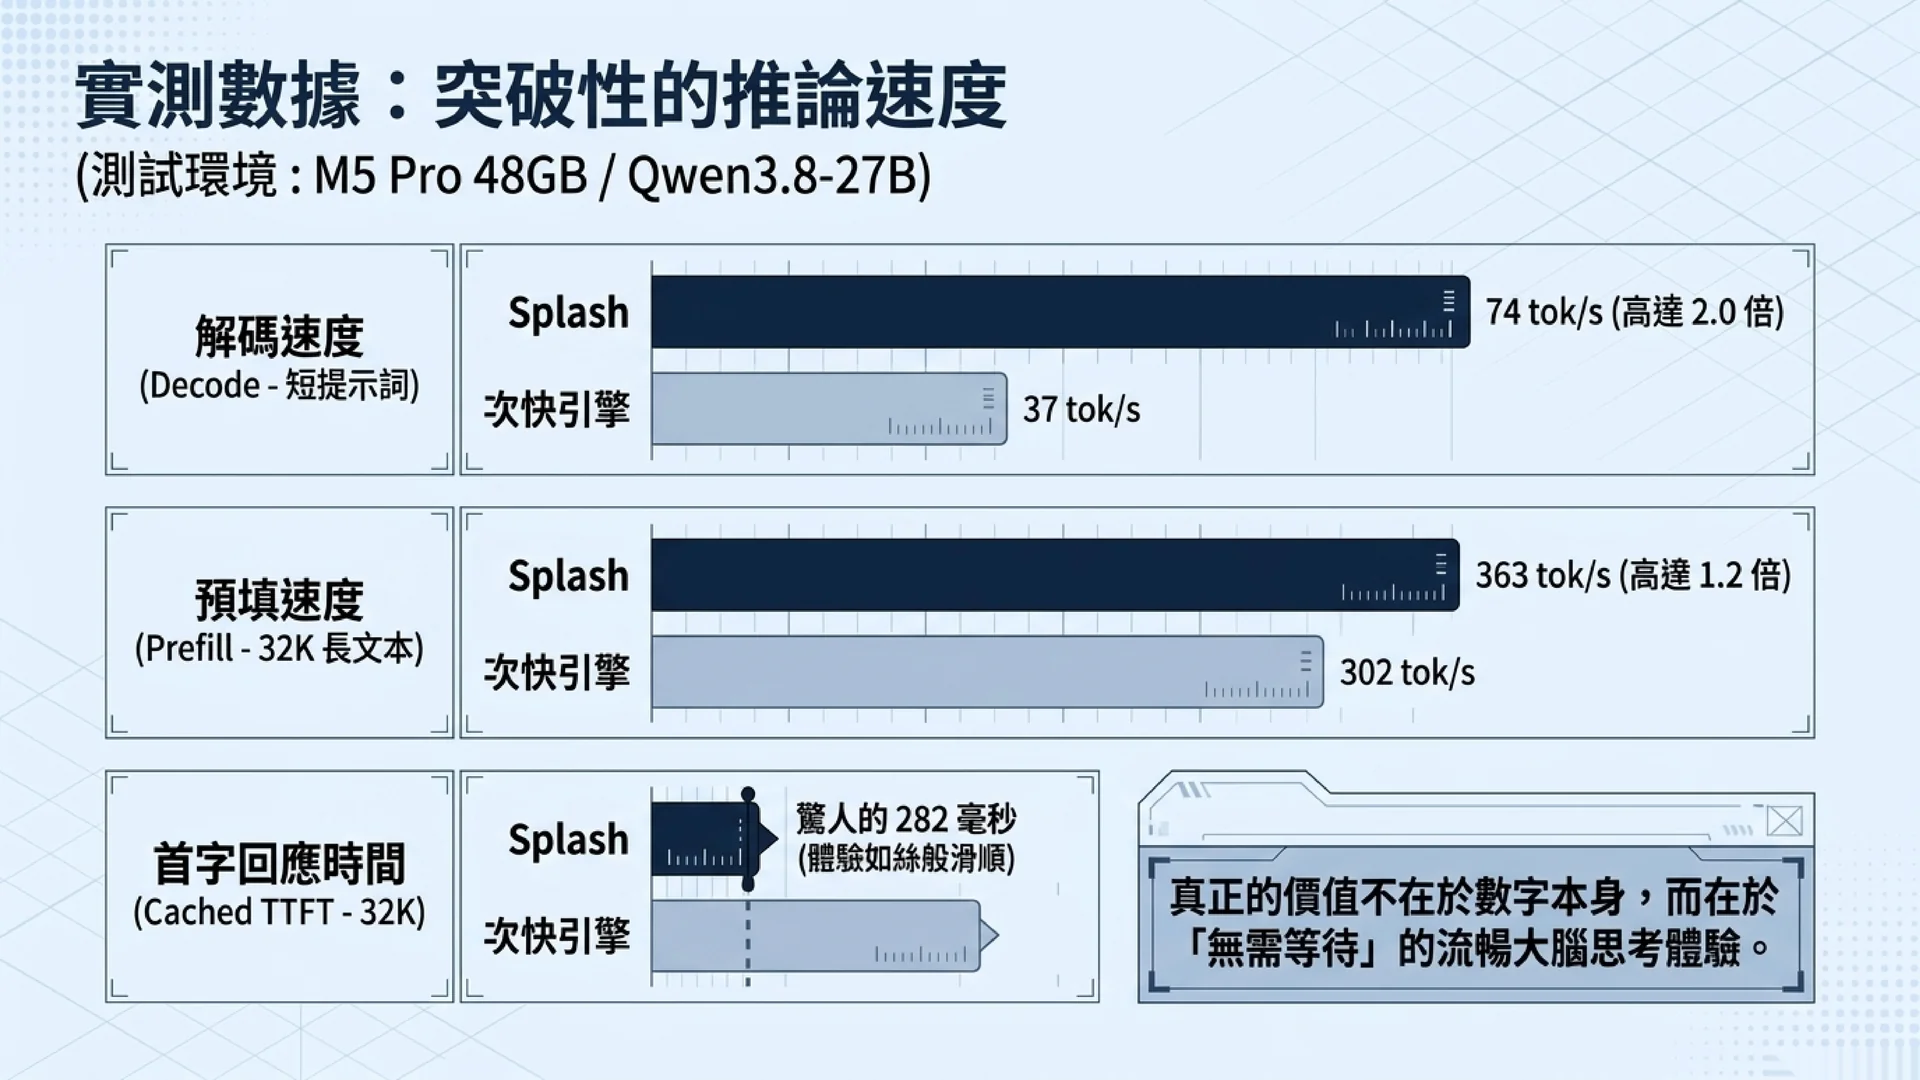
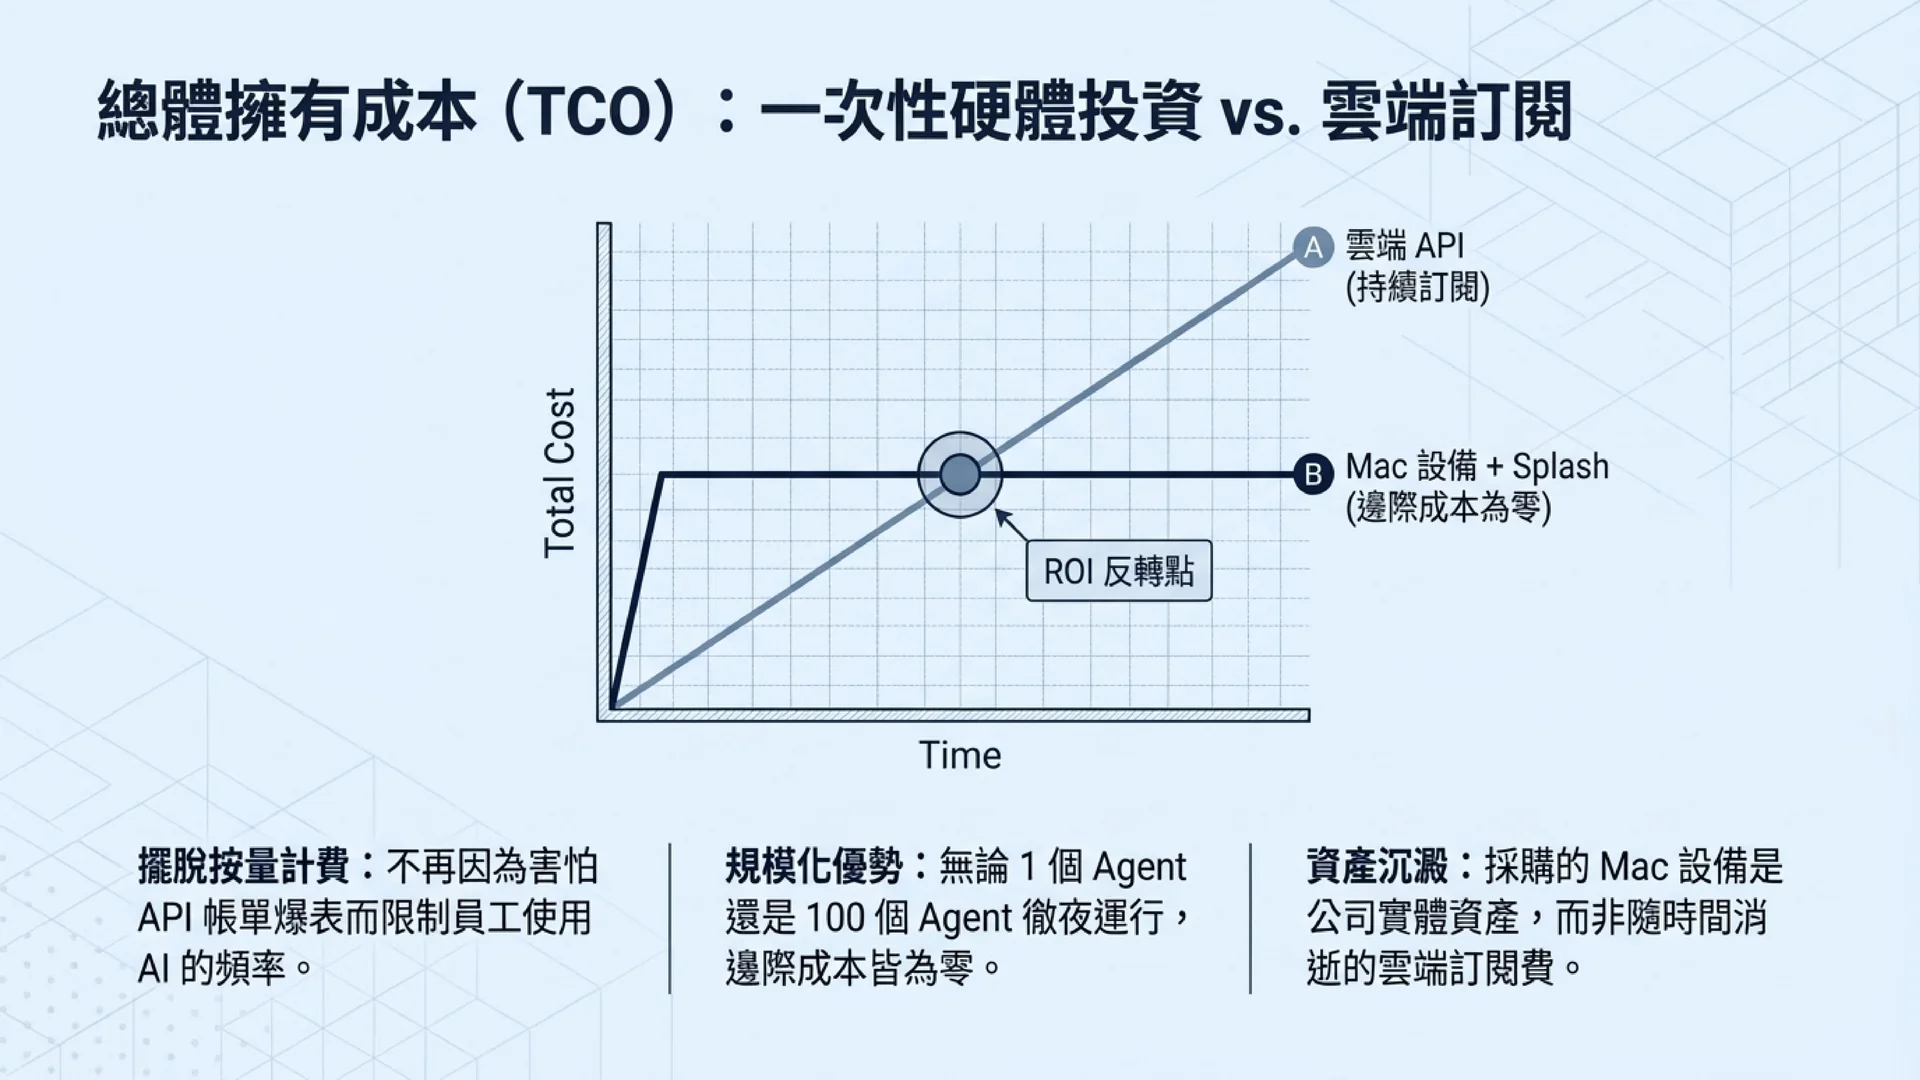
Inco AI 官方使用 M5 Pro、16-core GPU、48GB Unified Memory 測試 Qwen3.8-27B,短 Prompt Decode 可以達到 74 tok/s;32K Prompt Prefill 約 363 tok/s;32K Context 在 Cache 命中之後,Time to First Token 可以降低到 282ms。
真正讓我注意的反而是另外一個數字:
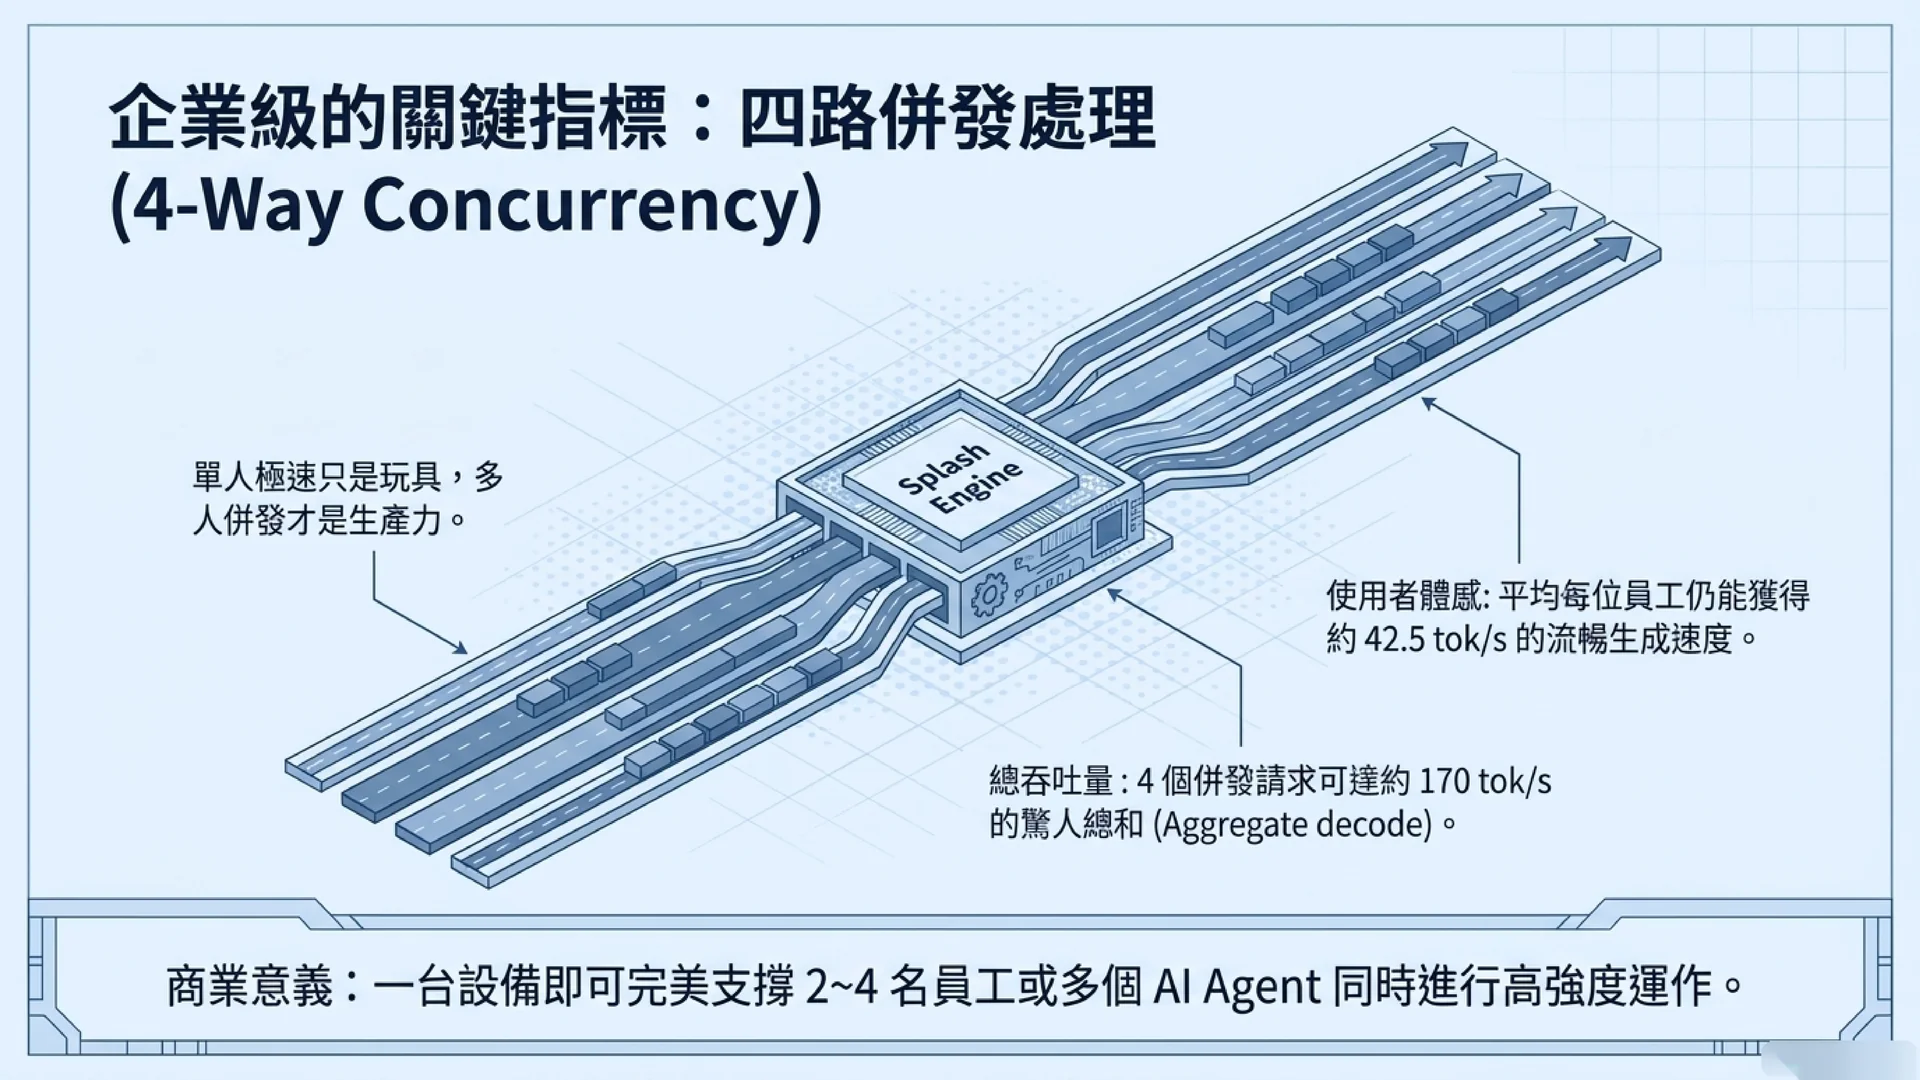
4 個 concurrent short prompts,Aggregate Decode 達到 170 tok/s。
官方測試中,這個成績大約是其比較的次快引擎 3.9 倍。
為什麼我特別注意這個?
因為企業根本不在乎老闆一個人聊天可以跑 80 tok/s 還是 100 tok/s。
企業真正關心的是:
四個員工一起用的時候,還能不能工作?
這才是 Production。
48GB Mac,開始出現「小型 AI Server」的味道
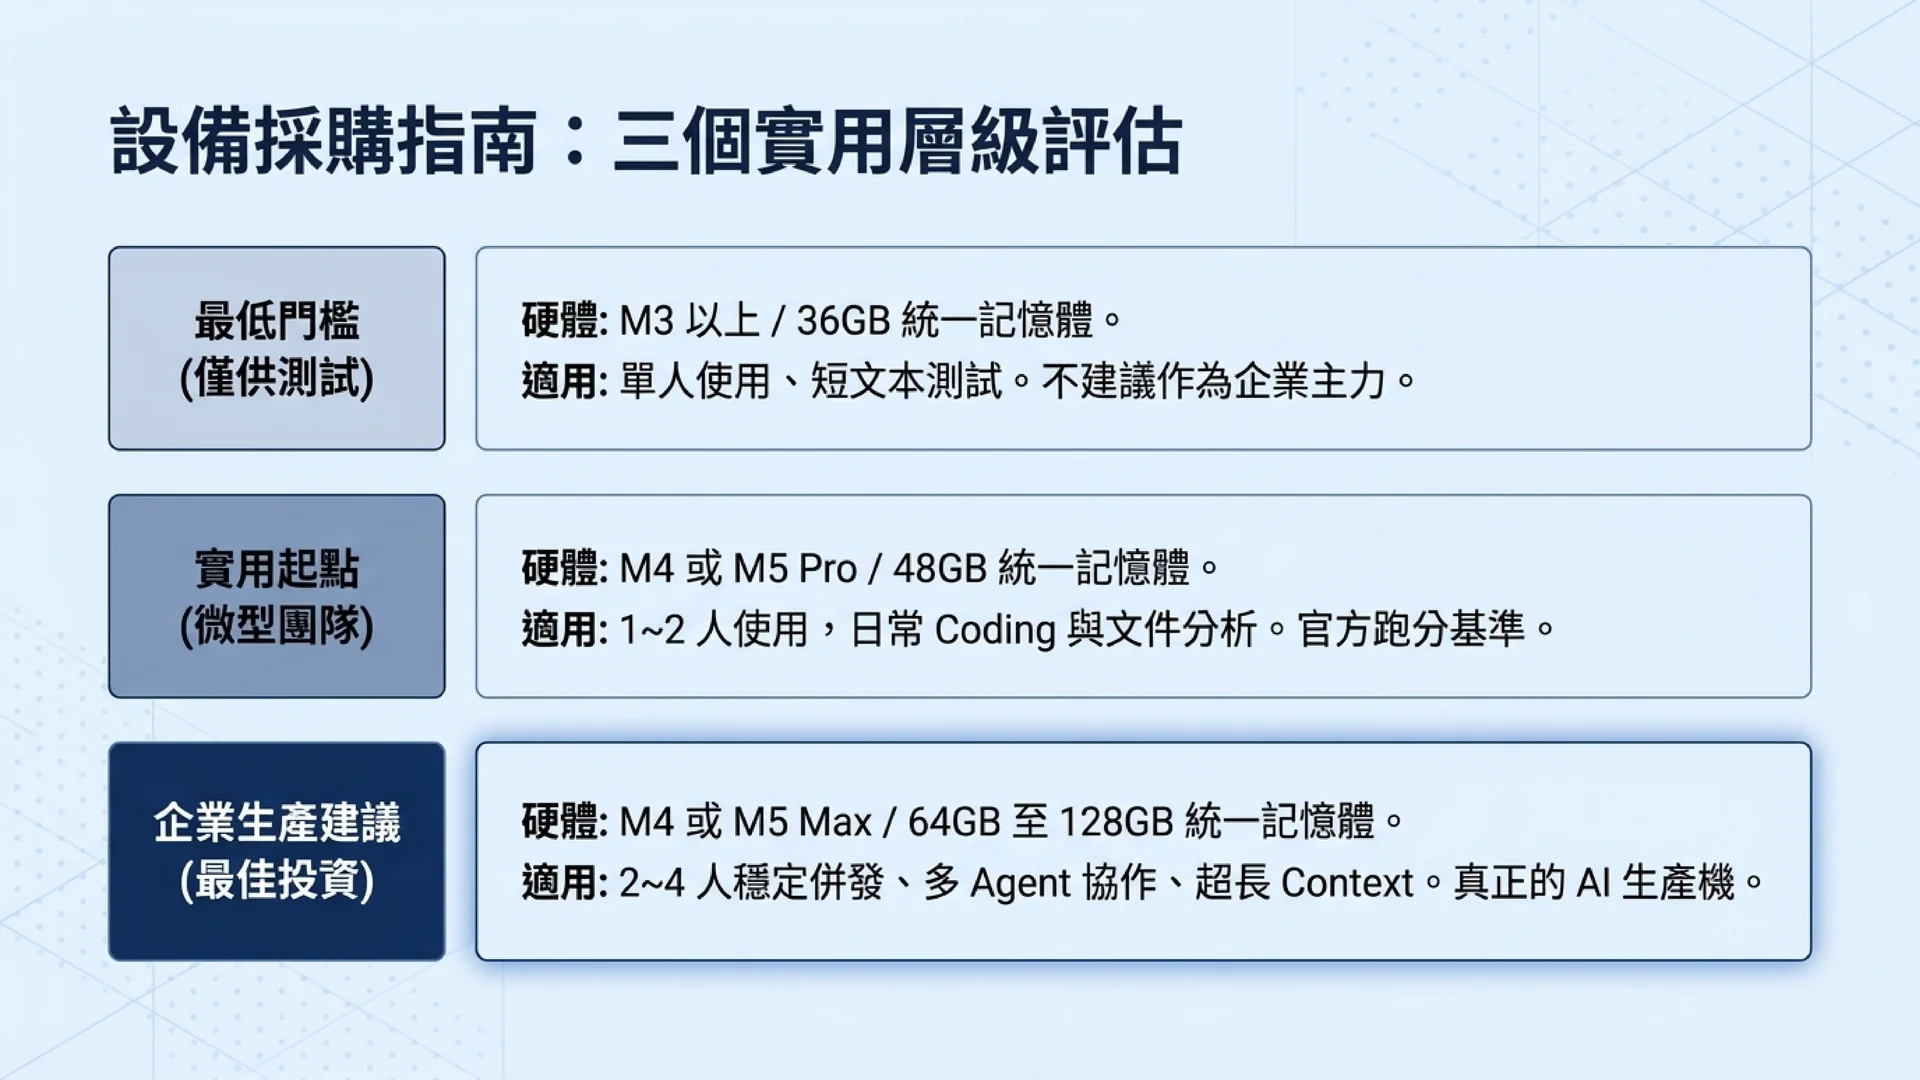
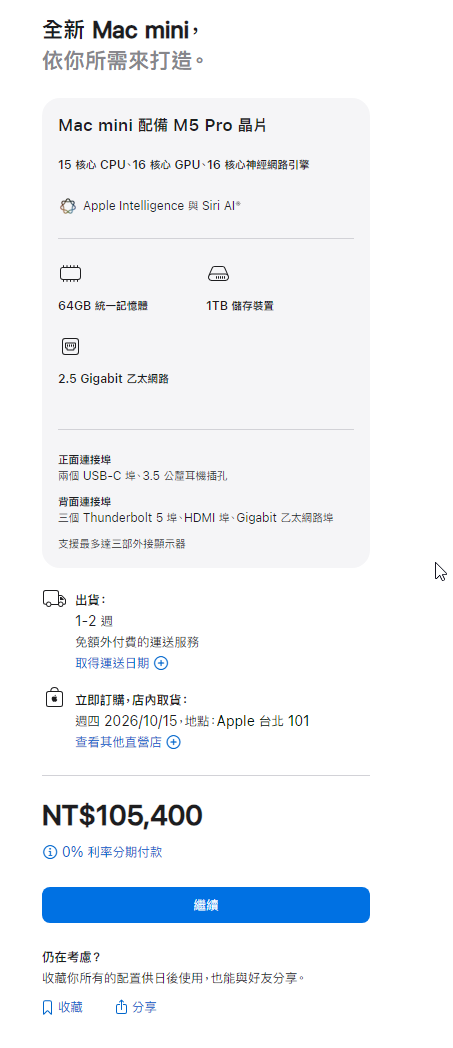
Splash 官方最低要求是 Apple M3 以上、macOS 26.4 以上,以及至少 36GB Unified Memory,但官方直接建議使用 48GB 以上。
這裡我要特別提醒一件事。
能跑,跟適合生產,是兩回事。
36GB 可以啟動,不代表我會建議公司採購 36GB 當 Production Server。
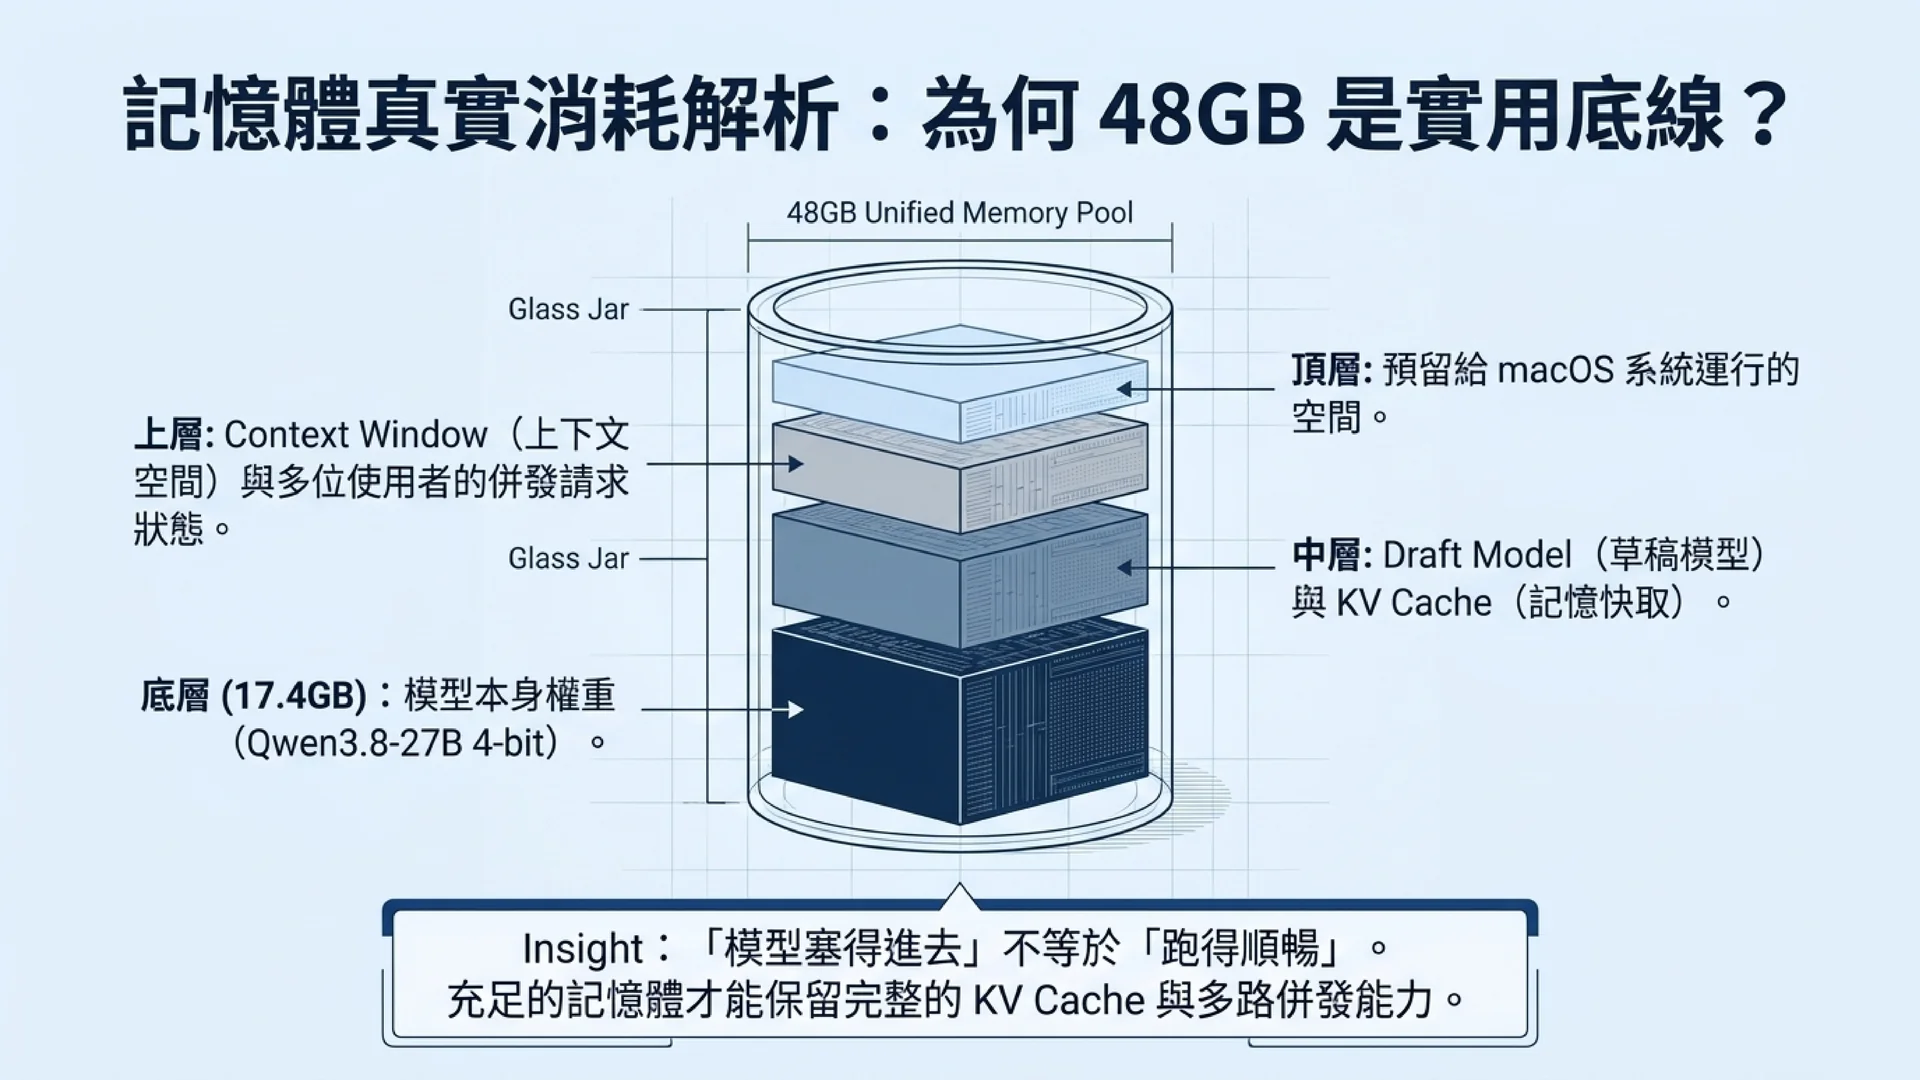
Qwen3.8-27B-Splash 整個 Package 約 17.4GB,其中 Target Model 約 14.1GiB,而且本身已經是 4-bit;另外還有約 1.2GiB 的 DFlash 2 draft model,以及 vision encoder。
剩餘記憶體還必須留給 macOS、KV Cache、Context、多個 concurrent requests,以及其他服務。
因此,如果今天真的要我幫一家中小企業規劃,我會把:
48GB 視為真正的入門生產規格。
如果準備讓 2~4 位員工長期共同使用,我反而會往 64GB,甚至 128GB 評估。
原因不只是模型塞不塞得進去。
官方文件明確指出,更多記憶體代表可以容納更大的 Context,以及更多 concurrent requests;36GB Mac 能處理的 Context 與並發數會低於 48GB。
這才是企業買大記憶體真正的價值。
它不是只能聊天,Coding 才是我更看好的地方
Splash 可以提供 OpenAI Chat Completions、OpenAI Responses,以及 Anthropic Messages API,並支援 Streaming、Tool Calling、JSON Schema、圖片輸入與 inline PDF。
它甚至直接整合 OpenCode、Claude Code、Codex 與 Hermes。
所以我不會把它定位成:
「公司自己架一個 ChatGPT。」
這樣太浪費了。
我會把它定位成:
公司的 Local AI Runtime。
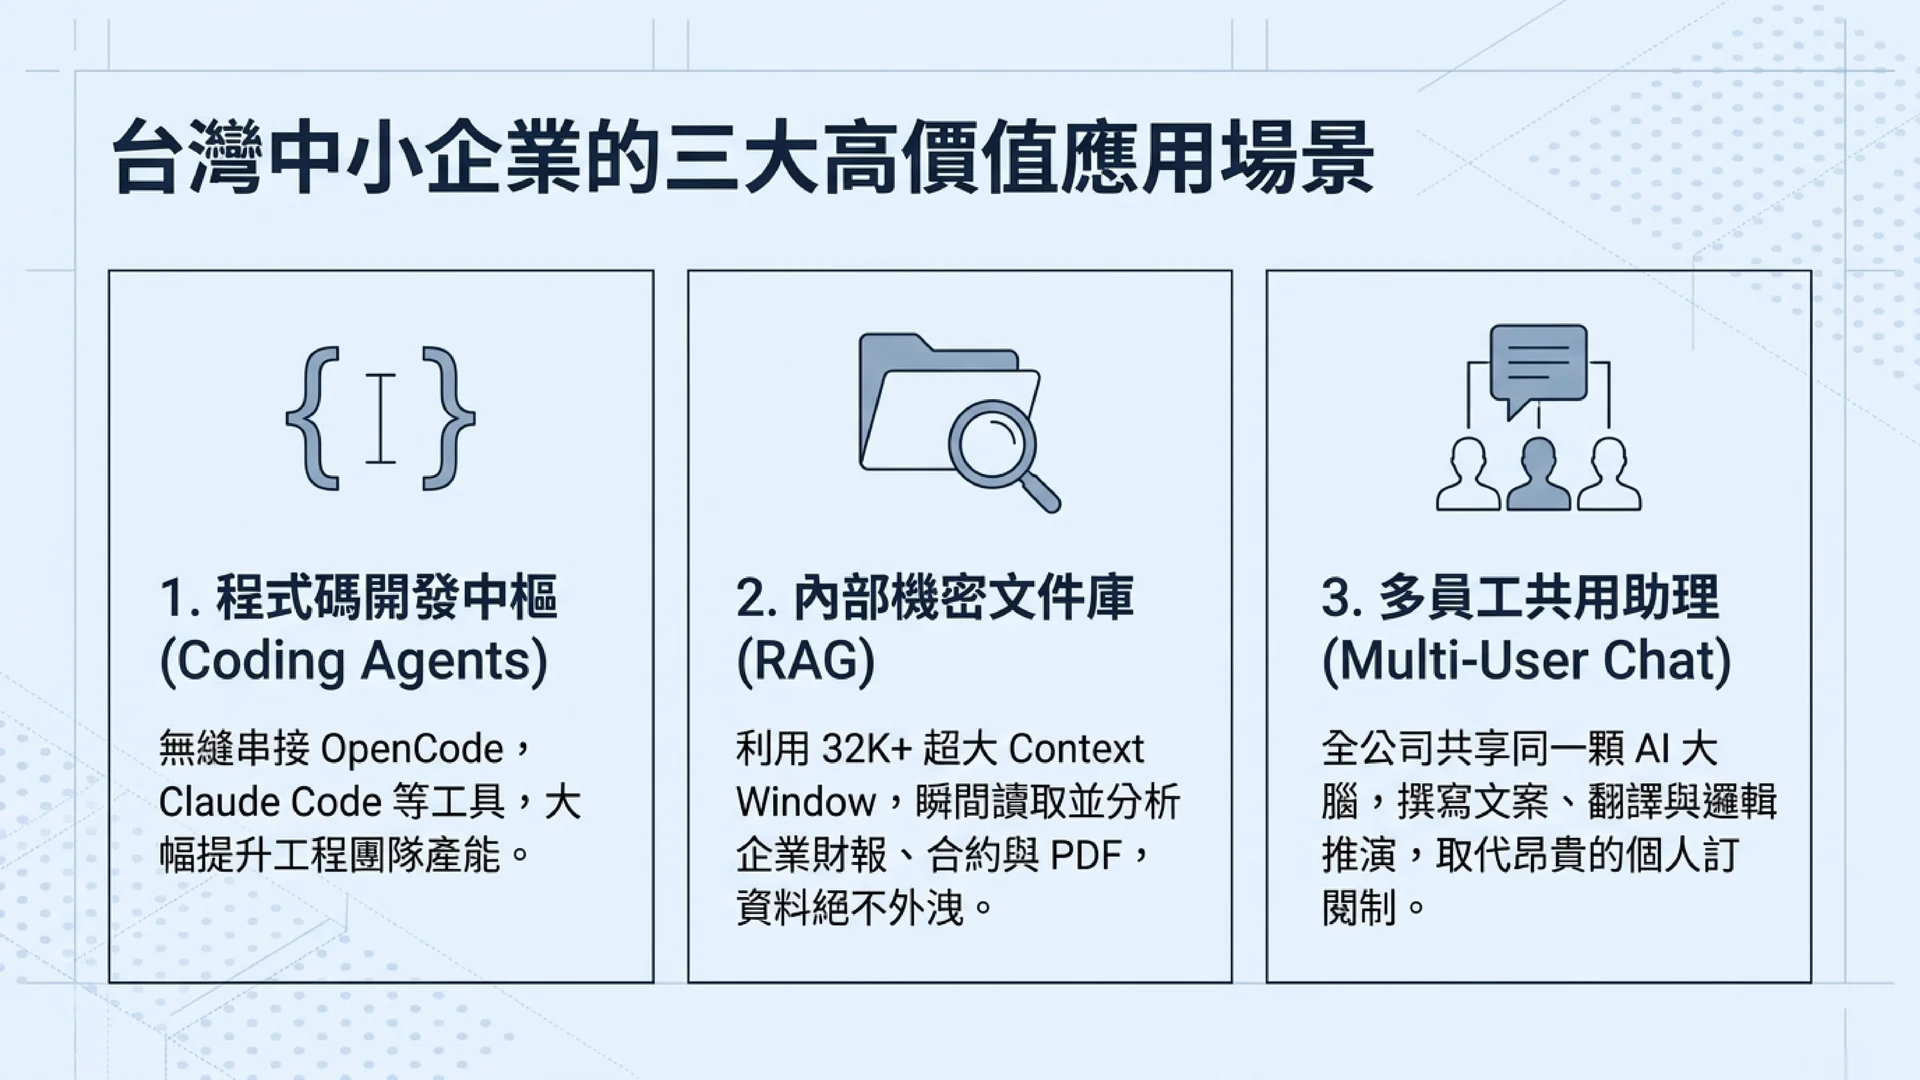
例如四位工程師的 Coding Agent,可以共同呼叫這台 Mac。
內部 RAG 系統可以呼叫它。
文件摘要系統可以呼叫它。
客服知識庫可以呼叫它。
自動化 Agent 也可以呼叫它。
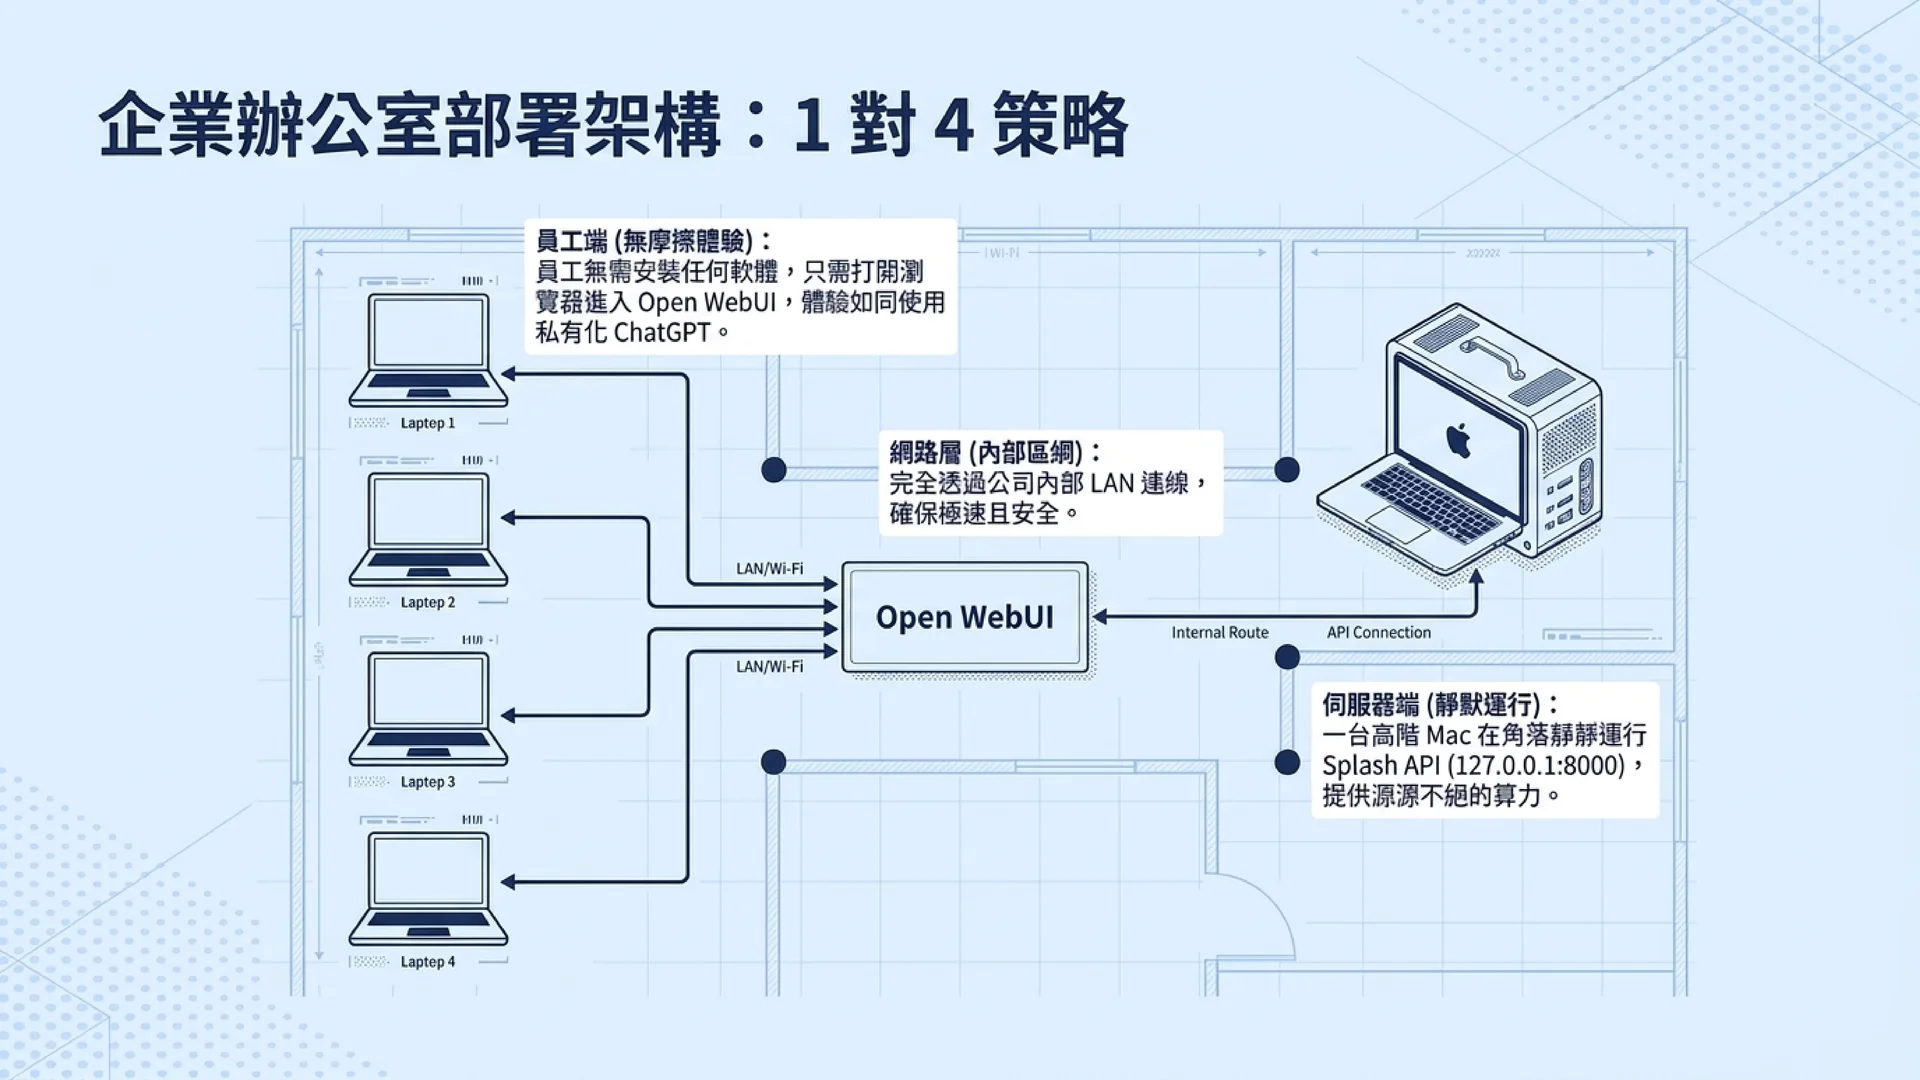
員工甚至不需要知道後面到底跑的是什麼。
前端可以是一套 WebUI,也可以直接整合公司既有 ERP、CRM、內部網站或自動化 Workflow。
員工只需要打開瀏覽器工作。
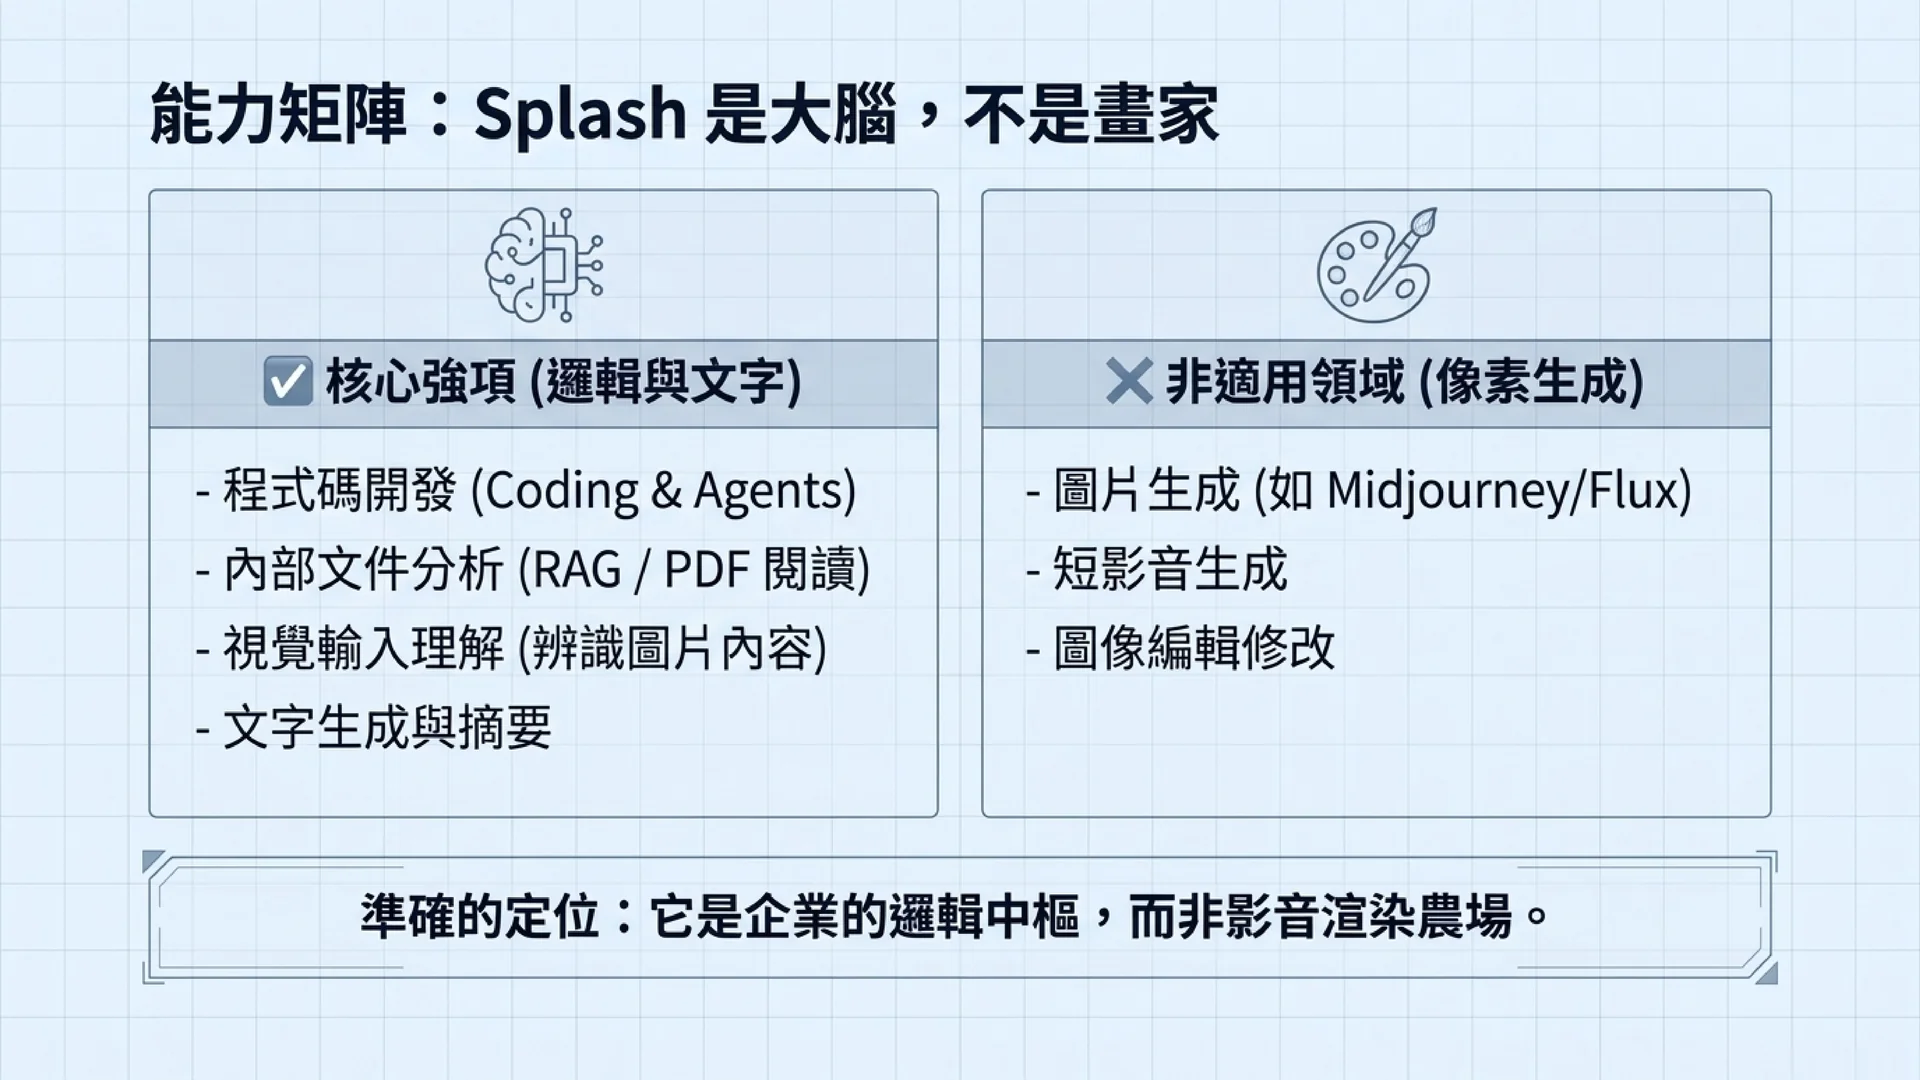
那可以拿 Splash 生圖片、做短影片嗎?
目前答案是:
不是它的工作。
Splash 可以接受圖片輸入,代表模型可以「看圖片、理解圖片」,但這和 Stable Diffusion、Flux、Qwen-Image 那種「生成圖片」完全不同。
短影片生成也一樣。
Splash 目前不是影片生成引擎。
但站在企業系統架構的角度,我反而不認為這是缺點。
因為我們本來就不應該要求一個 Runtime 把所有事情全部做完。
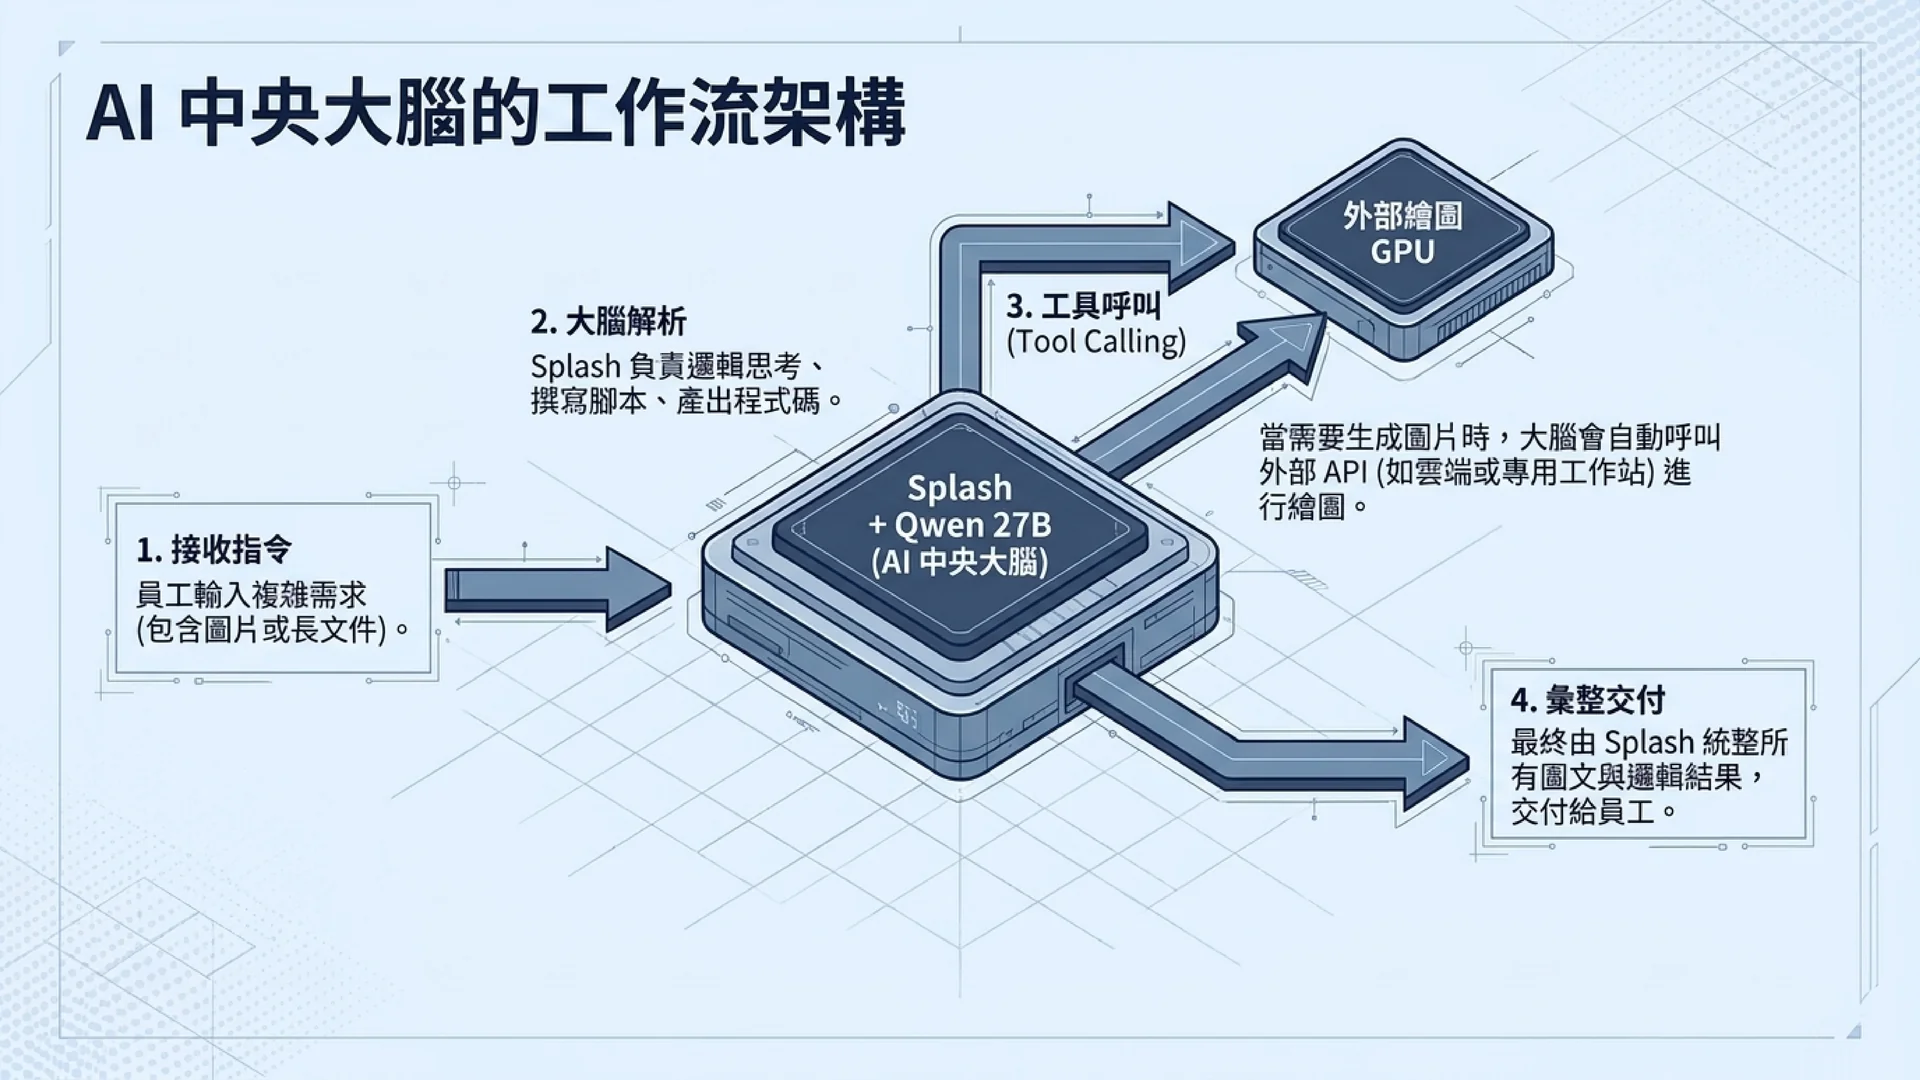
更合理的架構應該是:
Splash + Qwen 負責大腦
↓
理解需求、Reasoning、Coding、規劃工作、產生 Prompt
↓
透過 Tool Calling
↓
呼叫生圖 Server、影片 Server、資料庫、搜尋引擎、ERP、CRM 或其他 API
這才是真正的 Agent Architecture。
記憶體變大,要不要從 Q4 升到 Q8?
這也是企業採購很容易產生的迷思。
「既然我買了 128GB Mac,那是不是應該跑 Q8?」
理論上,大記憶體當然提供跑更高精度模型的條件。
但目前官方 Qwen3.8-27B-Splash Package 本身就是固定的 4-bit Target Model,不是使用者想切 Q4、Q8、BF16 就自己切換。官方也明確表示這個 Package 並不是一般 Transformers 或 MLX checkpoint,而是 Splash 專用格式。
而且 Q8 不代表效率一定更高。
Q8 最大的意義主要是降低量化造成的模型品質損失,但模型權重變大之後,需要搬動的資料也更多。
對 Unified Memory 架構來說,Memory Bandwidth 非常重要。
因此:
Q4 通常追求的是速度、記憶體效率與併發能力。
Q8 或 BF16 追求的則比較偏向模型品質。
這兩件事情不能混為一談。
Splash 現在倒是允許把 KV Cache 從預設 INT8 改成 BF16,但官方特別提醒,這會使用大約兩倍 Target KV Memory,而且在 Long Context 下可能更慢;模型權重本身也不會因此從 Q4 變成 BF16。
所以站在 Production 的角度,我不會因為機器有 128GB,就盲目追求 Q8。
我會先問:
這家公司到底需要更高精度,還是需要四個員工同時工作?
答案不同,硬體配置就完全不同。
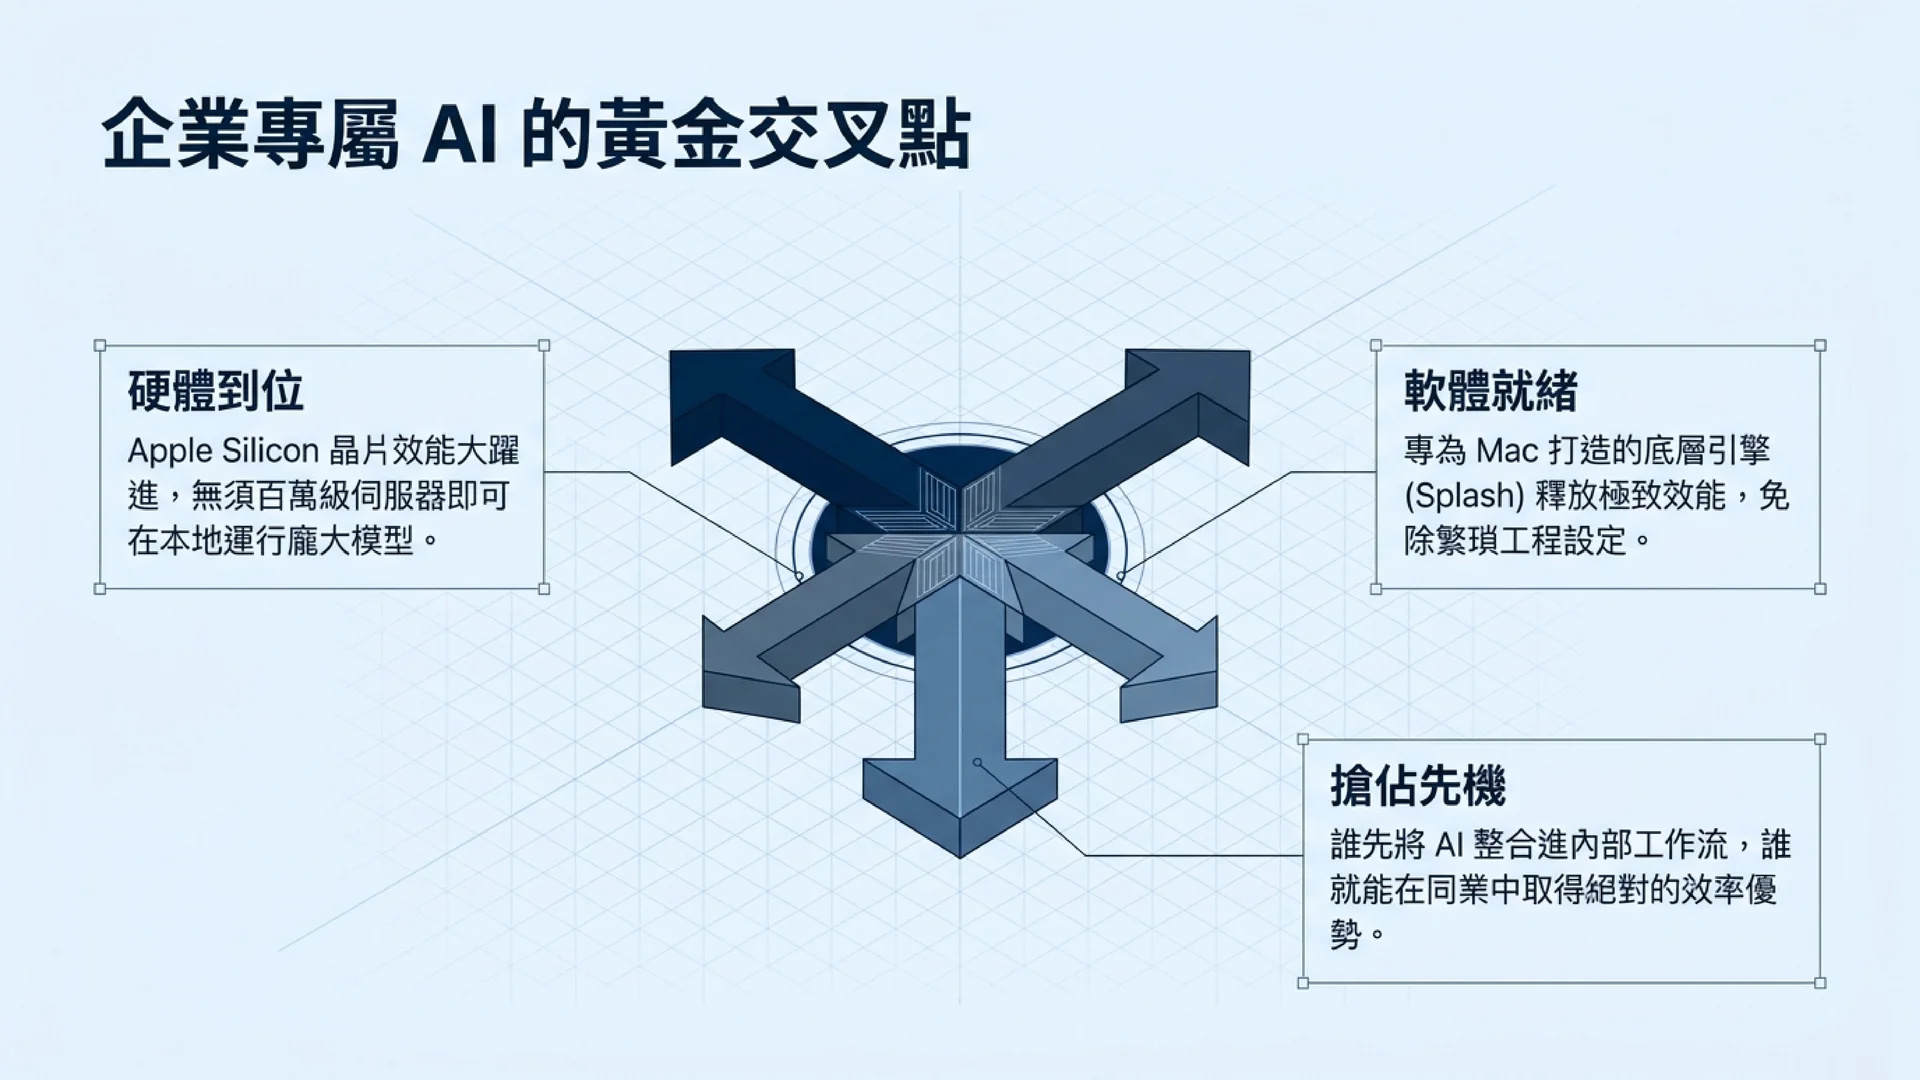
Splash 真正改變的是中小企業導入 Local AI 的門檻
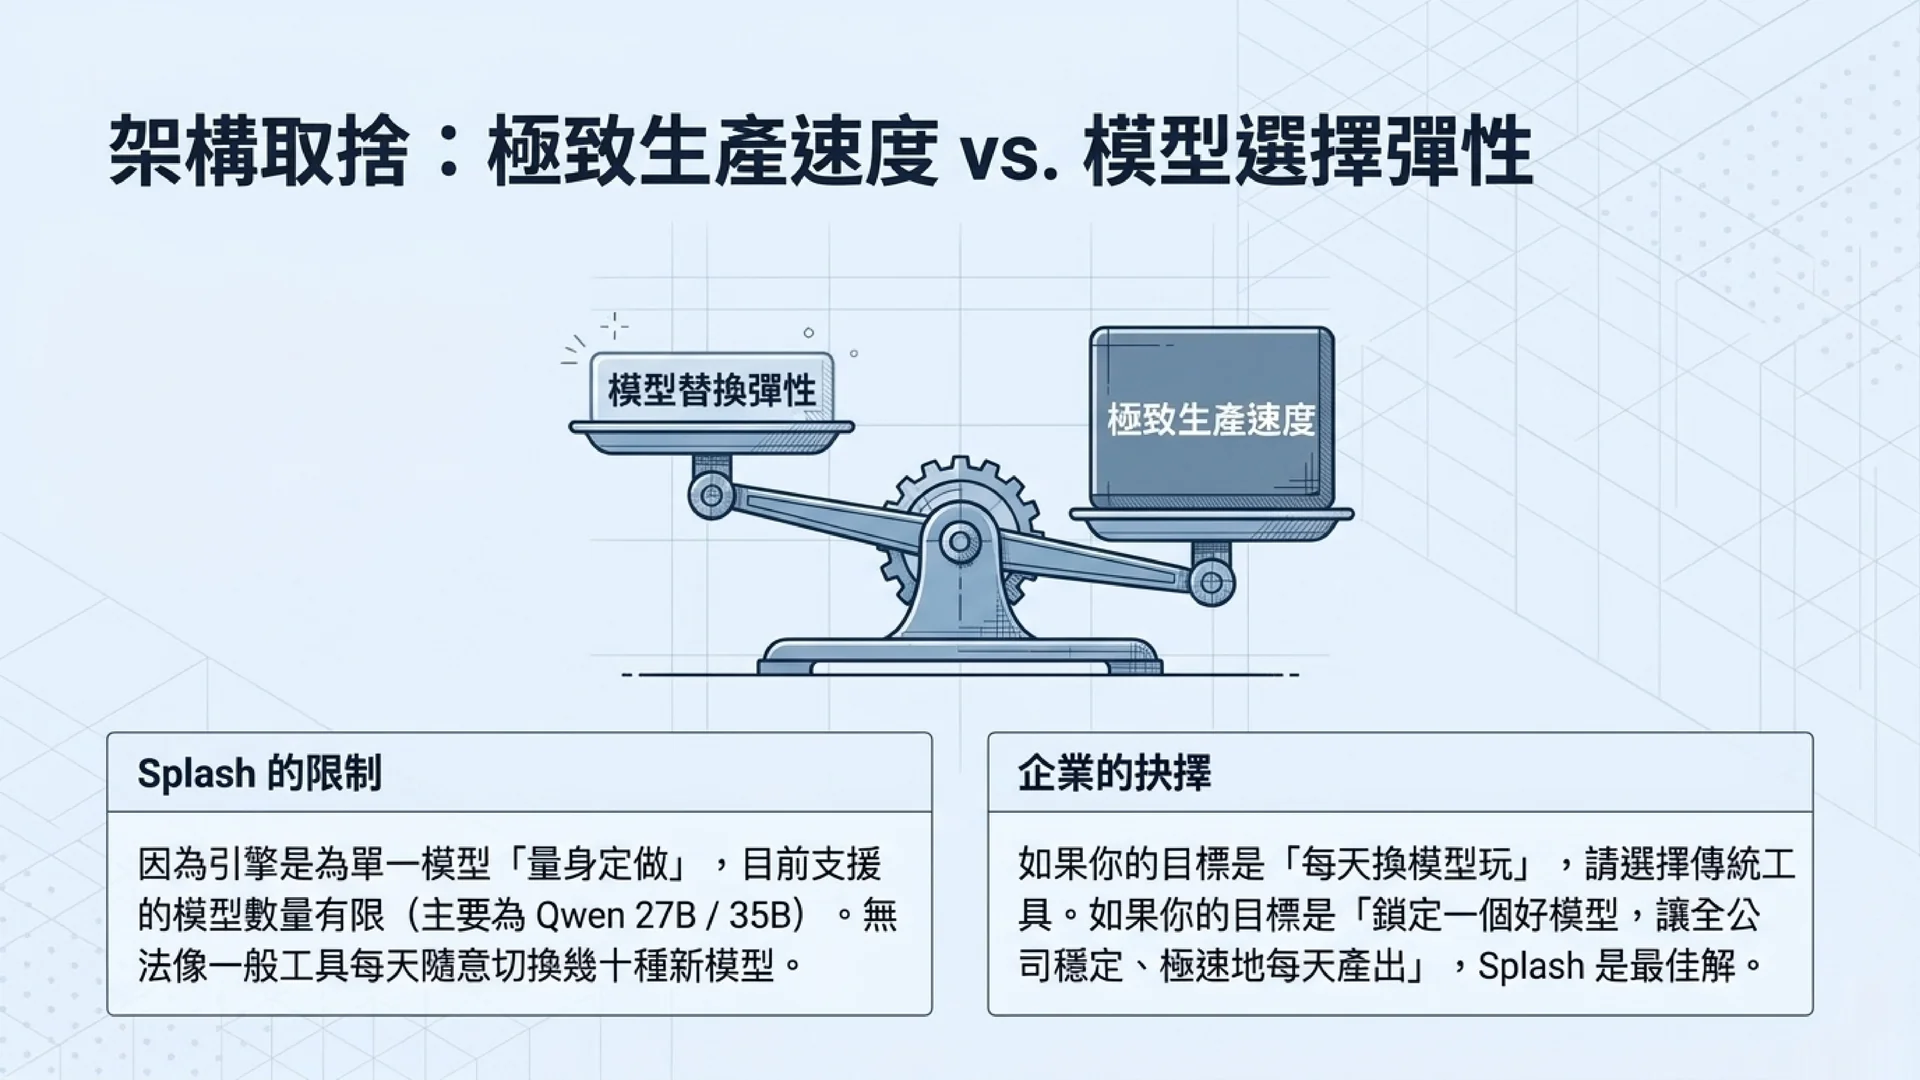
我認為 Splash 現階段最大的問題也非常明顯:
支援模型還太少。
目前官方主要提供 Qwen3.8-27B-Splash 與 Qwen3.6-35B-A3B-Splash。
如果企業需要經常更換模型,那 Ollama、MLX、llama.cpp 等通用型生態仍然更有彈性。
但如果今天是一家公司準備正式部署:
模型已經選定。
工作流程已經固定。
每天都會大量使用。
這時候 Splash「針對模型打造引擎」的缺點,反而可能變成優點。
因為 Production 最終追求的從來不是「可以玩多少模型」。
而是:
穩不穩、快不快、多少人可以一起用,以及 IT 部門到底要花多少時間維護。
這也是我認為 Splash 最值得關注的地方。
過去講到企業地端 AI,大家想到的是機房、Linux Server、GPU、CUDA,以及昂貴的專業顯示卡。
但是現在另一條路正在逐漸成形:
一台大記憶體 Apple Silicon Mac,放在辦公室角落,接上網路,24 小時開著。
兩個、三個、四個員工透過瀏覽器或 API 使用。
員工根本不用知道模型放在哪裡。
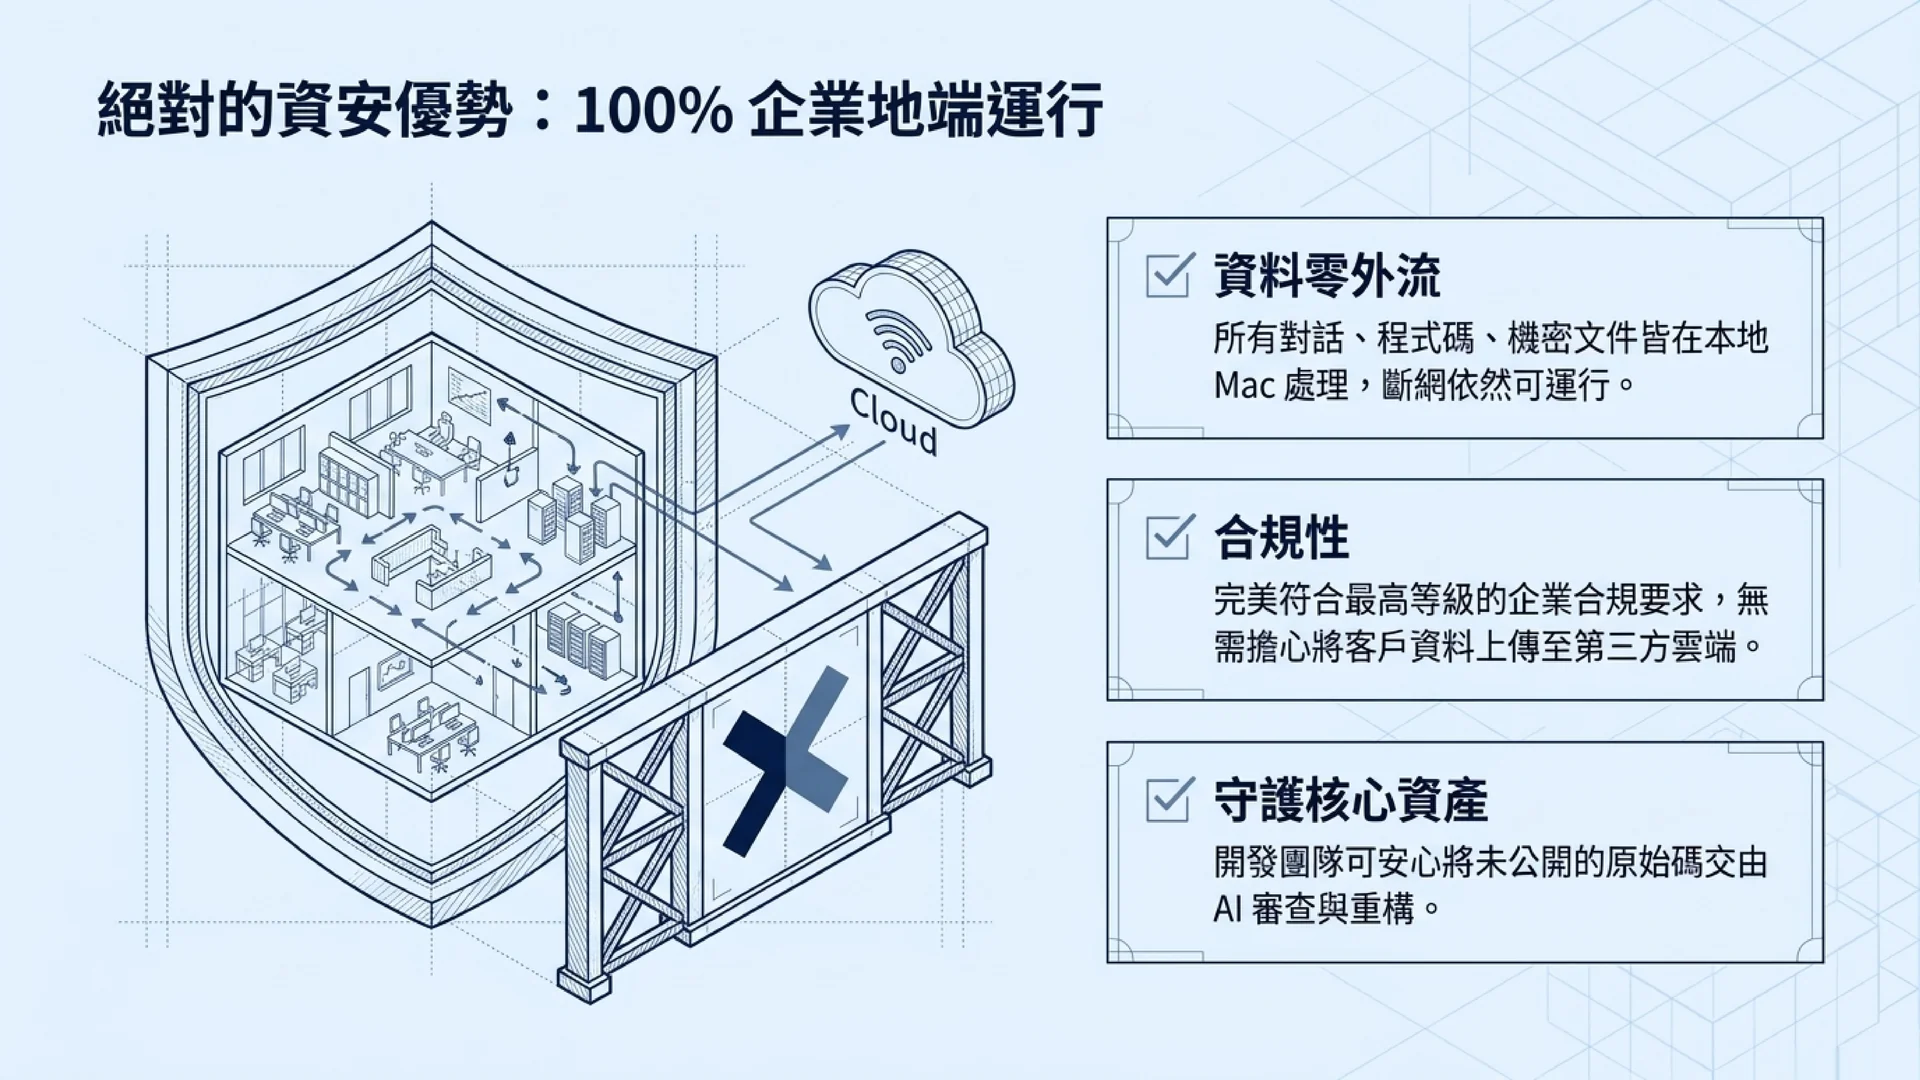
公司的文件、程式碼與內部資料也不必為了每一次推論全部送到外部模型供應商。
對我來說,這才是 Splash 真正值得觀察的地方。
它不只是讓 Qwen3.8-27B 從十幾個 tok/s 跑到五十、七十個 tok/s。
真正重要的是:
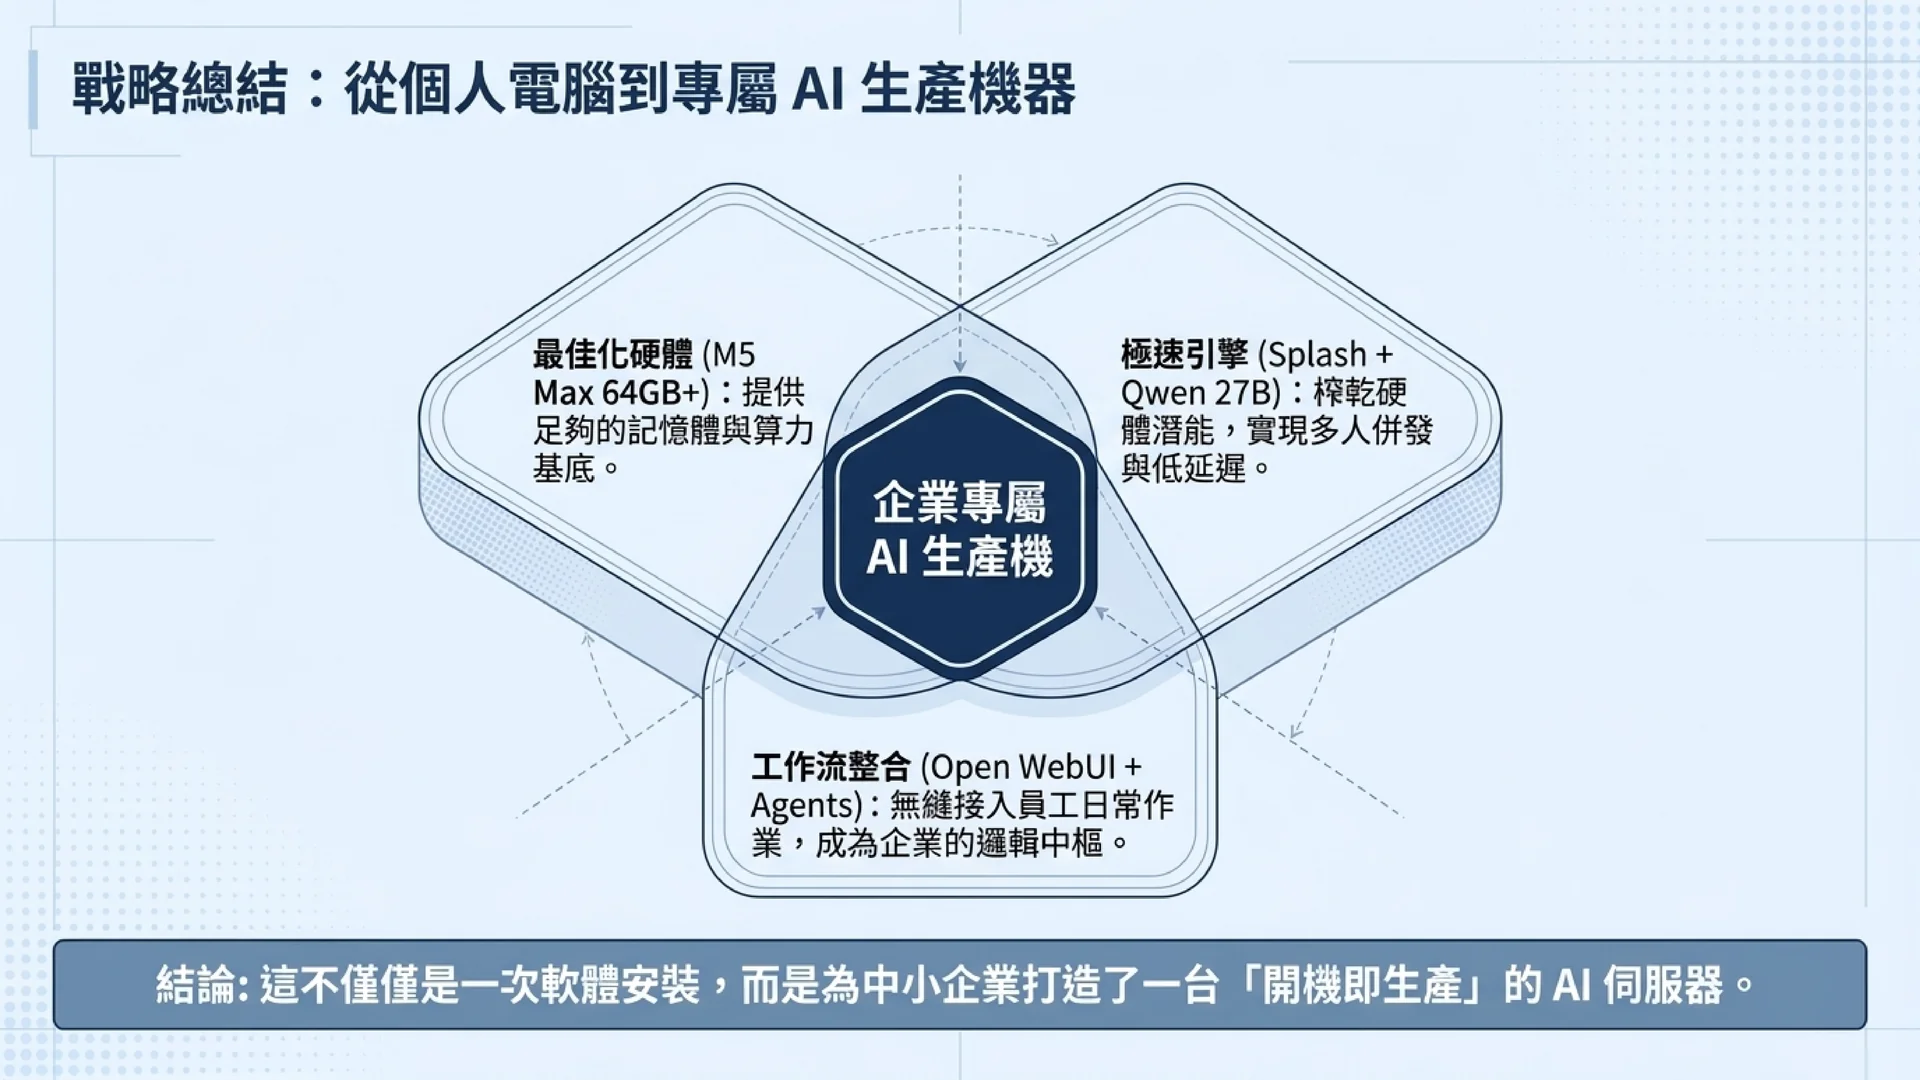
Mac 正在從「工程師桌上的 AI 實驗機」,逐漸變成一台可以認真討論 Production 的小型 AI Server。
而一旦 Local AI 的部署複雜度真的降低到:
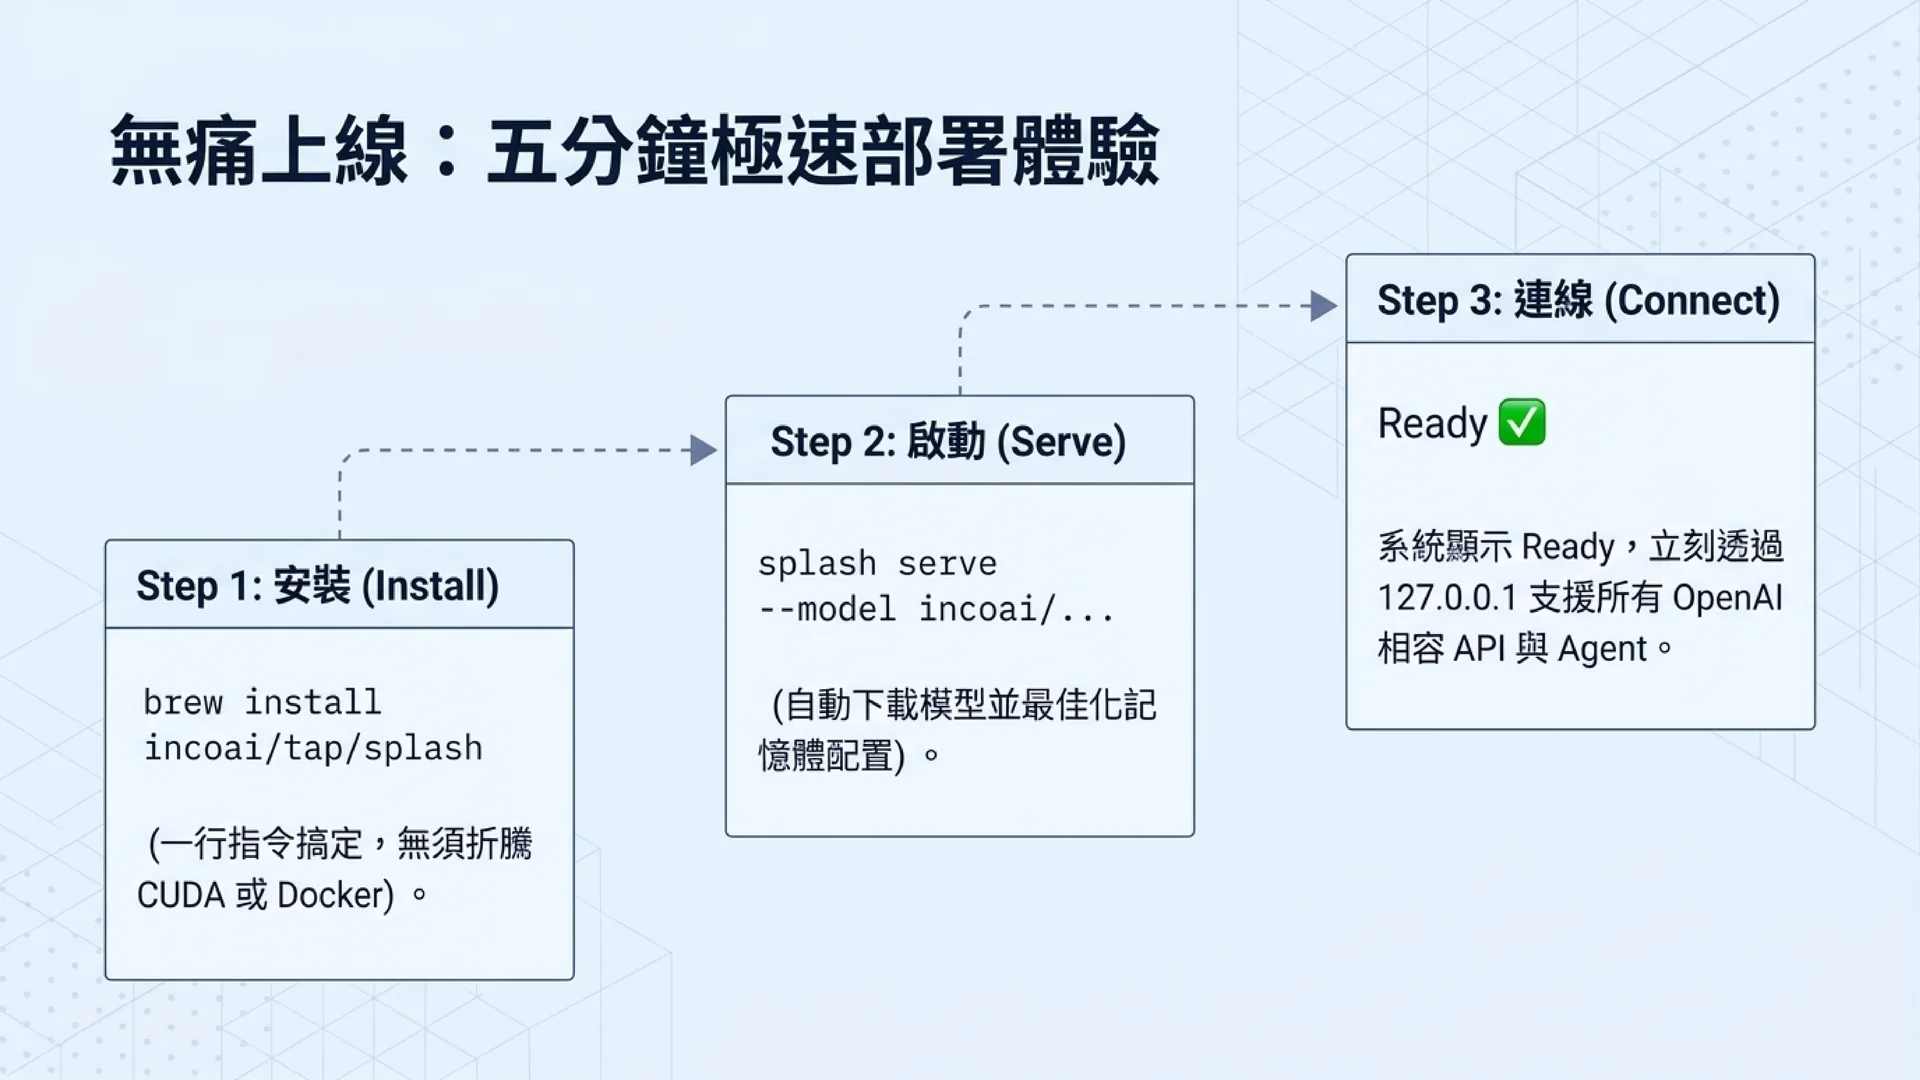
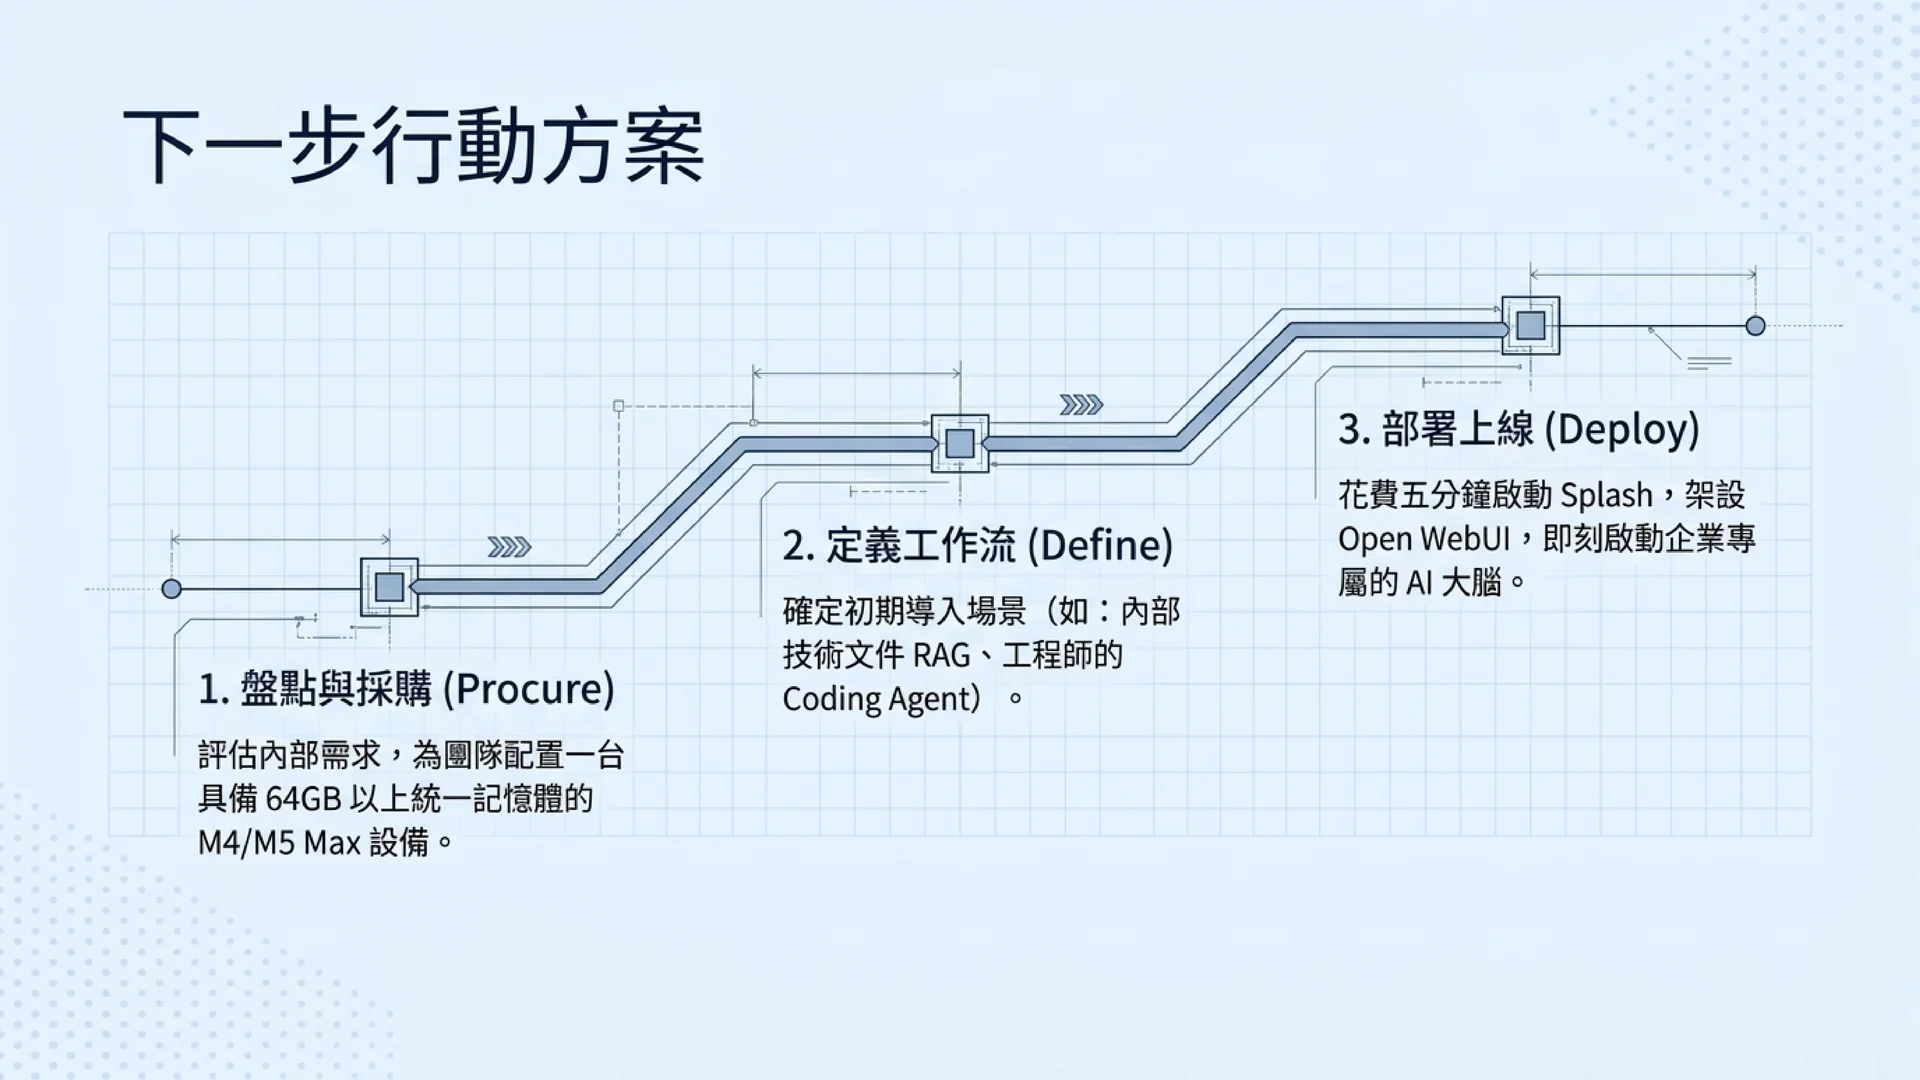
安裝軟體、下載模型、啟動 API,然後全公司開始使用——
那麼下一波 Local AI 的競爭,可能就不再只是:
「誰的模型比較強?」
而會變成:
「誰能把 AI 做成一台企業買回去,開機就能開始生產的設備?」
這件事情,我認為才剛剛開始。