作者:阿中哥 + AI 協助彙整。 【本文約有4354字】
AI 發展六大階段:從工具、代理到自我進化,下一波商機與風險在哪裡?
從生成式 AI、企業與個人 Agent,到機器人、自動駕駛、邊緣 AI 與 RSI;看懂技術演進,也看懂資安、算力和產業轉型。
發布日期:2026 年 11 月 6 日|閱讀時間:約 12–16 分鐘
前言:我們可能還站在 AI 革命的前半場
2022 年底,許多人第一次接觸 ChatGPT,驚訝於電腦竟然能以自然語言回答問題。幾年後,AI 已不只是聊天工具:它能修改程式、生成影片、整理文件、執行工作流程,甚至逐漸走進汽車、工廠和家庭。當我們還在討論哪個模型回答得比較好,另一個問題已經浮現:當 AI 開始替人類採取行動,社會和商業會發生什麼改變?
在《矽谷101》年度線下大會的討論中,GMI Cloud CEO Alex 提出一個值得關注的觀察:市場已經看見 AI Coding 與多模態內容帶來的算力需求,但機器人、消費端應用,以及未來可能出現的遞迴自我改進(RSI),仍可能帶來新一輪成長。他也預測,算力供應緊張的情況可能持續到 2030 年。這是他的產業判斷,並非已經確定的事實。
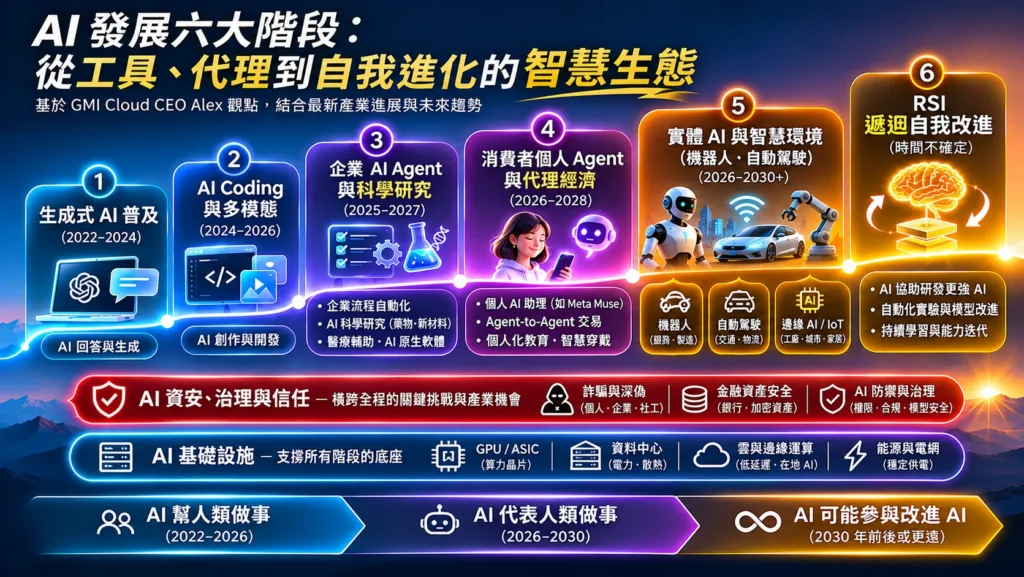
如果把這些觀點與當前的技術發展放在一起,我們可以整理出一張「AI 發展六大階段」的路線圖。要先說明:這六階段是為了理解趨勢而建立的分析框架,不是 Alex 親自公布的六階段理論,也不是每個階段都會依照日期準時發生。 許多技術其實同時進展,時間範圍僅供觀察。
第一階段:生成式 AI 普及(2022~2024)——從搜尋答案到直接生成內容
第一階段最重要的改變,是一般人不再需要學習複雜指令,也能使用先進的人工智慧。過去要完成一份報告,可能得搜尋資料、閱讀多個網站、整理筆記,再自己撰寫;現在只要提出需求,AI 就能先產生草稿,協助摘要、翻譯、分類與改寫。
這並不代表 AI 產出的內容一定正確。它可能誤解問題、混淆資料來源,甚至產生看似合理卻不存在的資訊。因此,這個階段真正成熟的工作方式,不是「把判斷全部交給 AI」,而是讓 AI 負責初步整理,人類負責查核、決策與品質把關。
對中小企業來說,生成式 AI 的門檻下降,意味著客服常見問題、商品文案、教育教材與內部知識整理,都有機會用更低成本完成。它首先改變的是個人的工作效率,也為後面的自動化奠定基礎。
第二階段:AI Coding 與多模態(2024~2026)——AI 開始創造可直接使用的成果
第二階段,AI 不再只是輸出文字,而是進一步參與程式開發、圖片、聲音與影片製作。像 Claude Code、Codex 等 Coding Agent,已經能在授權環境內閱讀程式碼、修改檔案、執行測試,協助開發者處理一連串任務。對工程師而言,角色開始從「每一行都自己寫」,轉變為「描述需求、設計架構、檢查成果」。
多模態 AI 也讓內容產業產生明顯變化。過去製作影片,需要分別處理腳本、旁白、字幕、圖片與剪輯;如今其中不少環節都能交給 AI 協助。對經營自媒體、教育訓練或地方品牌的業者來說,原本負擔不起的製作流程,開始變得可行。
但成本下降不等於競爭消失。當大家都能快速生成內容,真正稀缺的反而是可信的資訊、獨特的觀點、穩定的品質與持續經營的品牌。企業不能只問「AI 能不能幫我做」,還要問「做出來之後,客戶為什麼要選擇我」。
第三階段:企業 AI Agent 與科學研究(2025~2027)——從回答問題走向執行任務
第三階段的關鍵字是 Agent,也就是「代理」。一般聊天機器人通常在收到問題後產生答案;Agent 則能在設定好的目標、工具與權限範圍內,連續執行多個步驟。例如接到「檢查網站安全狀態」的任務後,它可以讀取日誌、整理異常、比對設定、提出修補建議,再產生報告。
企業導入 Agent 的價值,不只在於少打一份報告,而是把原本分散在不同系統的工作串起來。客服、行政、資訊維運、銷售、教育訓練等流程,都可能受影響。未來還可能出現多個 Agent 分工合作:一個負責資料蒐集、一個執行分析、一個進行測試,最後交由人類確認。
這個階段還應納入AI 科學研究。AI 可以協助分析研究資料、提出候選方案、撰寫實驗程式,並在藥物、新材料、工程設計等領域加速探索。它與一般企業流程自動化不同,但共同特徵都是:AI 不再停留在「回答」,而是參與有步驟、有驗證的工作。
必須注意,企業 Agent 不能因為效率高就擁有無限制權限。涉及刪除資料、變更伺服器設定、匯款或對外發布資訊時,應採用最小權限、操作紀錄、人工審核與可回復機制。AI 越能做事,權限治理就越重要。
第四階段:消費者個人 Agent 與代理經濟(2026~2028)——每個人可能都有自己的數位助理
當企業開始使用 Agent,下一個值得關注的市場,就是一般消費者。想像你告訴個人 AI:「下週安排一趟兩天一夜的旅行,交通方便,預算不要超過一萬元。」它不只是列出景點,而是進一步比較方案、查詢行程、整理住宿選項,並在取得授權後協助完成預訂。
這類個人 Agent 的真正價值,是能理解使用者的偏好,持續追蹤尚未完成的事情,並在不同服務之間協調。它可能出現在手機、電腦、智慧眼鏡或其他隨身裝置裡。個人化教育、生活管理、購物比價、健康資訊整理,都是潛在應用。
更深一層的改變,是 Agent-to-Agent(代理對代理)經濟。例如消費者的 AI Agent 要找日文課程,不一定先開搜尋引擎,而是直接向教育機構的 AI 服務查詢課程、費用、上課時間與名額,再整理出可比較的選項。未來企業除了提供給人類閱讀的網站,還可能需要提供讓 AI 能理解、查詢與使用的服務介面。
不過,代理經濟仍有幾個難題:使用者是否願意交出購買決策?AI 如何辨別不實資訊?交易出錯誰負責?付款、個資和授權如何管理?因此,個人 Agent 的普及不只取決於模型聰不聰明,更取決於信任機制是否建立。
第五階段:實體 AI 與智慧環境(2026~2030 年及以後)——AI 開始進入真實世界
第五階段最容易看見的代表,是機器人與自動駕駛。但如果只談這兩項,就會忽略另一個重要方向:邊緣 AI(Edge AI)與物聯網(IoT)。
機器人:從固定動作走向適應環境
傳統工業機器人擅長在固定環境裡重複工作。新一代 AI 機器人則嘗試結合視覺、語言與動作規劃,理解不同物品和場景。未來在物流、倉儲、工廠、清潔與照護輔助等領域,機器人可能承擔更多變化較大的工作。但「會示範一項任務」與「能安全、穩定地在所有家庭工作」之間,仍有很長距離。
自動駕駛:AI 必須承擔現實世界的風險
自動駕駛與文字生成最大的不同,是錯誤可能立即造成實體傷害。它需要處理感測器資訊、道路規則、行人與車輛動態,也必須在不確定情境下做出即時判斷。不同等級的駕駛輔助與自動駕駛能力不能混為一談;特定地區、特定條件下的無人駕駛服務,也不代表所有道路都已能完全自動駕駛。
從產業角度看,交通、物流、車隊管理、保險與道路基礎設施,都可能隨著自動駕駛成熟而改變。
邊緣 AI 與 IoT:智慧不必全部放在雲端
過去我們談 AI,經常想到大型資料中心。但工廠攝影機、智慧門鎖、環境感測器、車載電腦和家用設備,不可能每次都等待遠端伺服器回應。部分 AI 推論可以直接在裝置端或附近的邊緣伺服器執行,以降低延遲、減少網路依賴,並在適當設計下減少敏感資料外傳。
例如工廠可以在產線旁偵測設備異常;智慧城市可分析交通流量;家庭設備能在本地辨識特定事件;醫療與照護場景也可能利用感測器及邊緣推論提供提醒。這些應用不一定需要最大的模型,反而更重視反應速度、穩定性、耗電量、成本與隱私保護。
因此,第五階段的真正名稱,應該是「實體 AI 與智慧環境」,而不只是「機器人時代」。
第六階段:RSI 遞迴自我改進(時間不確定)——當 AI 開始參與改進 AI
RSI 是 Recursive Self-Improvement 的縮寫,中文可譯為「遞迴自我改進」。概念上,它指的是 AI 系統不僅能執行人類指定的工作,還能參與改善自身或後續 AI 系統的能力,並形成持續改進的循環。
Alex 在演講中提到,部分研究人員認為這類重大進展可能在六個月至兩年內出現。他因此推論,如果 AI 能更自主地進行訓練與研究,算力需求可能進一步增加。這是一個值得觀察、但高度不確定的預測。
我們必須區分三件事情:AI 幫工程師寫訓練程式、AI 自動執行研究實驗,以及 AI 能夠可靠地遞迴提升自身能力,並不是同一個層次。前兩者已經有實際應用;第三者能否形成穩定、可驗證且持續的能力成長,仍有技術與安全問題尚待解決。
如果未來真的出現更強的自主研究循環,模型研發速度、算力需求和產業競爭都可能改變。但在今天,與其把 RSI 當成必然發生的時間表,不如把它當成需要持續驗證的重要研究方向。
橫跨六階段的第一條主軸:AI 資安、治理與信任
談 AI 發展,不能只看效率和商機。生成式 AI 已經讓假訊息、深偽影像、聲音冒充與社交工程詐騙更容易大量製作;具備工具操作能力的 Agent,也可能被用於加速弱點搜尋、惡意腳本編寫或其他網路攻擊。
金融領域尤其敏感。銀行與支付機構的核心責任之一,是保護客戶資產。當攻擊者結合 AI 冒名、釣魚、帳號盜用或交易欺騙,可能造成重大損失。不過,不能把每一起銀行資產遭竊事件都直接認定為 AI 所致;是否使用 AI、攻擊如何發生,仍需依據個案調查與可信證據判斷。
另一面,AI 也能協助防禦:分析異常登入、偵測可疑交易、比對安全日誌、輔助漏洞修補,以及辨識冒名詐騙訊號。未來可能出現攻擊端與防禦端都大量使用 AI 的局面。
因此,從第一階段到第六階段,都需要資料保護、身分驗證、最小權限、人工覆核、稽核紀錄、模型安全與法規治理。AI 安全不是某個階段才開始的問題,而是伴隨整個發展過程的必要條件。
橫跨六階段的第二條主軸:AI 算力與基礎設施
AI 的能力再強,也需要實際的運算資源支撐。大型模型訓練、即時推論、影片生成、多代理工作流程,以及未來的機器人應用,對 GPU、ASIC、記憶體、網路、資料中心與電力系統提出不同需求。
這也是 GMI Cloud CEO Alex 的觀點值得注意的原因。他關注的不只是模型本身,而是當 AI 從偶爾回答問題,變成長時間執行任務時,推論需求可能如何增加。尤其 Agent 會反覆規劃、呼叫工具、檢查結果,單一使用者背後的運算量可能大幅提高。
然而,算力需求成長不等於每一家算力供應商都能獲利。晶片效率提升、模型壓縮、價格競爭、電力成本、設備折舊與客戶需求變化,都會影響產業經濟性。企業在選擇雲端或本地部署時,也必須比較使用頻率、資料敏感度、延遲、維護能力與總持有成本。
此外,邊緣 AI 的興起提醒我們:未來不是所有 AI 都會集中在雲端。大型資料中心與本地、邊緣運算,很可能是互補而非完全取代的關係。
對中小企業而言,現在最值得做的三件事
面對六大階段,中小企業不必急著追逐每個熱門名詞。更實際的做法,是先把企業真正需要解決的問題找出來。
第一,整理可信的企業知識。 包括產品規格、價格、服務流程、常見問題、售後規則與聯絡方式。這些資料不僅能服務今天的客服 AI,未來也可能成為企業 Agent 對外提供資訊的基礎。沒有可靠資料,再先進的模型也很難提供可信服務。
第二,挑選一個可量化的流程導入 Agent。 例如每日報表、網站巡檢、客服分類、教材製作或訂單整理。先設定成功率、節省時間、錯誤率與人工覆核成本,再決定是否擴大。自動化的目標不是讓流程看起來很先進,而是讓它更快、更穩定、更值得投入。
第三,把資安與權限設計放在最前面。 特別是涉及客戶資料、金融交易、伺服器管理和外部 API 的系統,應預先規劃存取控制、備份、稽核、金額限制與人工確認。AI 能幫忙做的事越多,企業越需要知道它「可以做什麼、不能做什麼、做錯了怎麼辦」。
結語:AI 的下一場競爭,不只是誰的模型更聰明
回頭看這六個階段,我們可以看到一條清楚的演進路徑:AI 幫人類做事,逐漸走向 AI 代表人類做事;更長遠的未來,AI 甚至可能參與改進 AI。
第一、第二階段讓我們看見生成式 AI 的能力;第三、第四階段開始重塑企業與個人的工作方式;第五階段把智慧帶進車輛、工廠、城市與家庭;第六階段則提出一個尚未得到完整驗證、但可能深刻影響未來的研究方向。
真正值得關注的,不只是模型排名或單次生成速度,而是AI 能否可靠地連接資料、理解需求、採取行動,並在安全、成本與責任都可控的情況下,持續創造價值。
對企業來說,現在不必等待 RSI 或通用機器人真正成熟才開始準備。從整理資料、導入流程自動化、建立安全防線,到讓服務更容易被個人 Agent 找到與理解,每一步都可能成為未來競爭力的一部分。
AI 的六大階段不是一張預言表,而是一張幫助我們判斷「下一步該準備什麼」的地圖。
參考與說明
- 《矽谷101》年度線下大會:〈「只要敢借,就有人敢贷」:聊数据中心融资、电力、算力与泡沫〉,影片:https://www.youtube.com/watch?v=xzc99JOBMlY
- 本文六階段分類、預估年份、企業應用案例與跨階段主軸,是依據該場討論及 AI 產業發展所做的延伸整理;並非 GMI Cloud 官方路線圖。
- 關於 RSI、機器人普及與 2030 年算力供需的描述,屬於趨勢推估,應隨技術與市場證據更新。
投影片補充