最近 Local LLM 社群出現了一組很值得注意的數據。
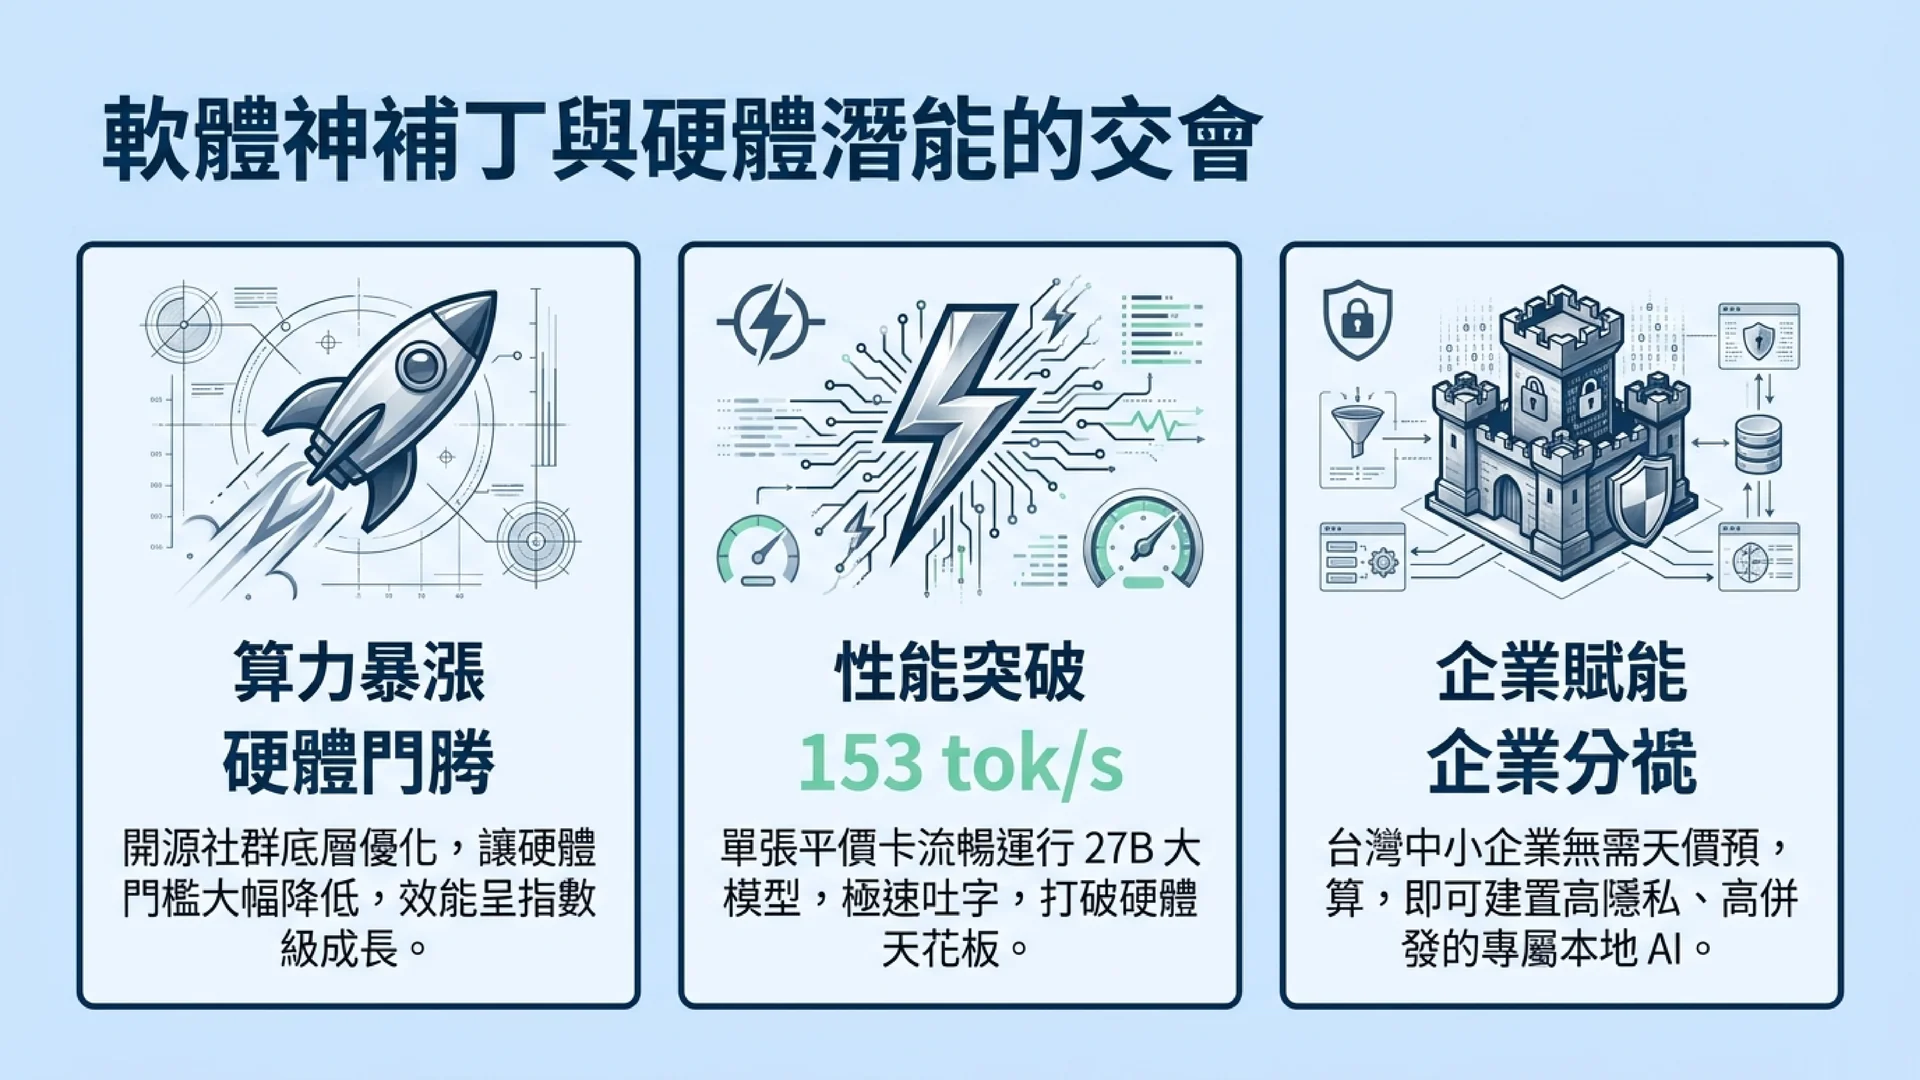
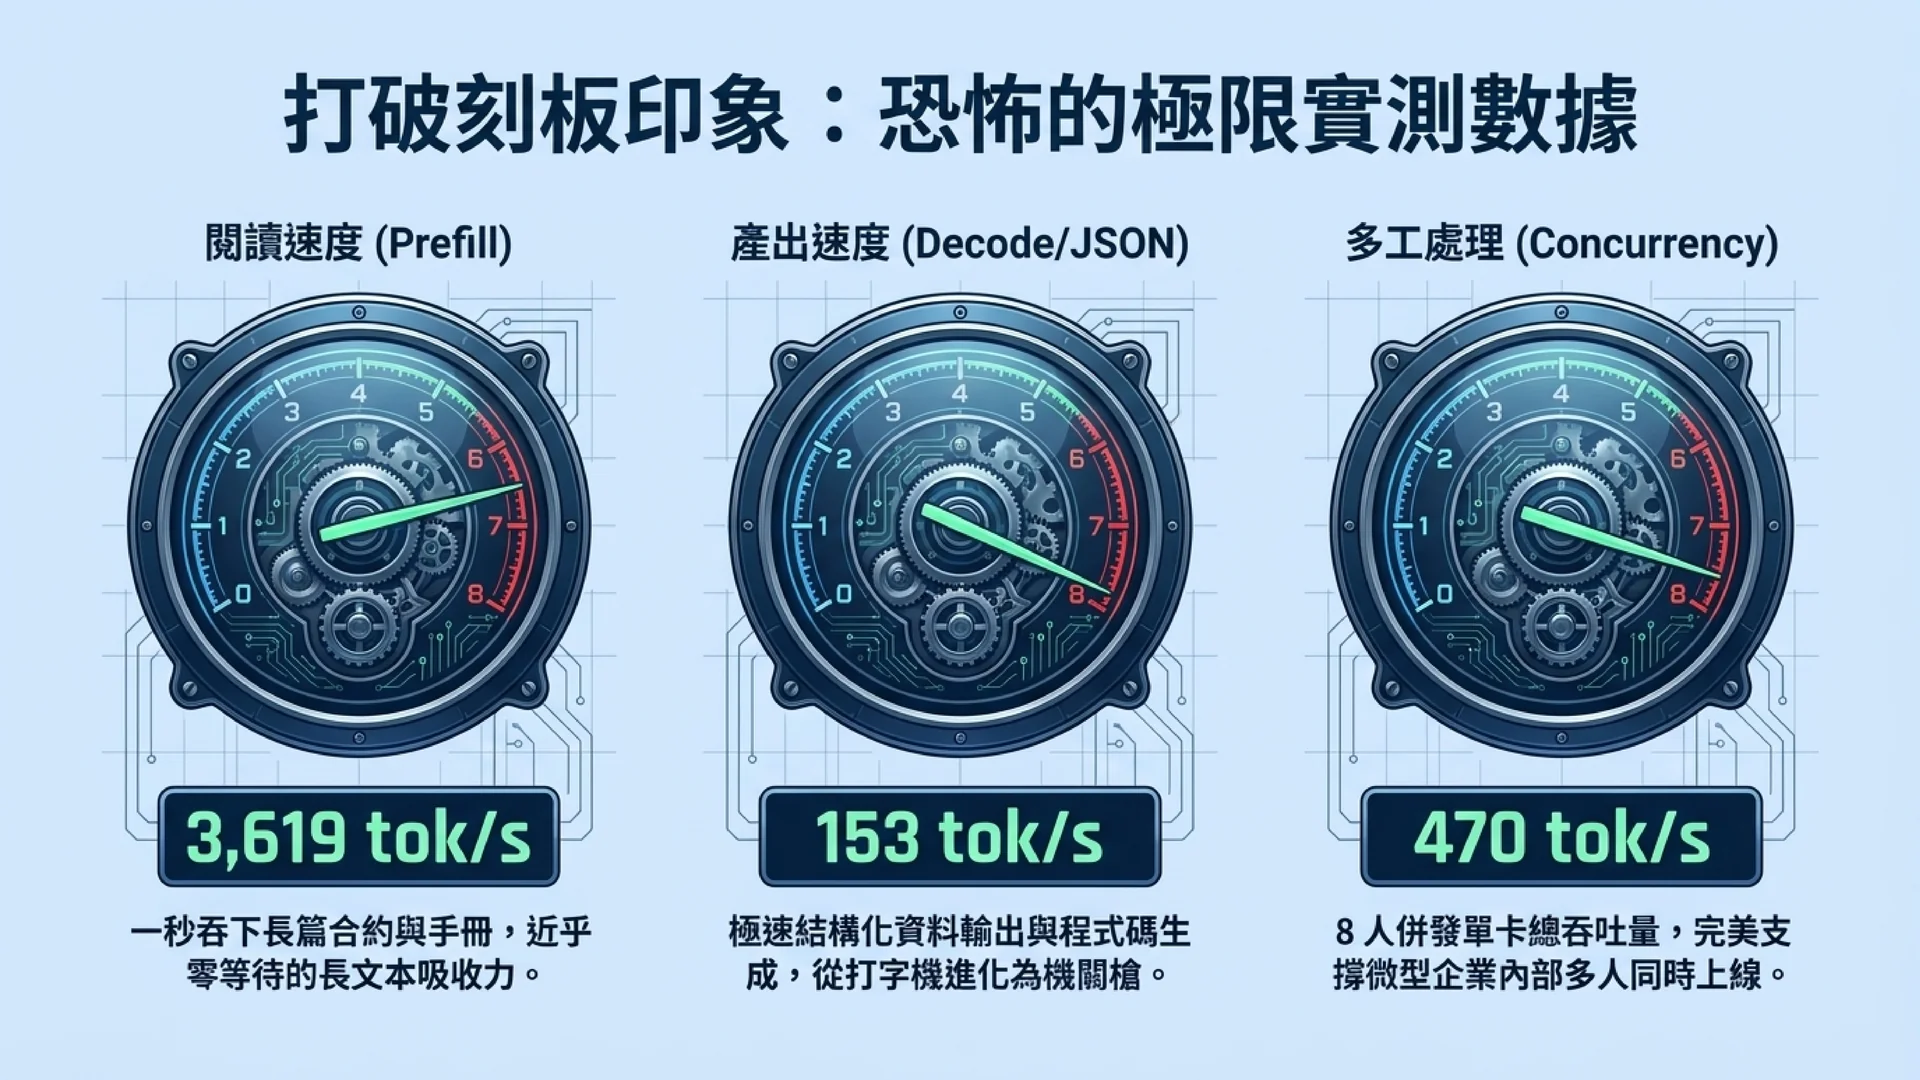
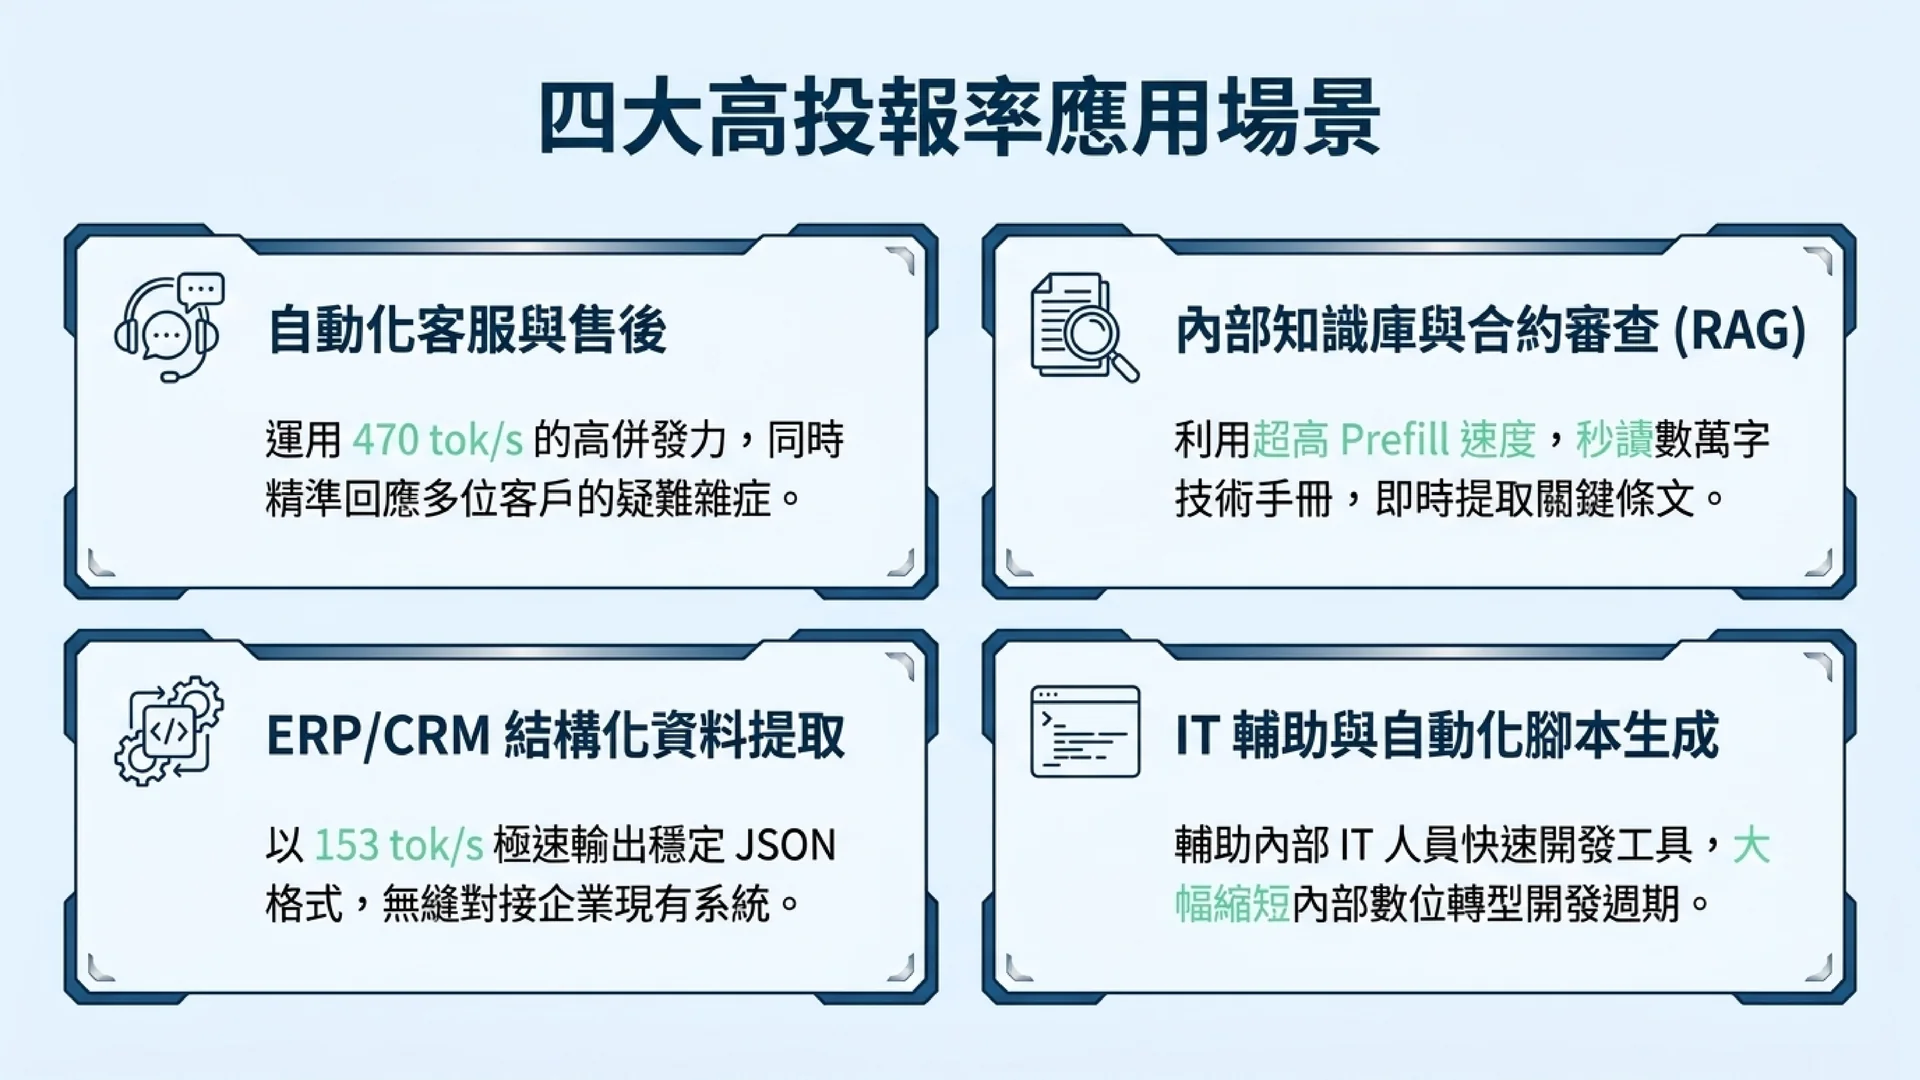
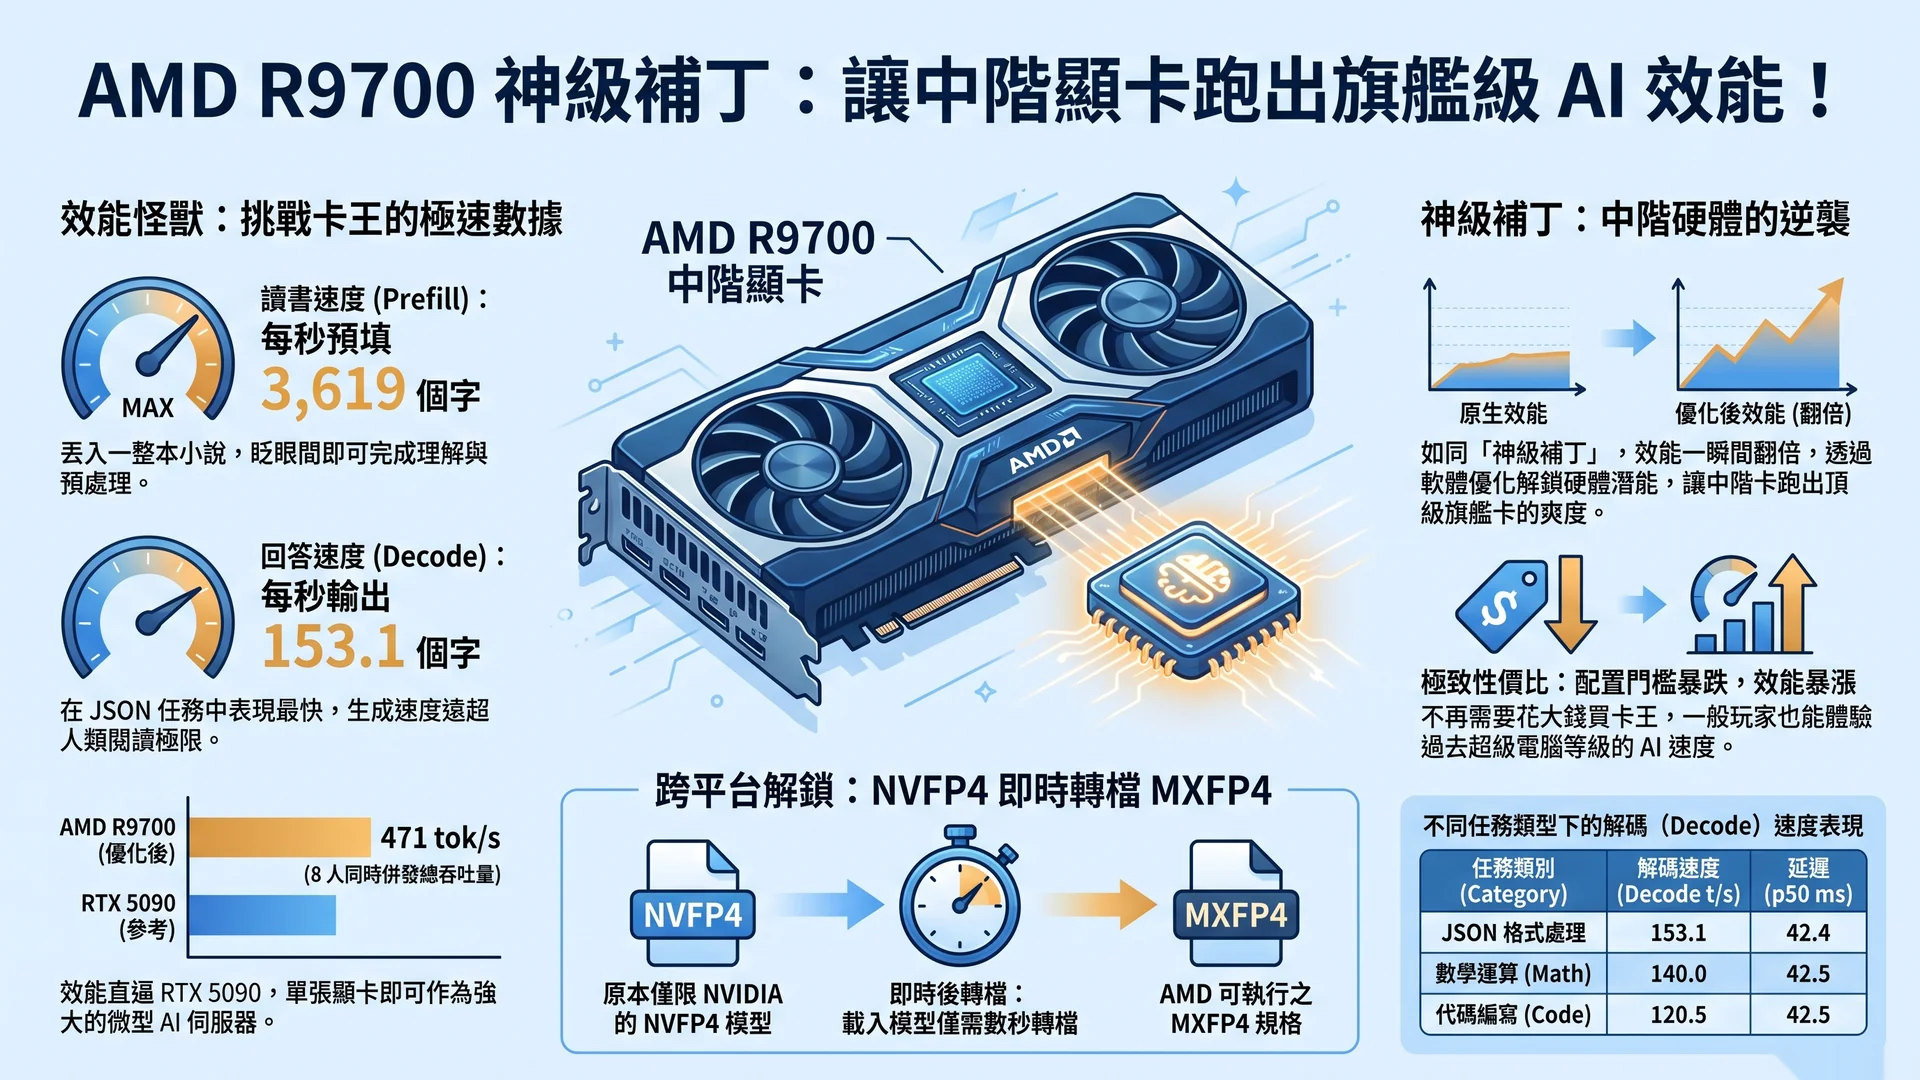
一位開發者使用單張 AMD Radeon AI PRO R9700 32GB,運行 Unsloth 的 Qwen3.8 27B NVFP4 模型,在經過推論軟體與 Kernel 優化後,Coding 工作負載做到每秒 120.5 Tokens,JSON 更達到每秒 153.1 Tokens。
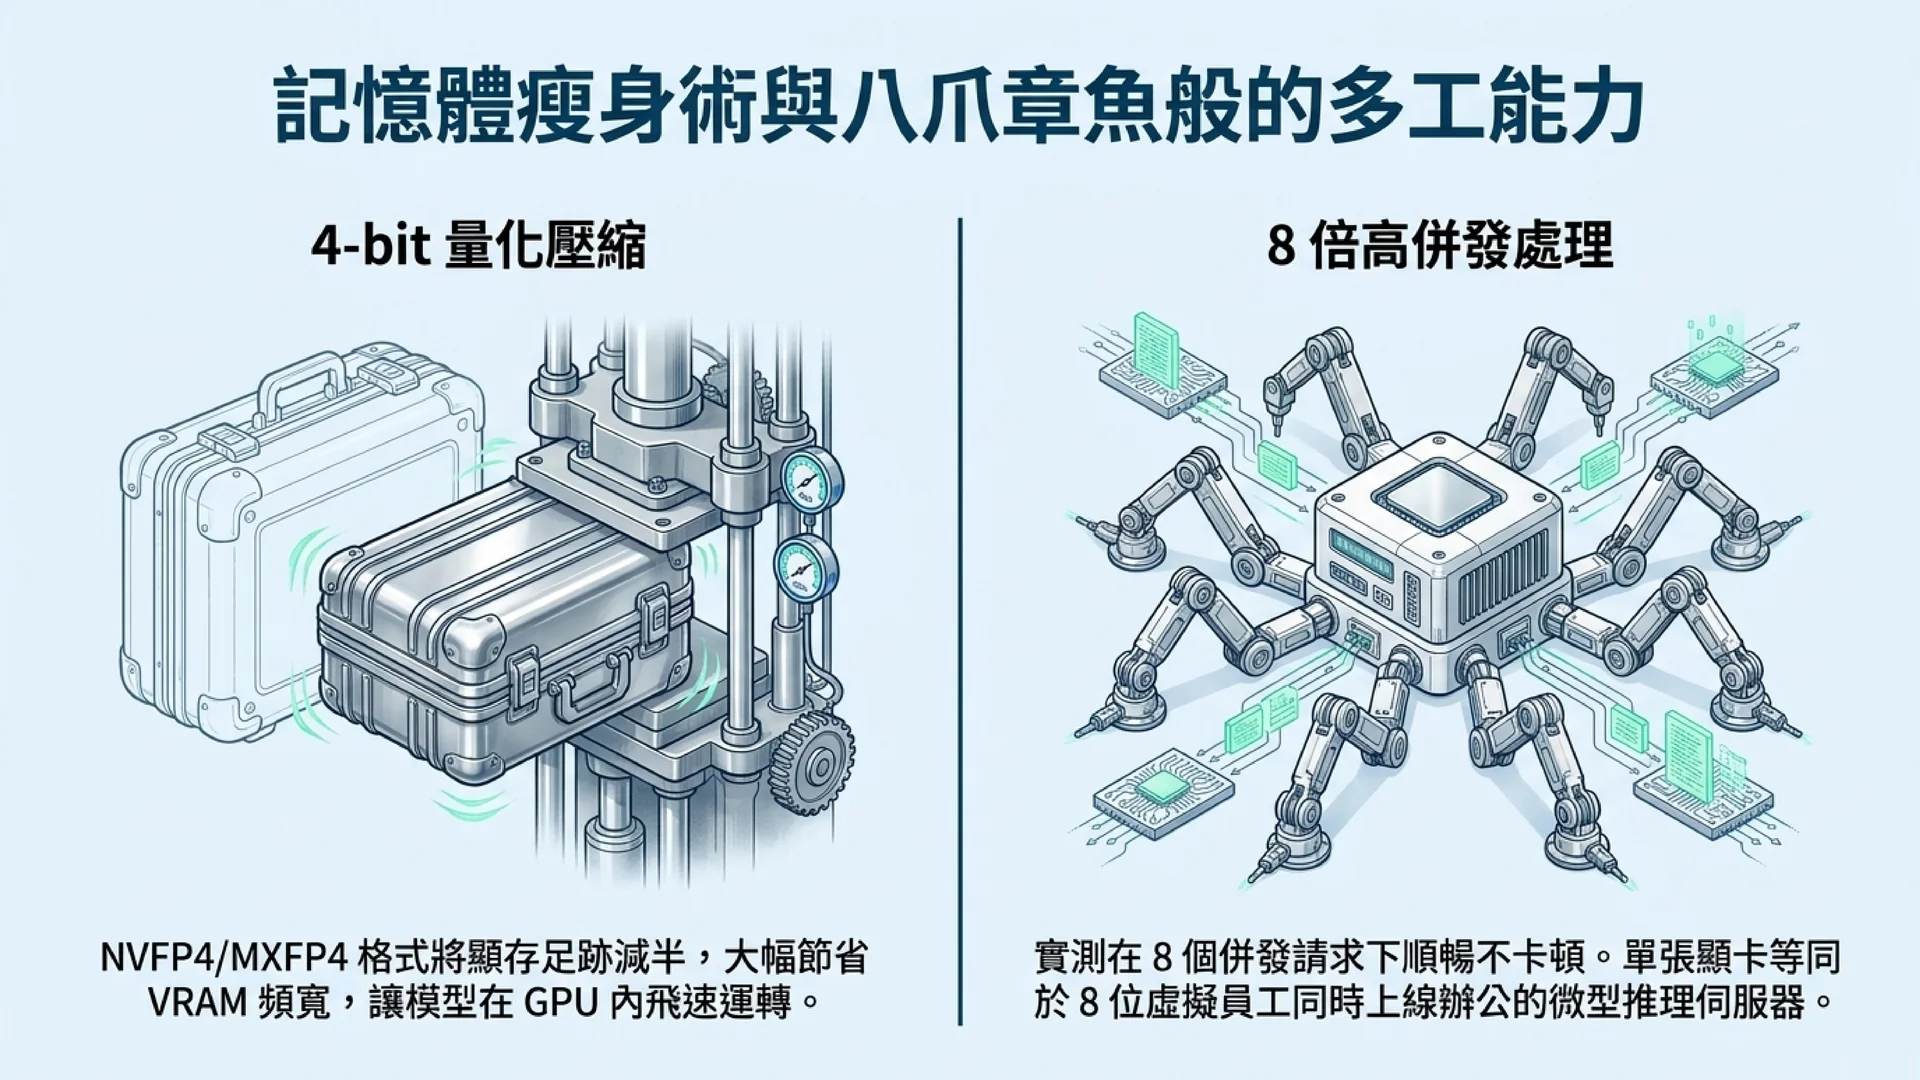
更誇張的是,16K Context 的 Prefill 達到每秒 3,619 Tokens,8 路請求同時執行時,Aggregate Throughput 更來到每秒 471 Tokens。
而作者自己對這次更新的描述很簡單:
這次優化後,單張 R9700 的效能幾乎全面翻倍。
身為長期碰 Linux、Docker、GPU 與地端 LLM 的開發者,我認為這則消息真正值得注意的地方,其實不是「AMD 終於打贏 NVIDIA」這種簡化的結論。
真正重要的是:
AI 推論的競爭,正在從單純比較 GPU 規格,快速轉向「硬體 × 量化格式 × Kernel × 推論引擎」的整體軟體堆疊競爭。
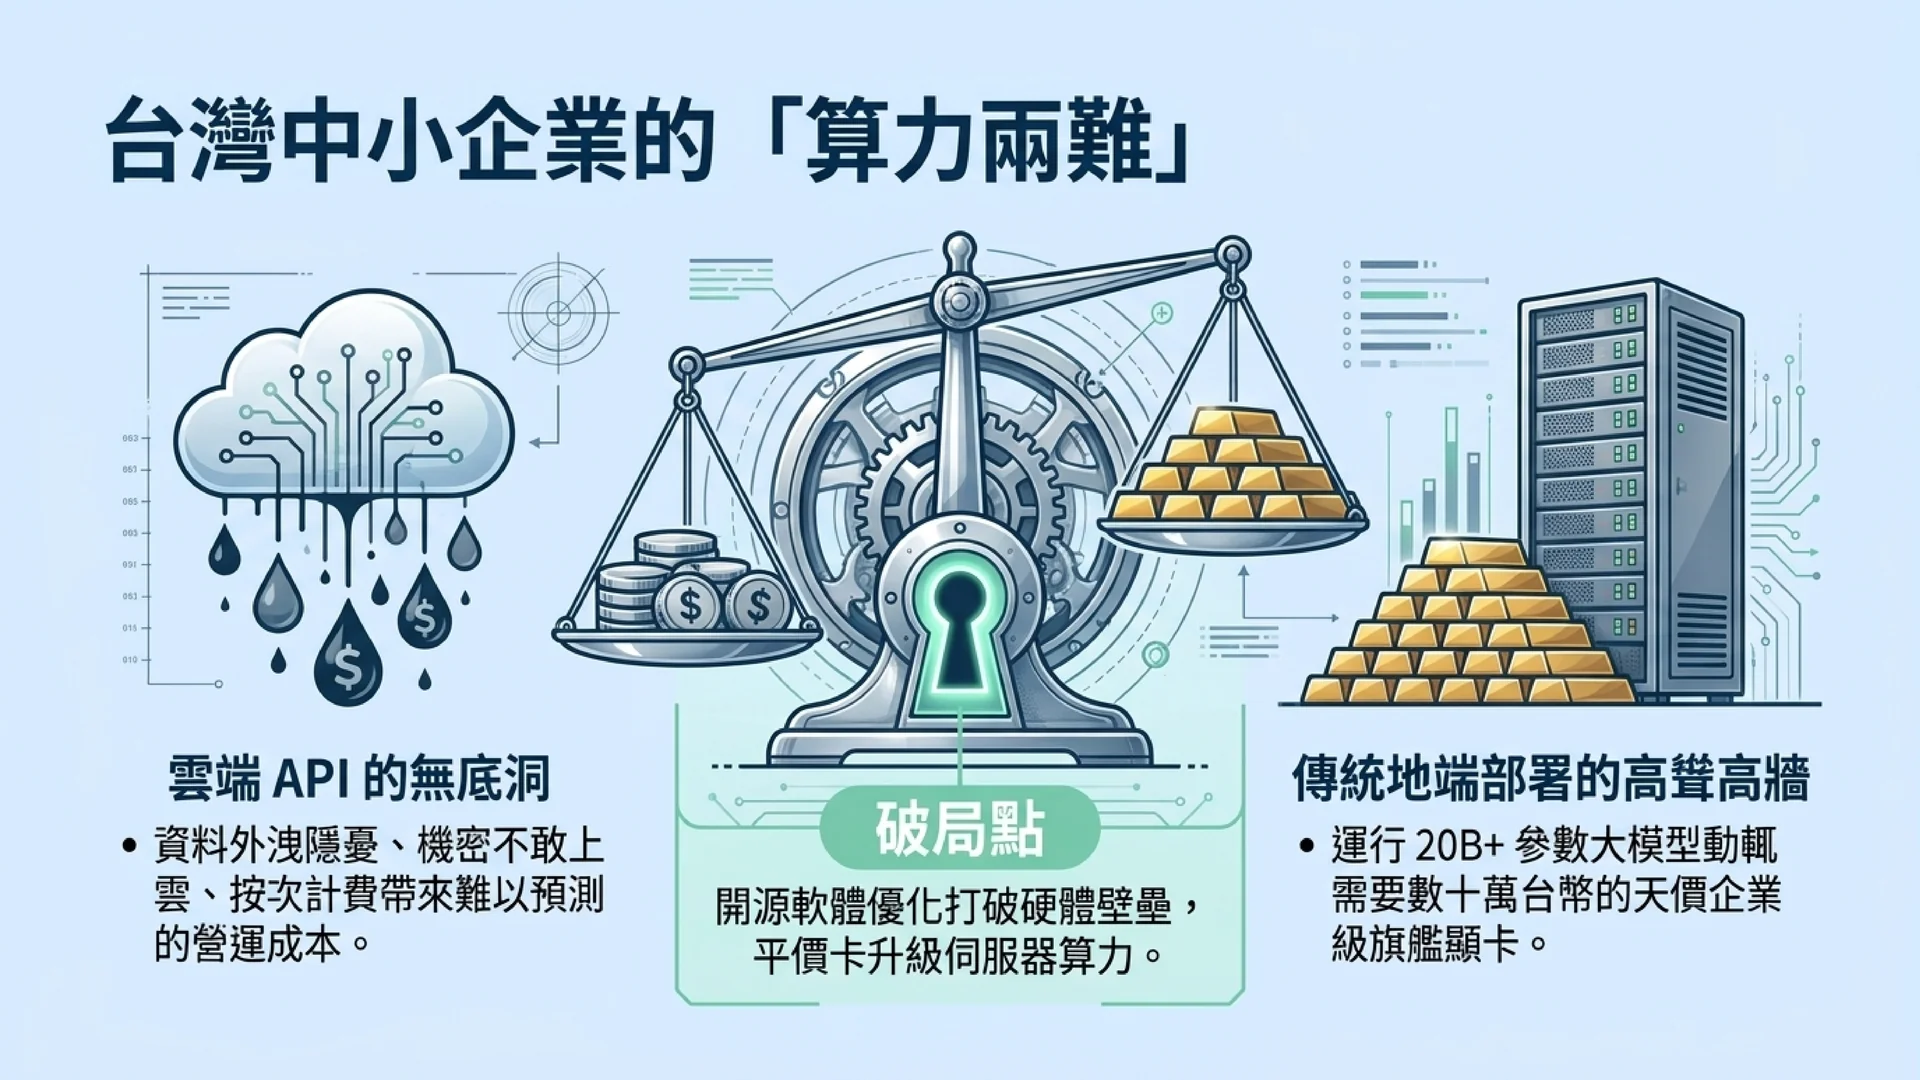
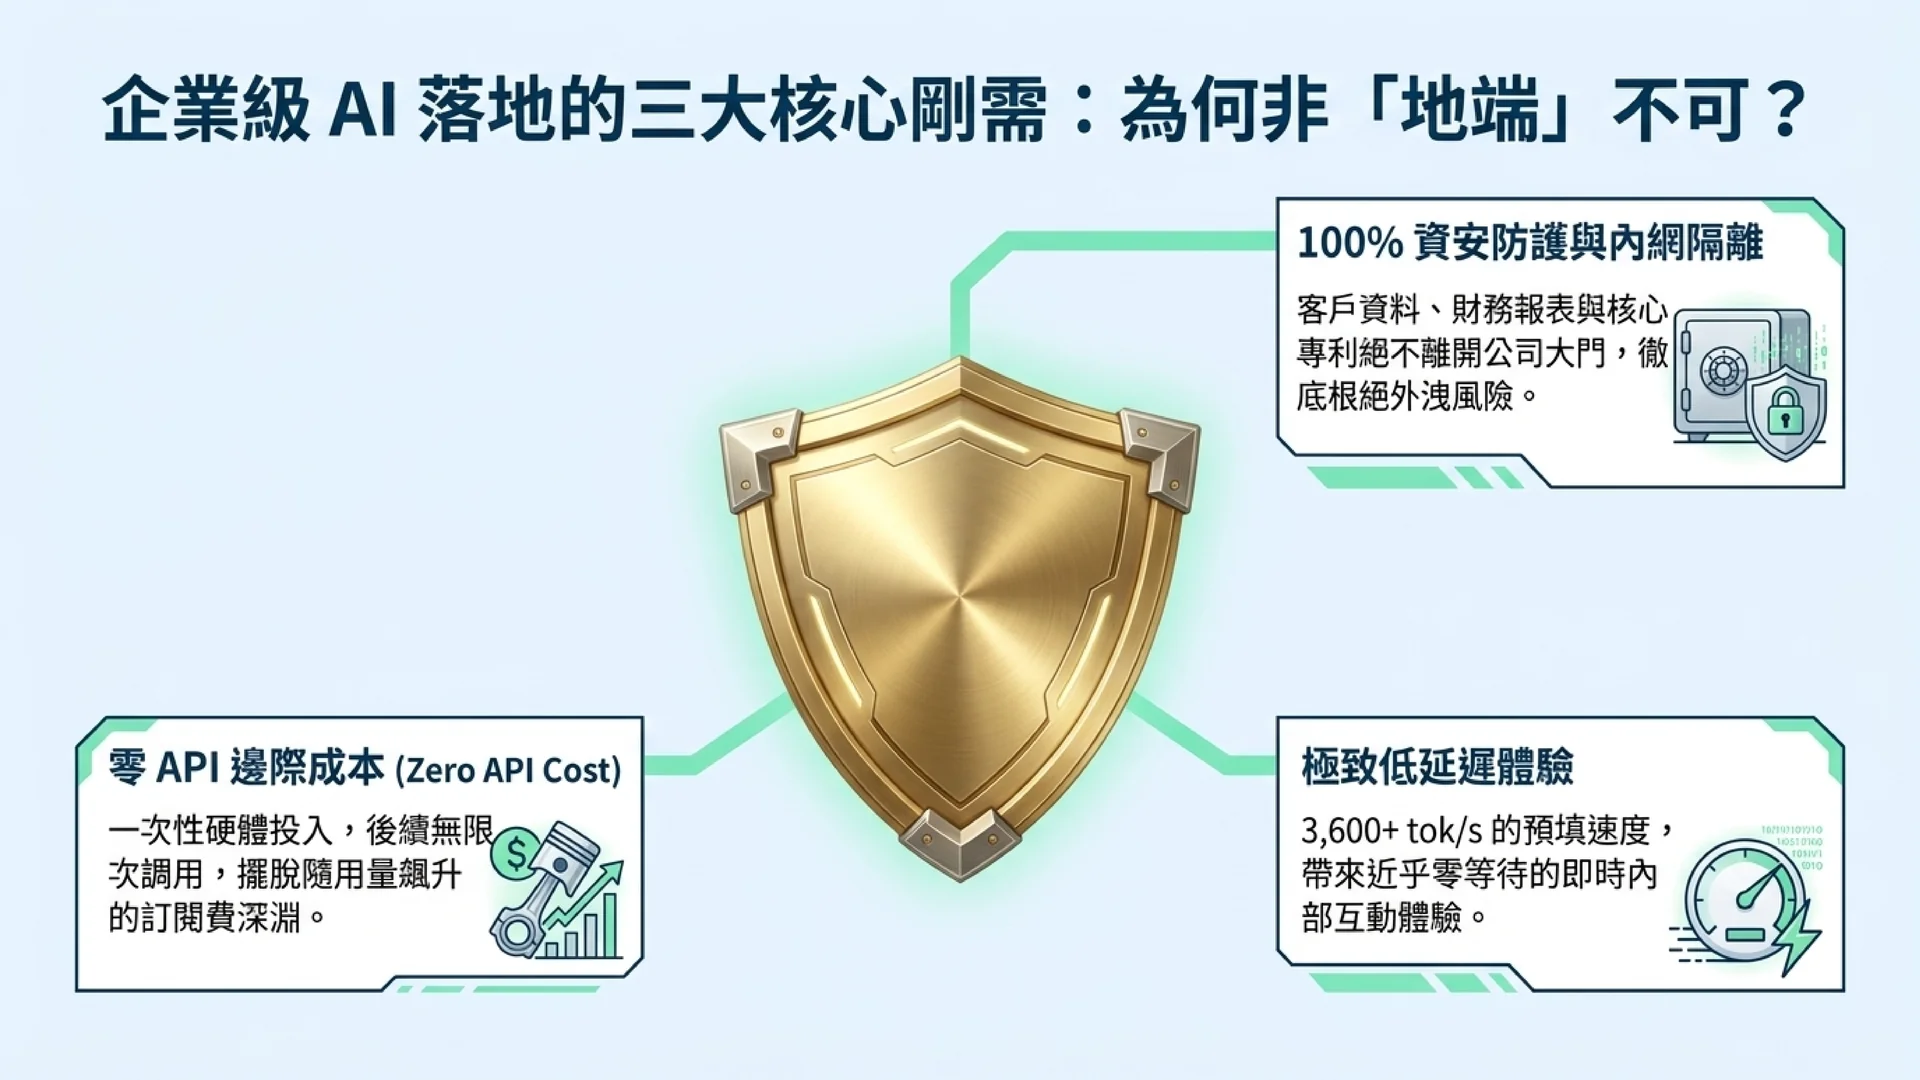
而這件事,可能直接改變未來中小企業採購地端 AI Server 的方式。
一張顯卡沒換,為什麼突然快這麼多?
如果用最簡單的方式形容,這有點像你買了一張顯卡,硬體完全沒有更換,結果幾個月後有人重新寫了一套更有效率的驅動與遊戲引擎,同一張卡突然跑出完全不同的成績。
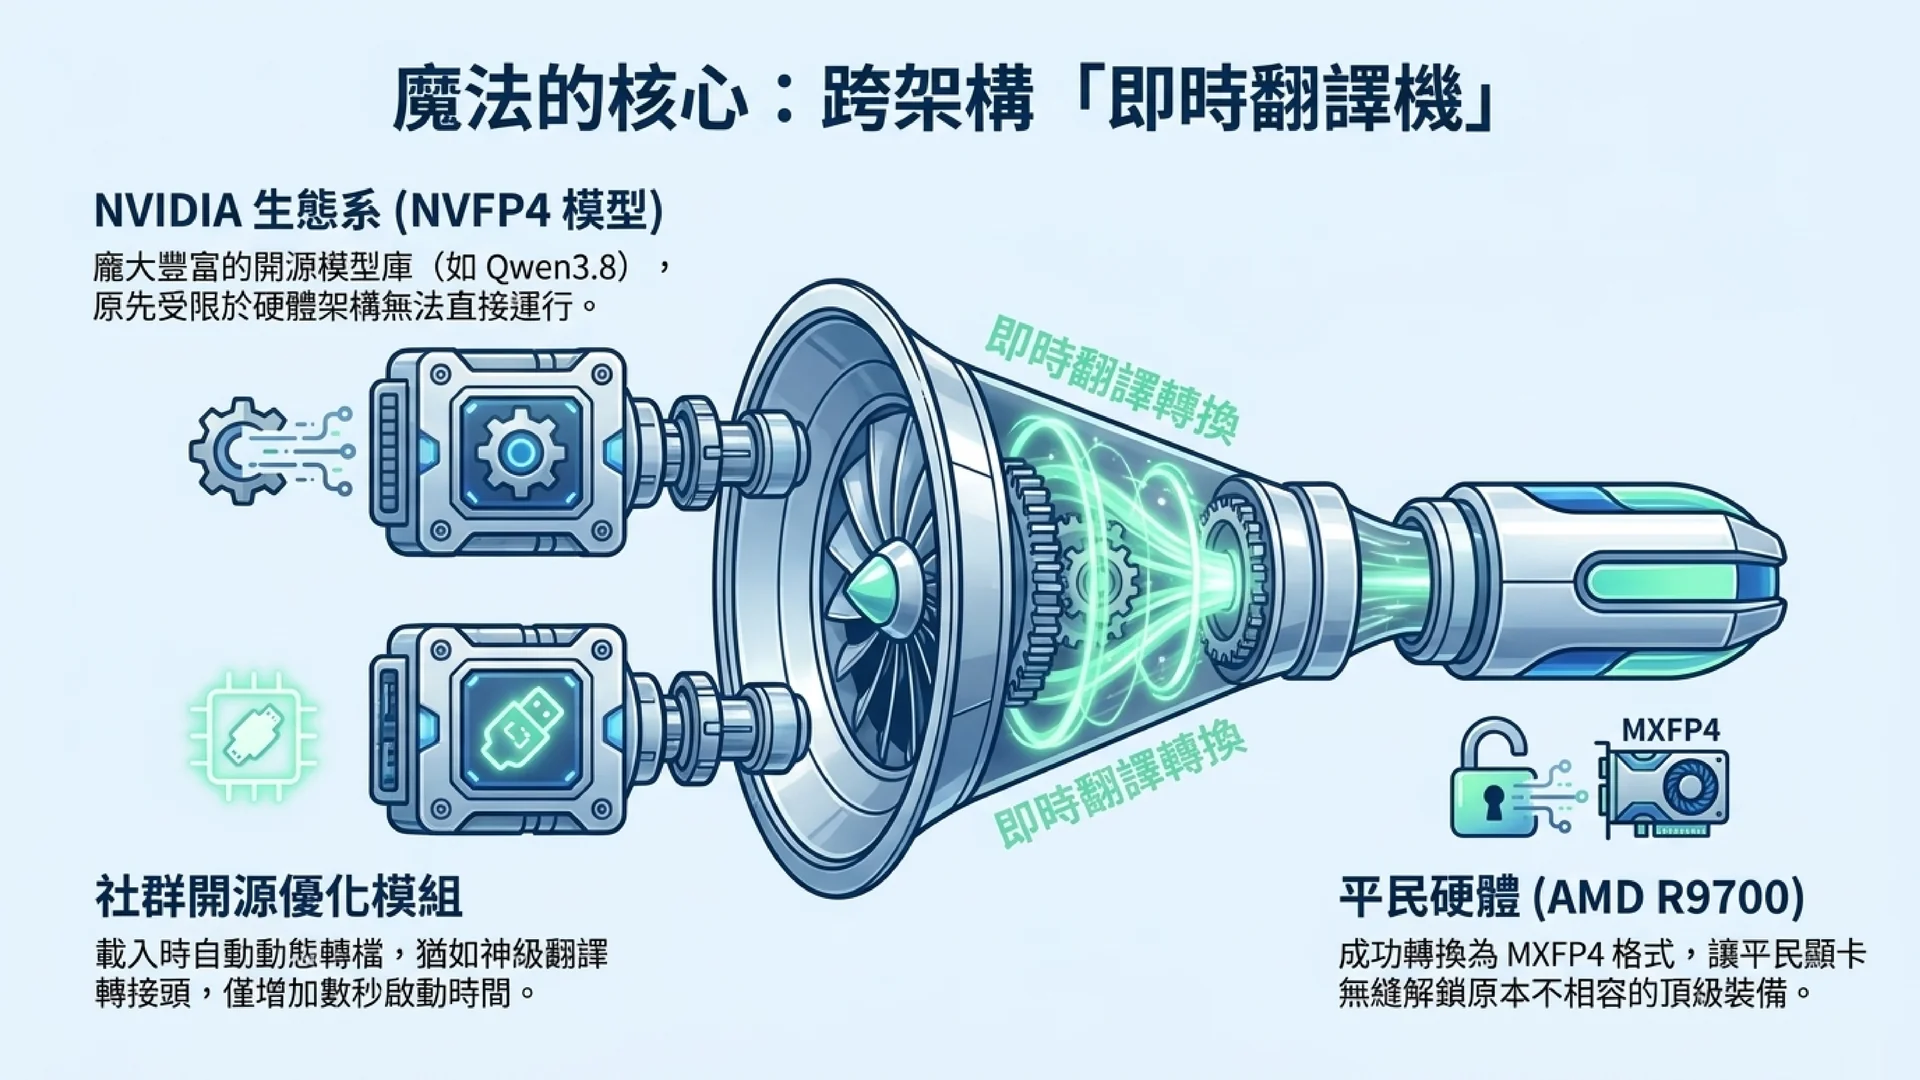
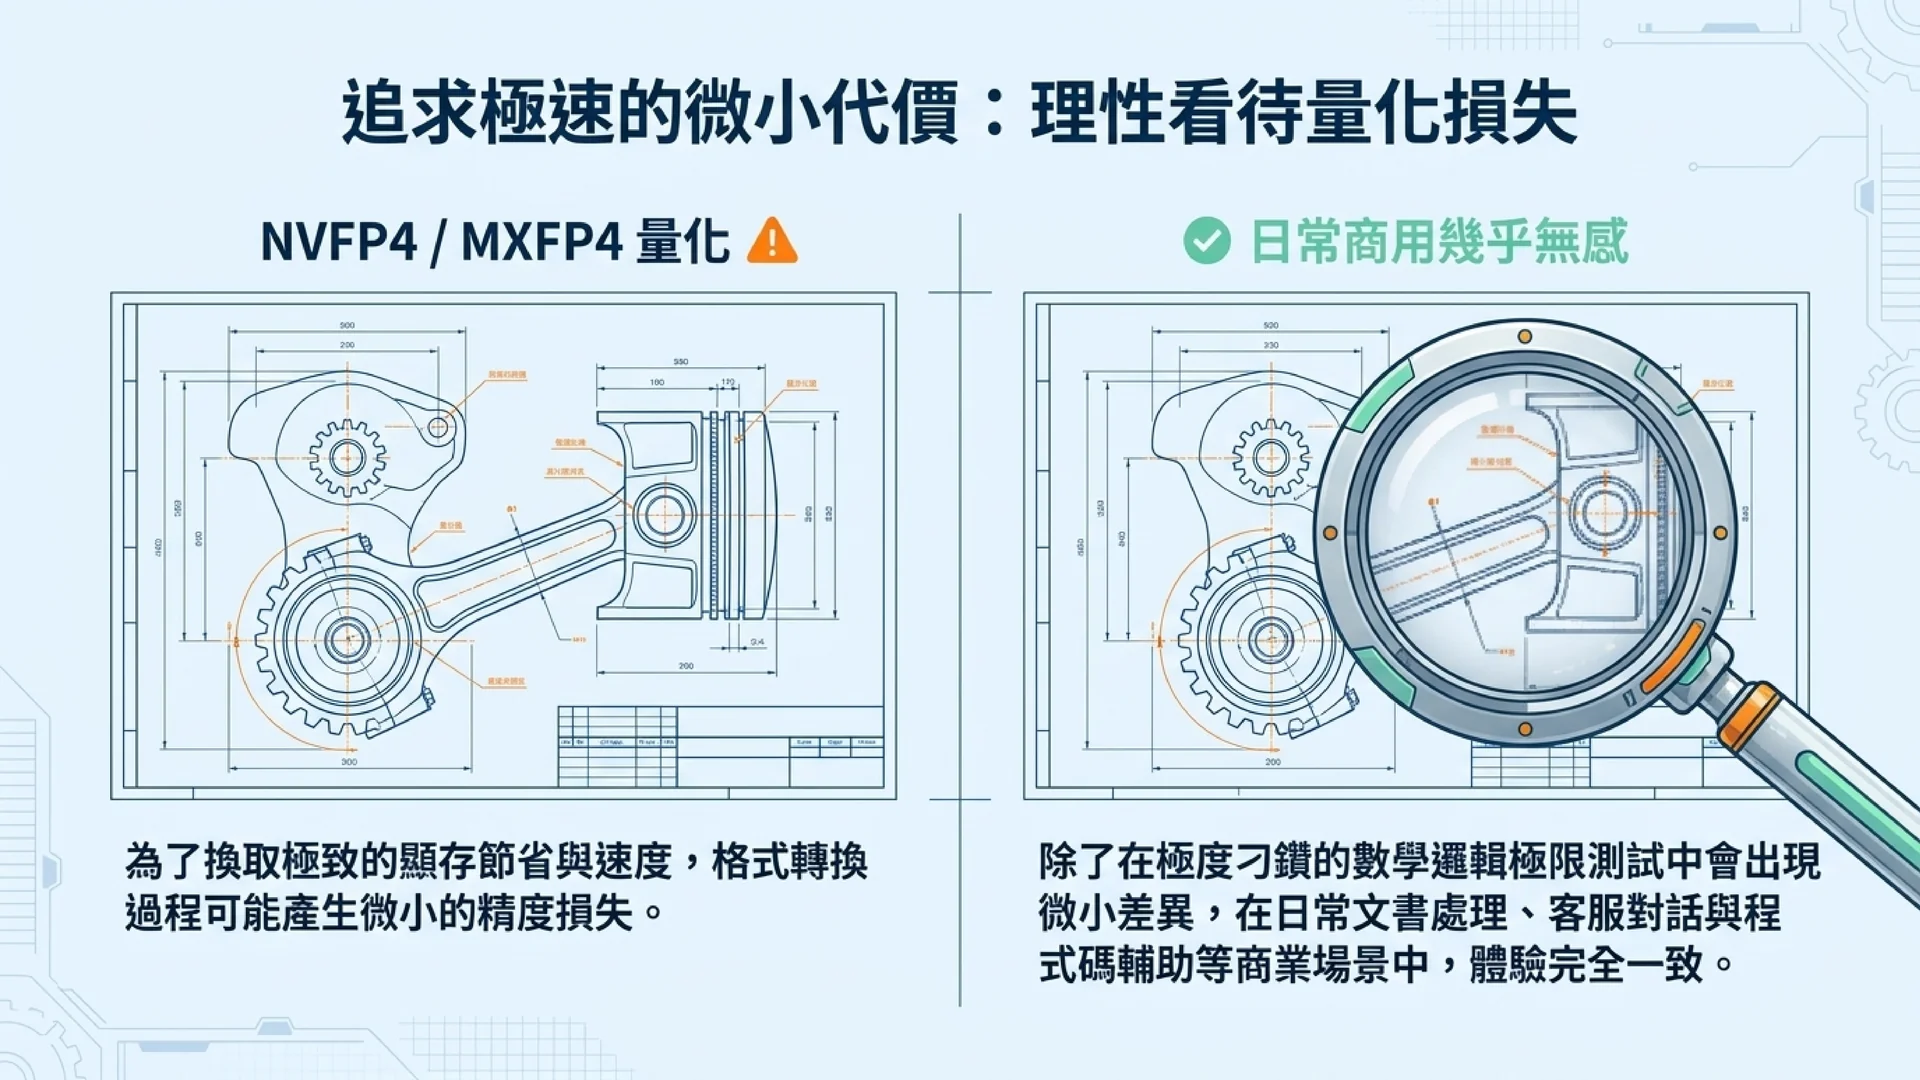
這次其中一個重要關鍵,就是 NVFP4 → MXFP4。
現在 Hugging Face 上愈來愈多高效能 4-bit 模型採用 NVIDIA 的 NVFP4 格式。
問題是,AMD 並不能直接把 NVFP4 丟進自己的 MXFP4 加速路徑。
社群開發者因此加入一個很有意思的機制:
模型載入時,直接進行 NVFP4 → MXFP4 的 Online Conversion。
也就是使用者下載的仍然可以是 NVFP4 模型,但載入 AMD GPU 時,系統自動重新量化成 MXFP4,再進入針對 AMD 最佳化的推論路徑。
這個概念並不只是 Reddit 玩家自己在實驗。
AMD 在 2026 年 9 月也正式公開了類似技術,在 Instinct MI350X/MI355X 上透過 SGLang 執行 Online NVFP4 → MXFP4 Requantization。
這件事情的重要性在於:
模型格式開始不再完全綁死 GPU 生態。
過去看到 NVFP4,直覺就會想到 NVIDIA。
現在中間開始多了一層軟體轉換。
對第一線工程師來說,這個變化其實比單純的 153 Tokens/s 更值得注意。
153 Tokens/s 很快,但不要看錯數字
看到 Benchmark,工程師第一個反應不應該是「好快」,而應該先問:
這到底測的是什麼?
這次單張 R9700 的 Decode 數據依工作負載不同:
Chat 約 67.1 Tokens/s。
Coding 約 120.5 Tokens/s。
Reasoning 約 123.9 Tokens/s。
Summarization 約 141.7 Tokens/s。
JSON 則達到 153.1 Tokens/s。
所以「R9700 跑 Qwen3.8 27B 有 153 Tokens/s」這句話 technically 沒錯,但如果把它理解成「所有聊天都固定 153 Tokens/s」,那就錯了。
153 是特定 JSON workload 的結果。
同樣地,8 Concurrent 達到 471 Tokens/s,也不是代表八個使用者每人都有 471 Tokens/s。
這是整張 GPU 在八路請求下的總吞吐量。
但從企業角度來看,我反而認為 471 Tokens/s 比 153 Tokens/s 更重要。
因為企業真正關心的問題不是:
「一個人跟 AI 聊天到底有多快?」
而是:
「這台機器能不能同時服務公司裡好幾個人?」
這才是 Local AI Server 真正的價值。
32GB VRAM,可能才是 R9700 最大的武器
R9700 是 RDNA4 架構,AMD 官方規格提供 32GB VRAM。
AMD 也已經正式展示單張 R9700 運行 Qwen3.8 27B。
值得注意的是,AMD 2026 年 8 月公布的 Windows + llama.cpp + Vulkan 初期測試,R9700 大約只有 51.8 Tokens/s。
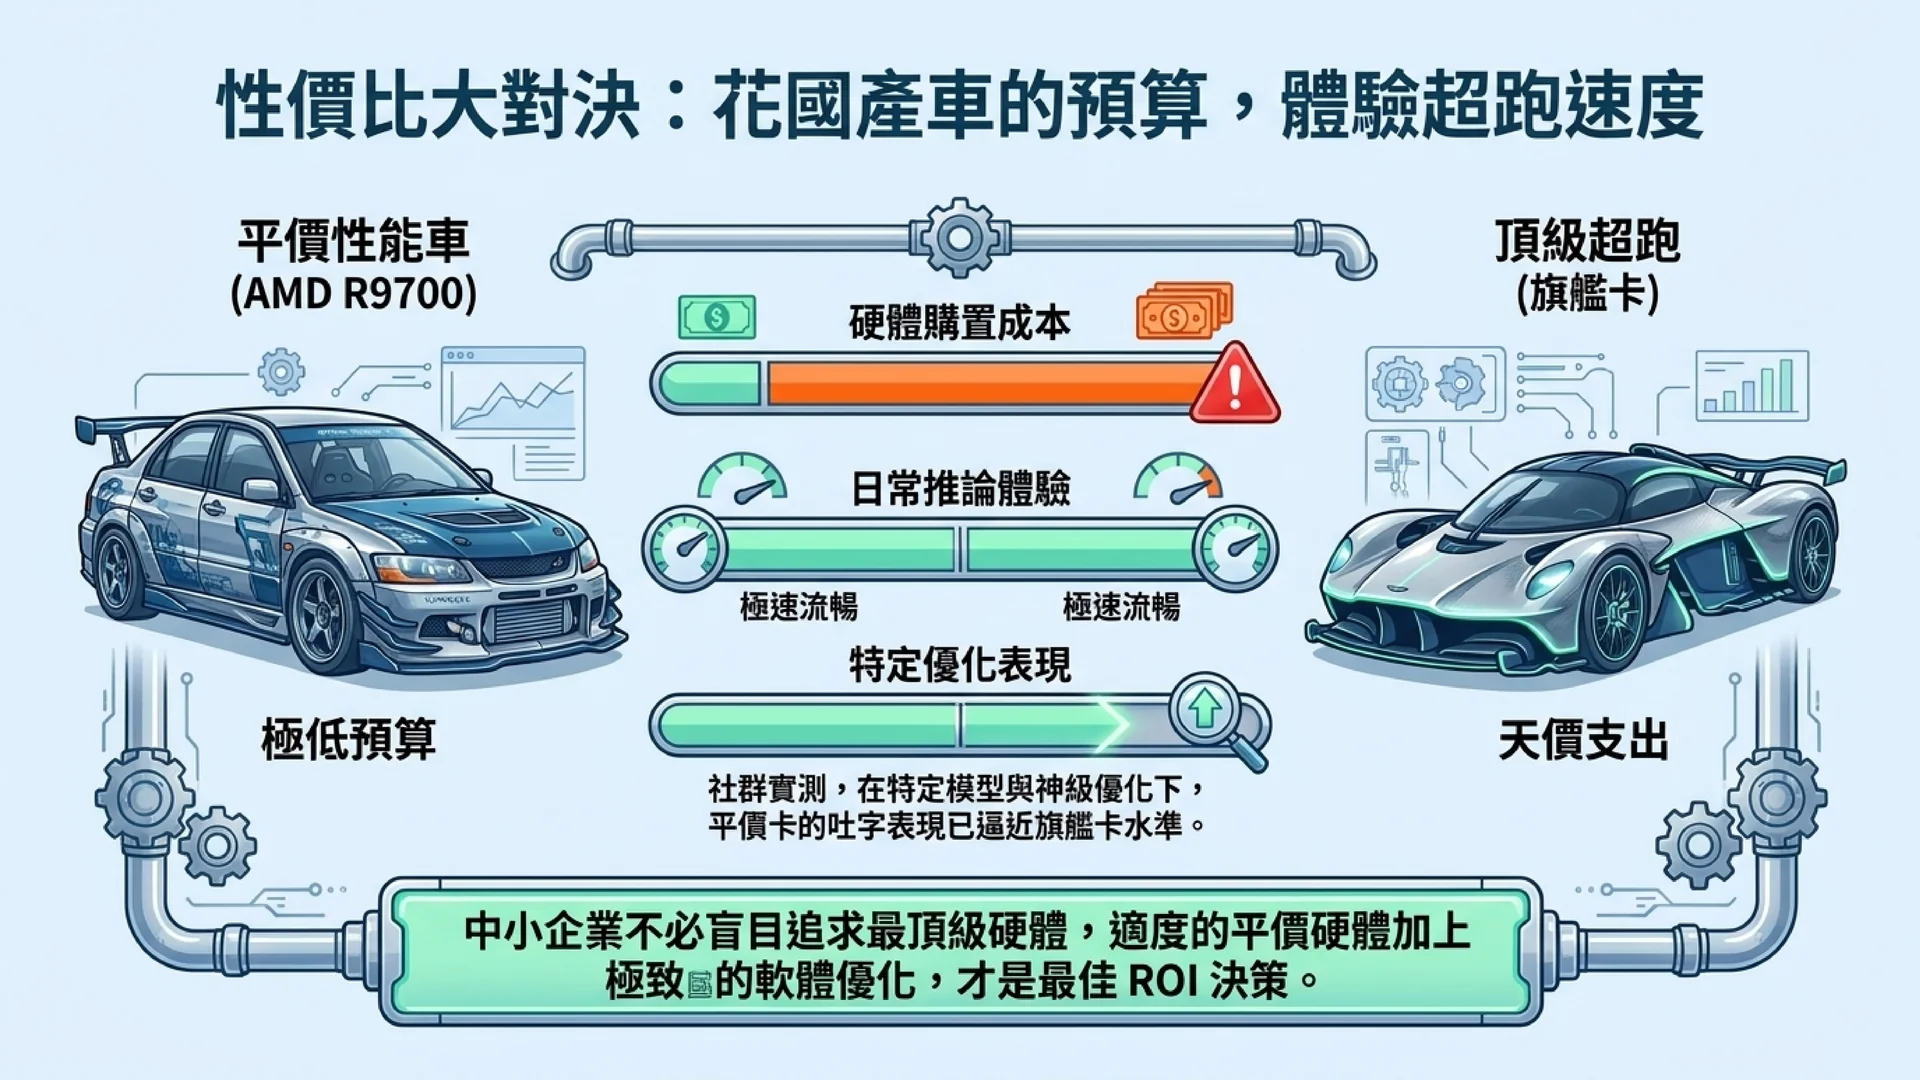
短短一個多月後,社群透過不同的 Runtime、量化格式、Speculative Decoding 與自訂 Kernel,把特定工作負載推到 120~153 Tokens/s。
硬體沒有突然變快。
變快的是軟體。
這正是目前 Local AI 最有意思的地方。
我們以前買 GPU,常常認為今天買回來是多少效能,三年後大概就是多少效能。
AI 時代不一定如此。
同一張 GPU,隨著 llama.cpp、vLLM、SGLang、ROCm、Flash Attention、量化格式與 Kernel 不斷進步,半年後可能完全是另外一張卡。
這也是為什麼現在評估 AI 硬體,不能只看 TFLOPS。
你其實是在買一整套「未來軟體優化可能性」。
AI 開發者現在可以買嗎?
如果你是熟悉 Linux、Docker、ROCm、vLLM、llama.cpp 的開發者,我的答案很簡單:
已經值得開始測。
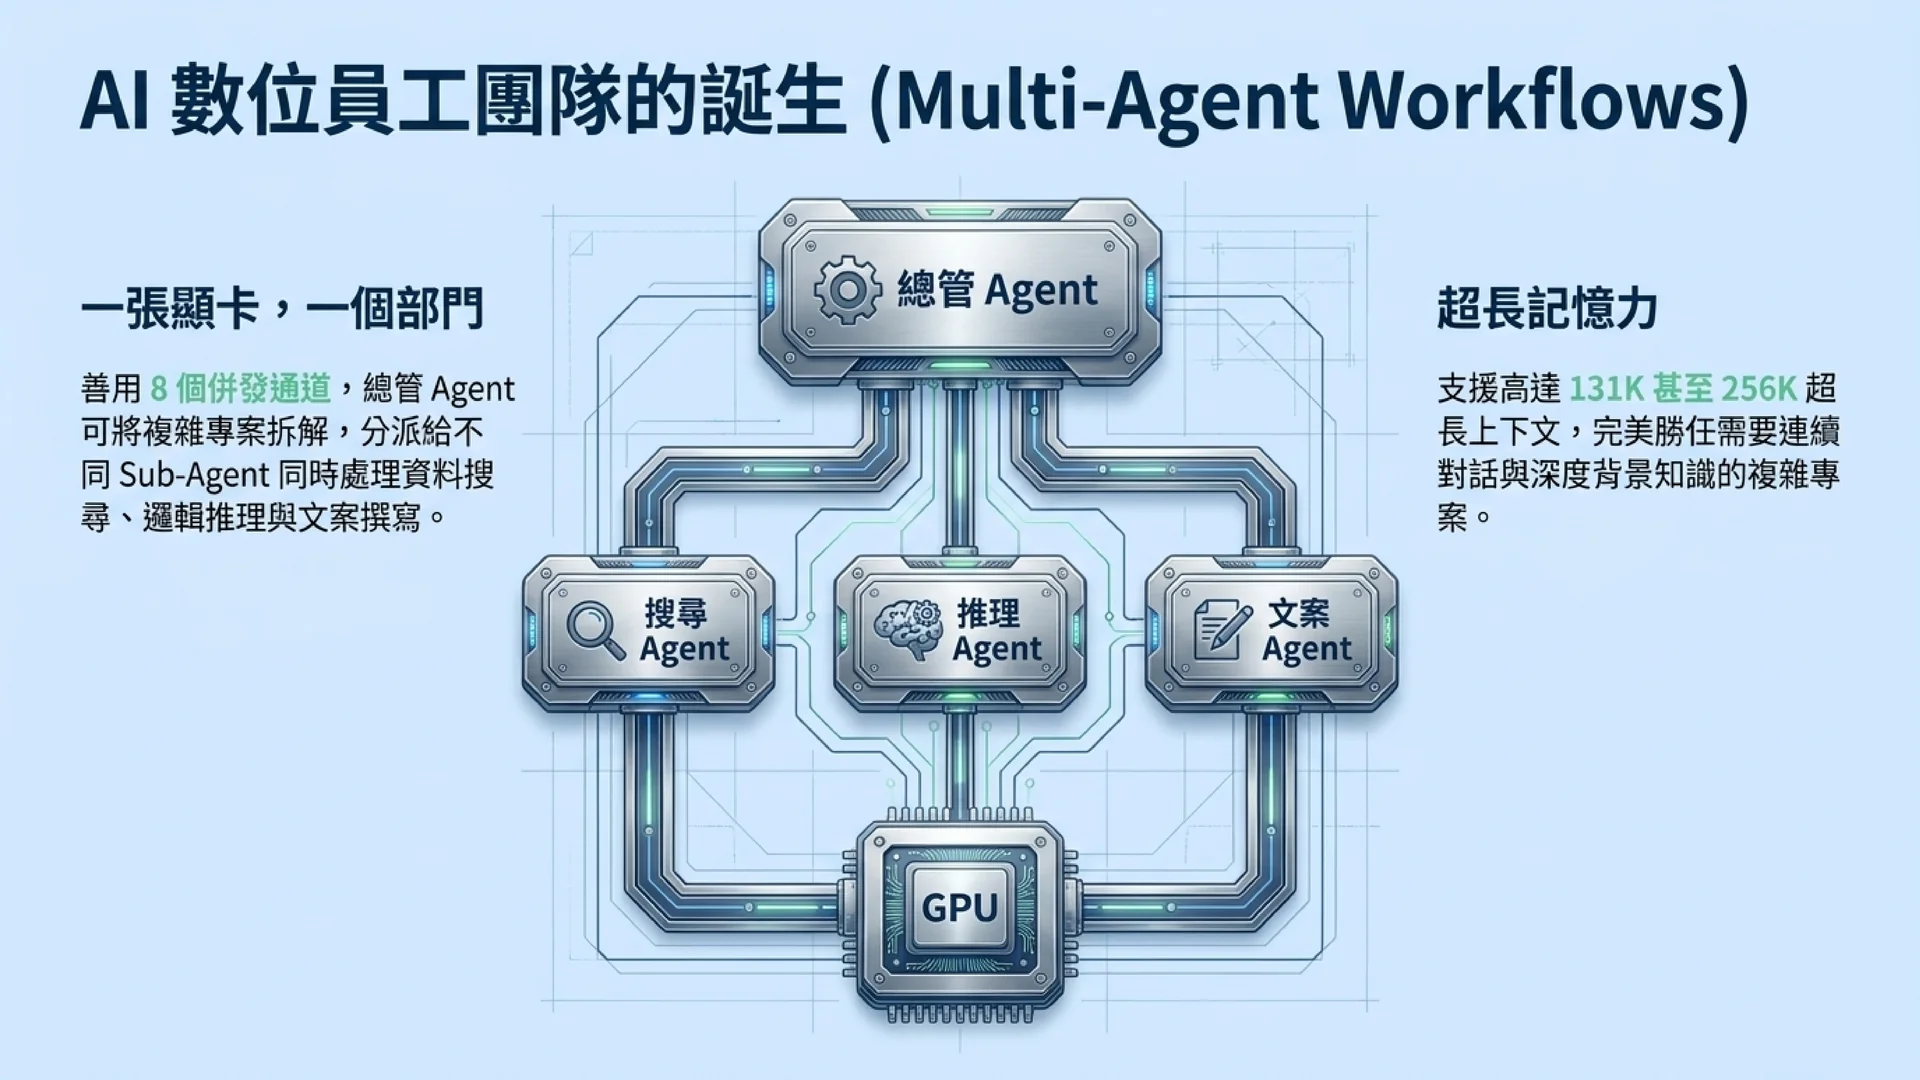
特別是你的主要需求是 Local LLM、Coding Agent、RAG、企業知識庫、多 Agent 或多人共用推論服務。
單張 32GB VRAM 能完整放進 Qwen3.8 27B 等級的量化模型,本身就非常有吸引力。
但這裡有一個前提。
你必須接受:
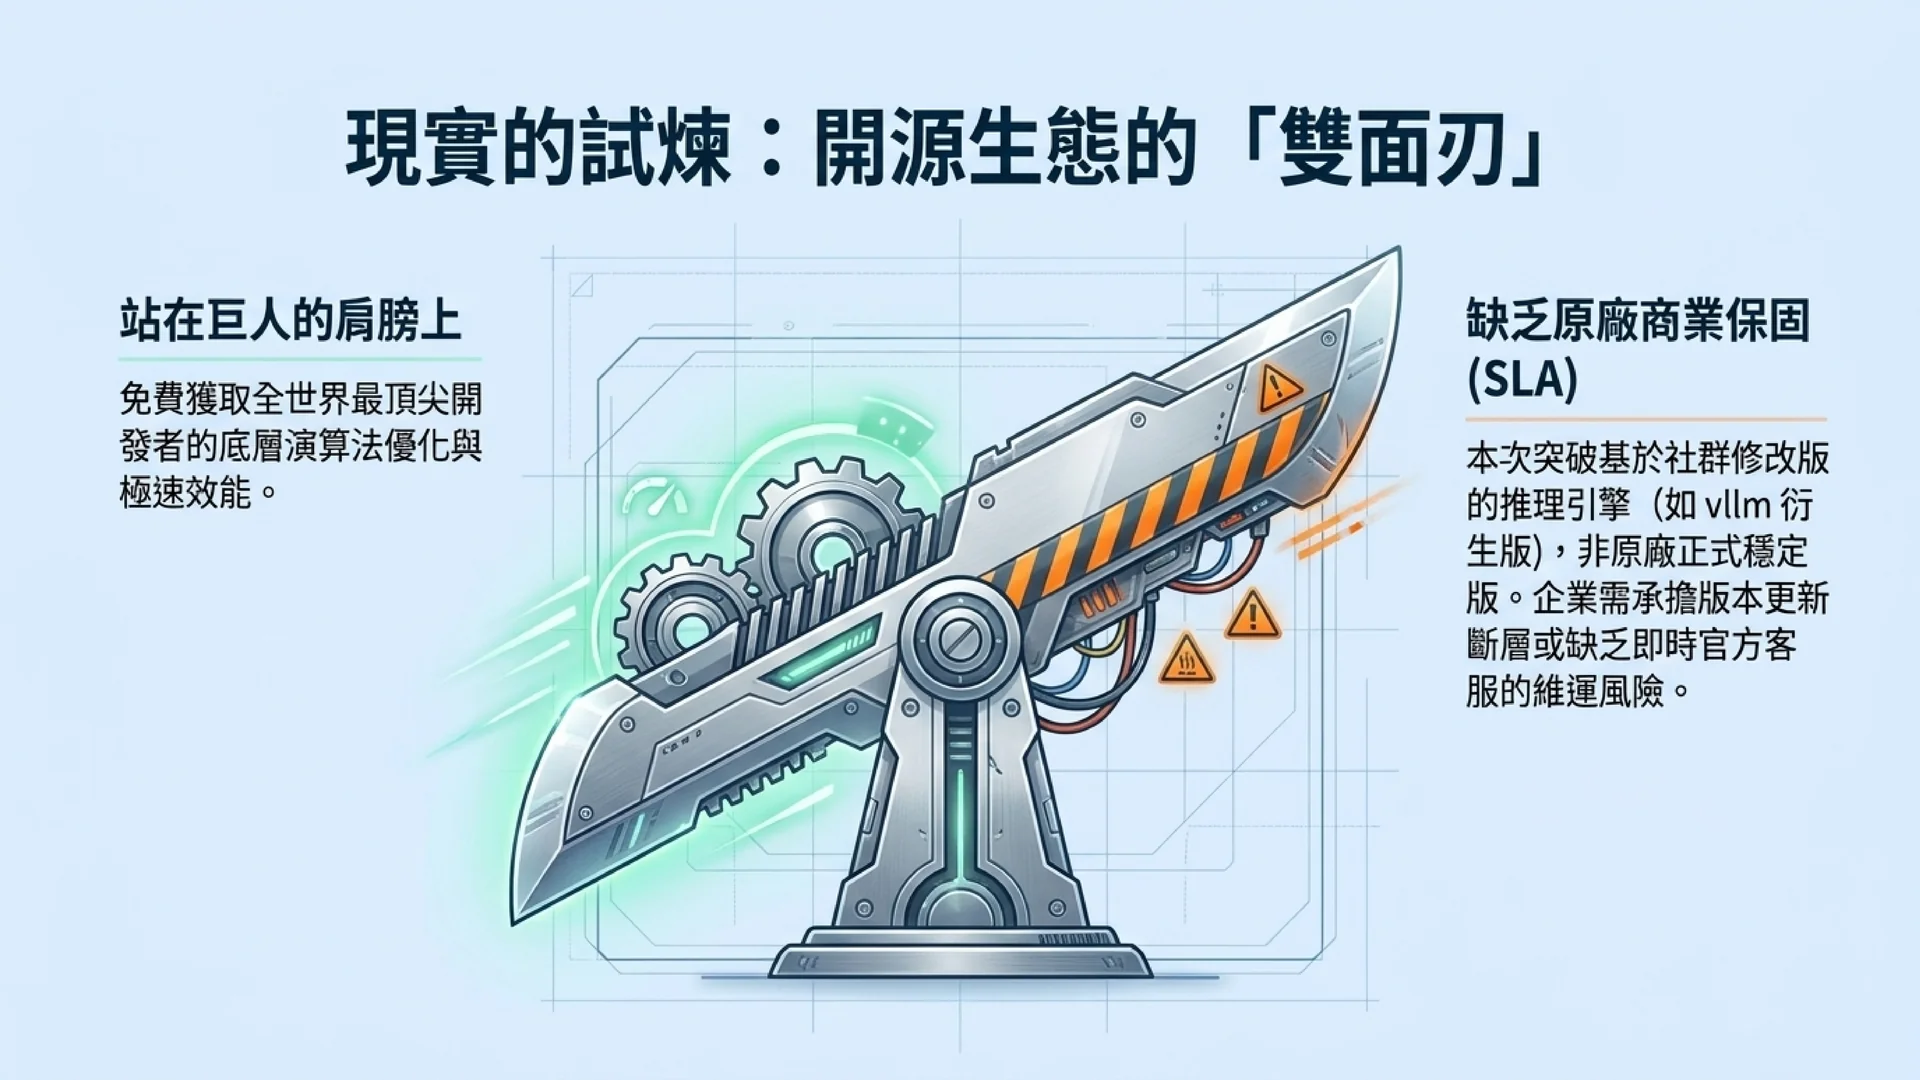
今天效能最好的設定,可能不是「apt install 完就有」。
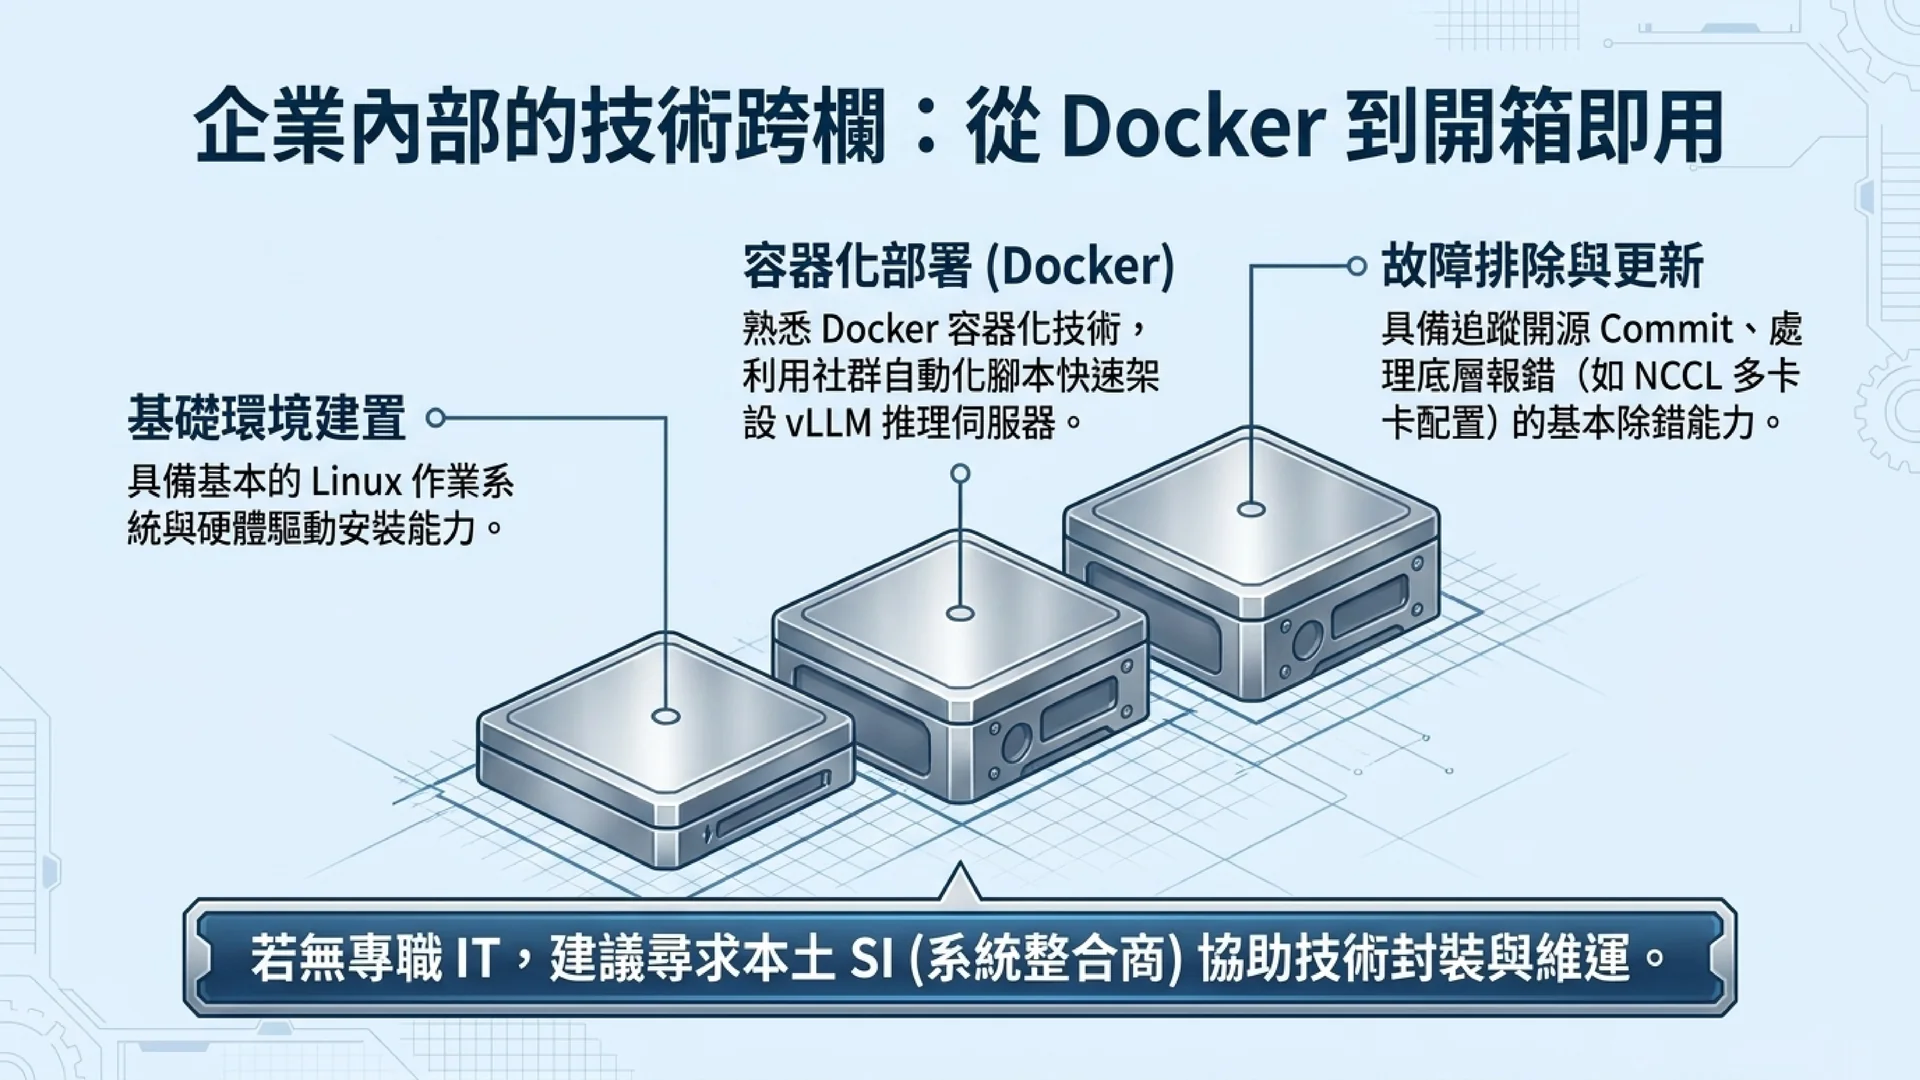
你可能要碰 Docker Image、ROCm 版本、vLLM fork、Kernel、MXFP4、Speculative Decoding,甚至自己解決套件相依問題。
對 AI 工程師而言,這叫「有趣」。
對一般公司而言,這叫「維護成本」。
兩者完全不同。
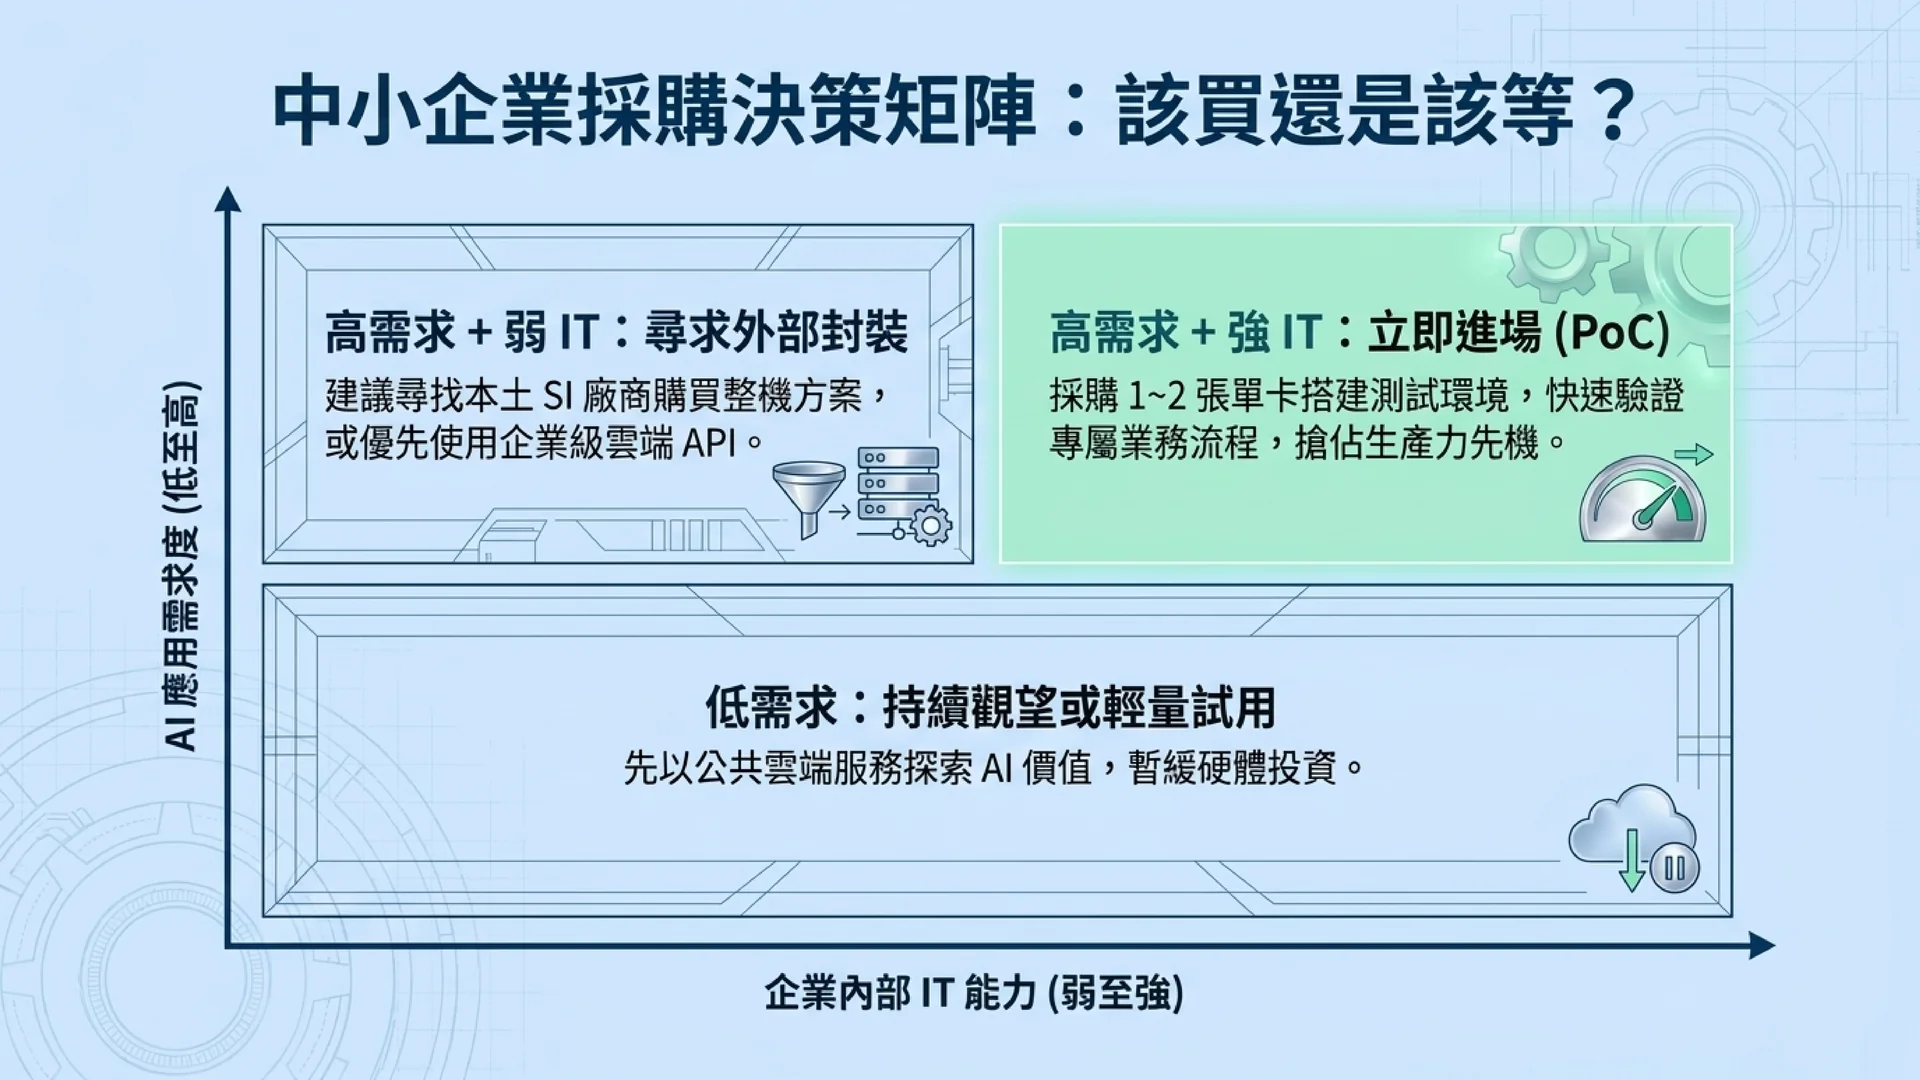
那中小企業現在可以採購嗎?
可以。
但我的建議是:
不要採購一張顯卡,要採購一套可以工作的 AI Server。
一般中小企業沒有必要知道 NVFP4、MXFP4、W4A8、gfx1201 到底是什麼。
企業真正應該問的是:
公司 4~8 個人能不能同時使用?
公司的 Word、PDF、SOP、客戶資料能不能留在內網?
RAG 能不能正常搜尋?
AI Agent 能不能跑?
每天早上員工打開瀏覽器就能使用嗎?
Server 重開機之後服務會不會自己恢復?
Docker 掛掉誰處理?
ROCm 更新後如果模型不能跑,誰負責修?
這些問題全部解決之後,R9700 才真正具有「企業價值」。
所以如果是一家沒有專職 AI 工程師的中小企業,我不會建議老闆看完 Reddit,隔天就去買一張 R9700 回公司。
我會建議購買的是:
Linux Server + R9700 32GB + Docker + 推論引擎 + Web UI + RAG + Agent + Monitoring + Backup + 技術維護。
顯卡只是其中一個零件。
我甚至不建議拿 153 Tokens/s 當驗收標準
企業採購 AI Server,最危險的事情就是只看跑分。
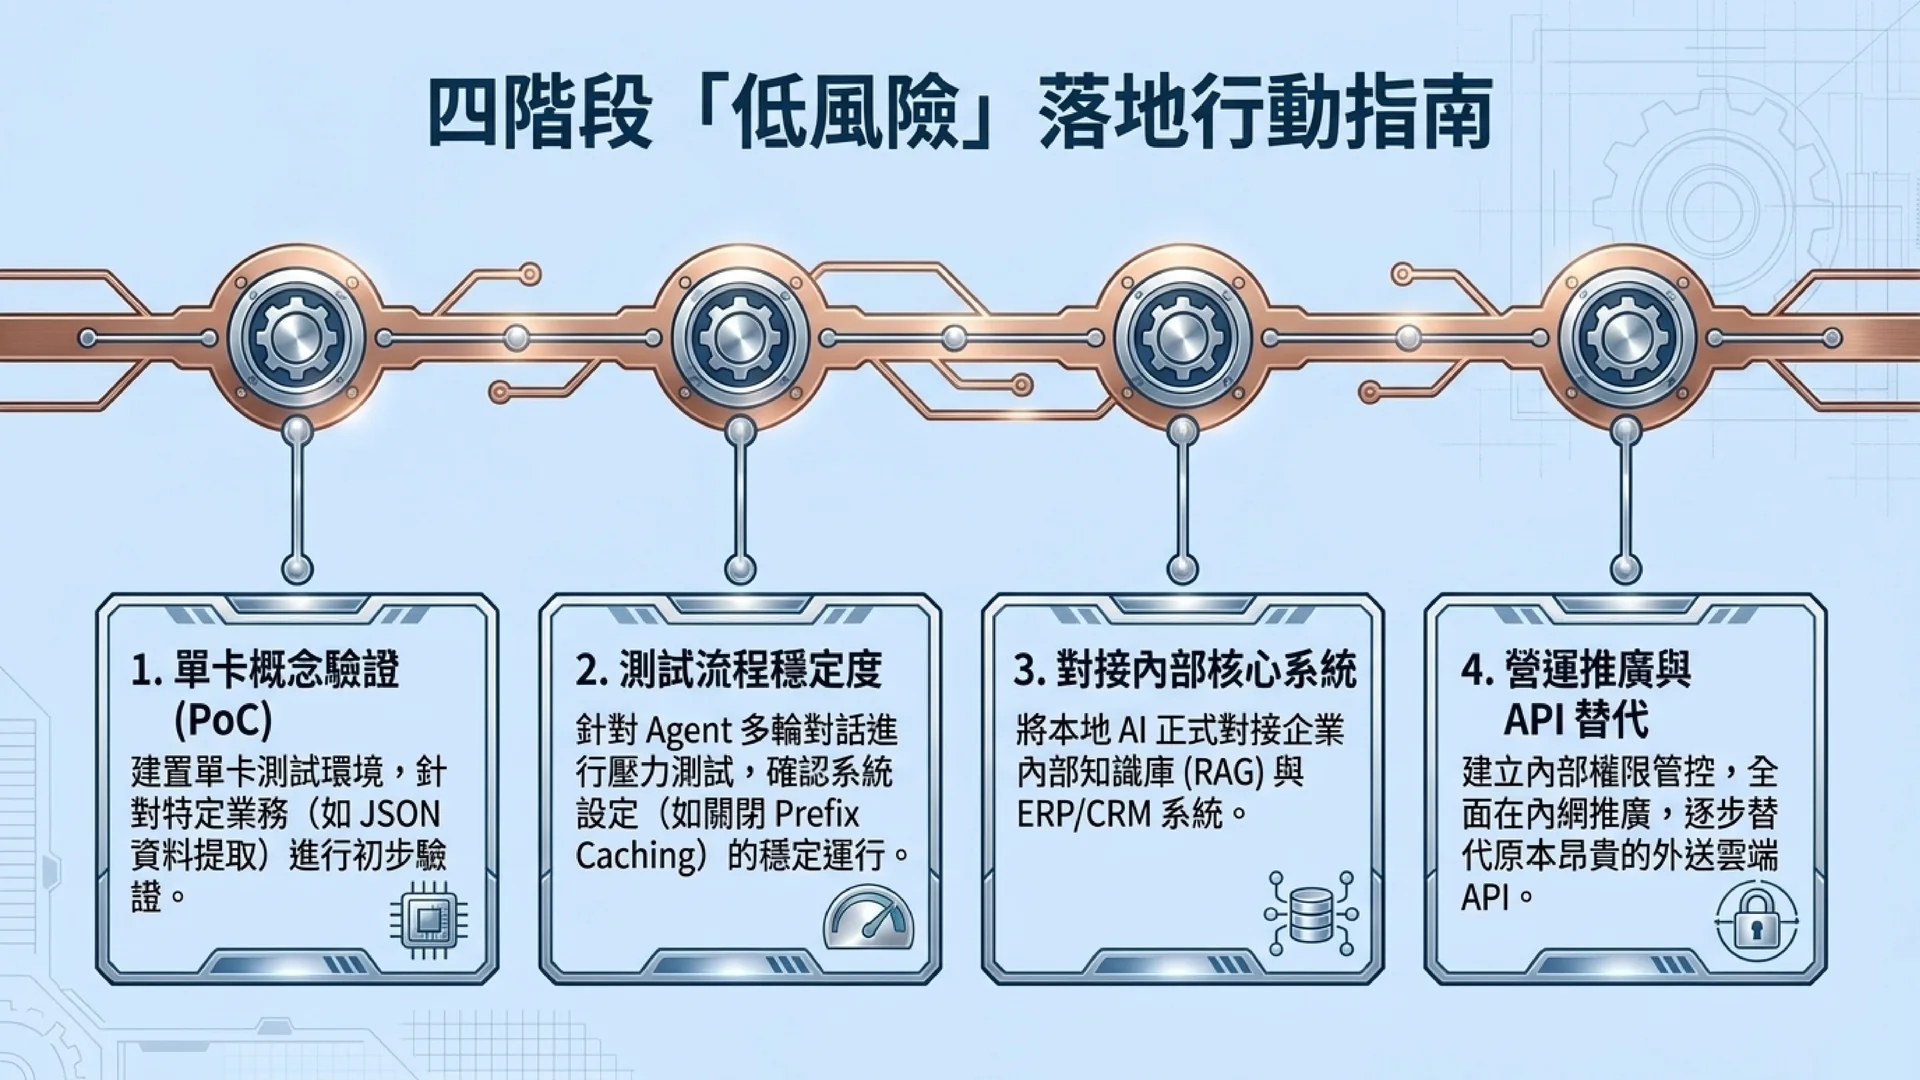
如果今天要我替公司驗收,我反而會設計這樣的測試:
Qwen3.8 27B 能不能正常運行?
4 個人同時使用時速度多少?
8 個人同時使用時速度多少?
丟入公司真正的 PDF、SOP、產品資料後,RAG 表現如何?
Context 拉長之後,TTFT 會增加多少?
連續跑 72 小時會不會出現 VRAM Leak?
Docker Container 掛掉能不能自動恢復?
整台 Linux Server 重開機之後,AI 服務能不能自動上線?
員工到底願不願意每天使用?
最後一個問題甚至比 Benchmark 更重要。
因為一台每秒可以跑 500 Tokens、但公司沒有人使用的 AI Server,商業價值仍然是零。
NVIDIA 還是 AMD?這可能已經不是最好的問題
我不認為這次 R9700 的結果代表 NVIDIA 不重要了。
如果你的公司高度依賴 CUDA、PyTorch Extension、ComfyUI、影像生成、影片生成,或大量 GitHub 專案都是 CUDA First,NVIDIA 成熟的軟體生態仍然具有非常大的優勢。
但如果工作負載相對單純:
Local LLM、RAG、Coding Agent、企業內部 Chatbot、多使用者 Inference Server。
那麼問題就開始改變了。
企業真正要比較的可能變成:
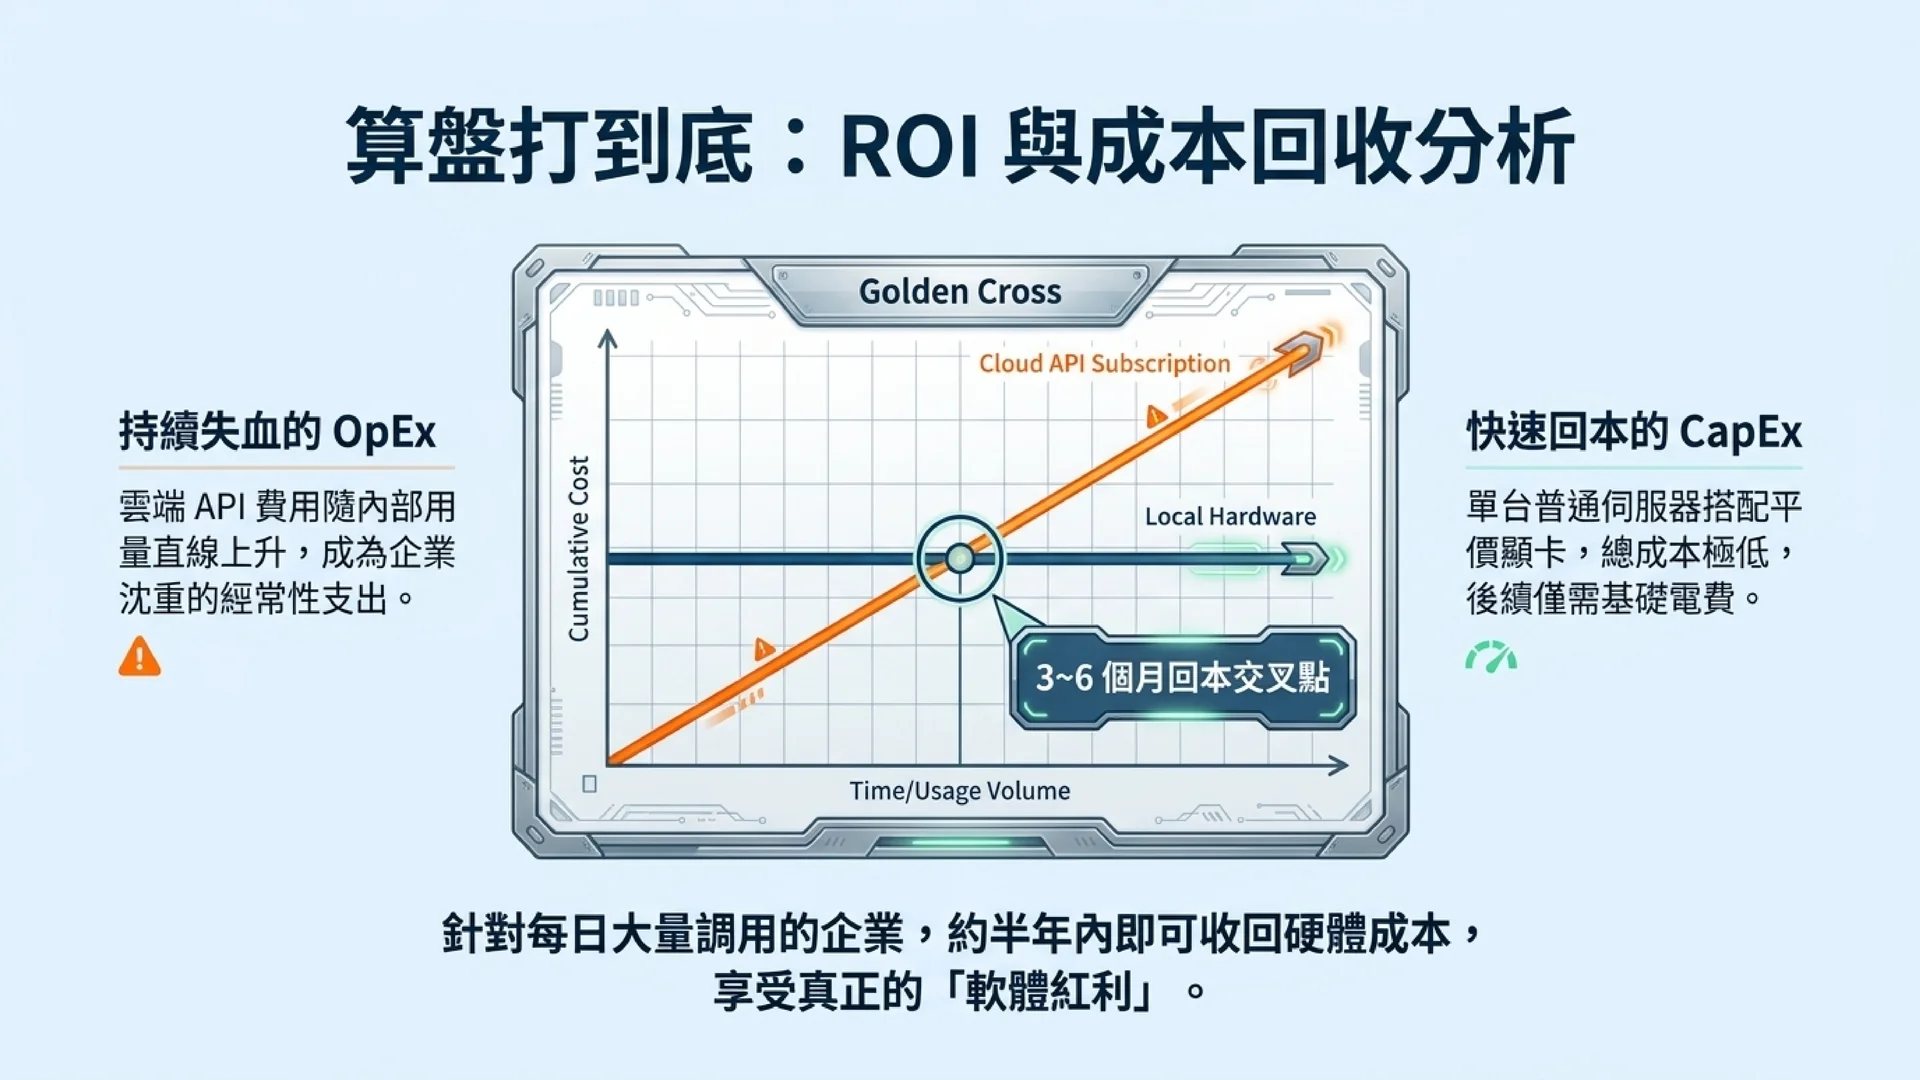
在相同預算下,我能得到多少 VRAM、多少有效 Tokens/s、多少 Concurrent Users,以及多少維護成本?
這才是企業真正應該計算的 AI TCO。
真正值得注意的是「軟體紅利」
這次 R9700 的故事,我認為最容易被誤解成:
「AMD 終於追上 NVIDIA。」
但從工程師角度,我看到的是另一件事。
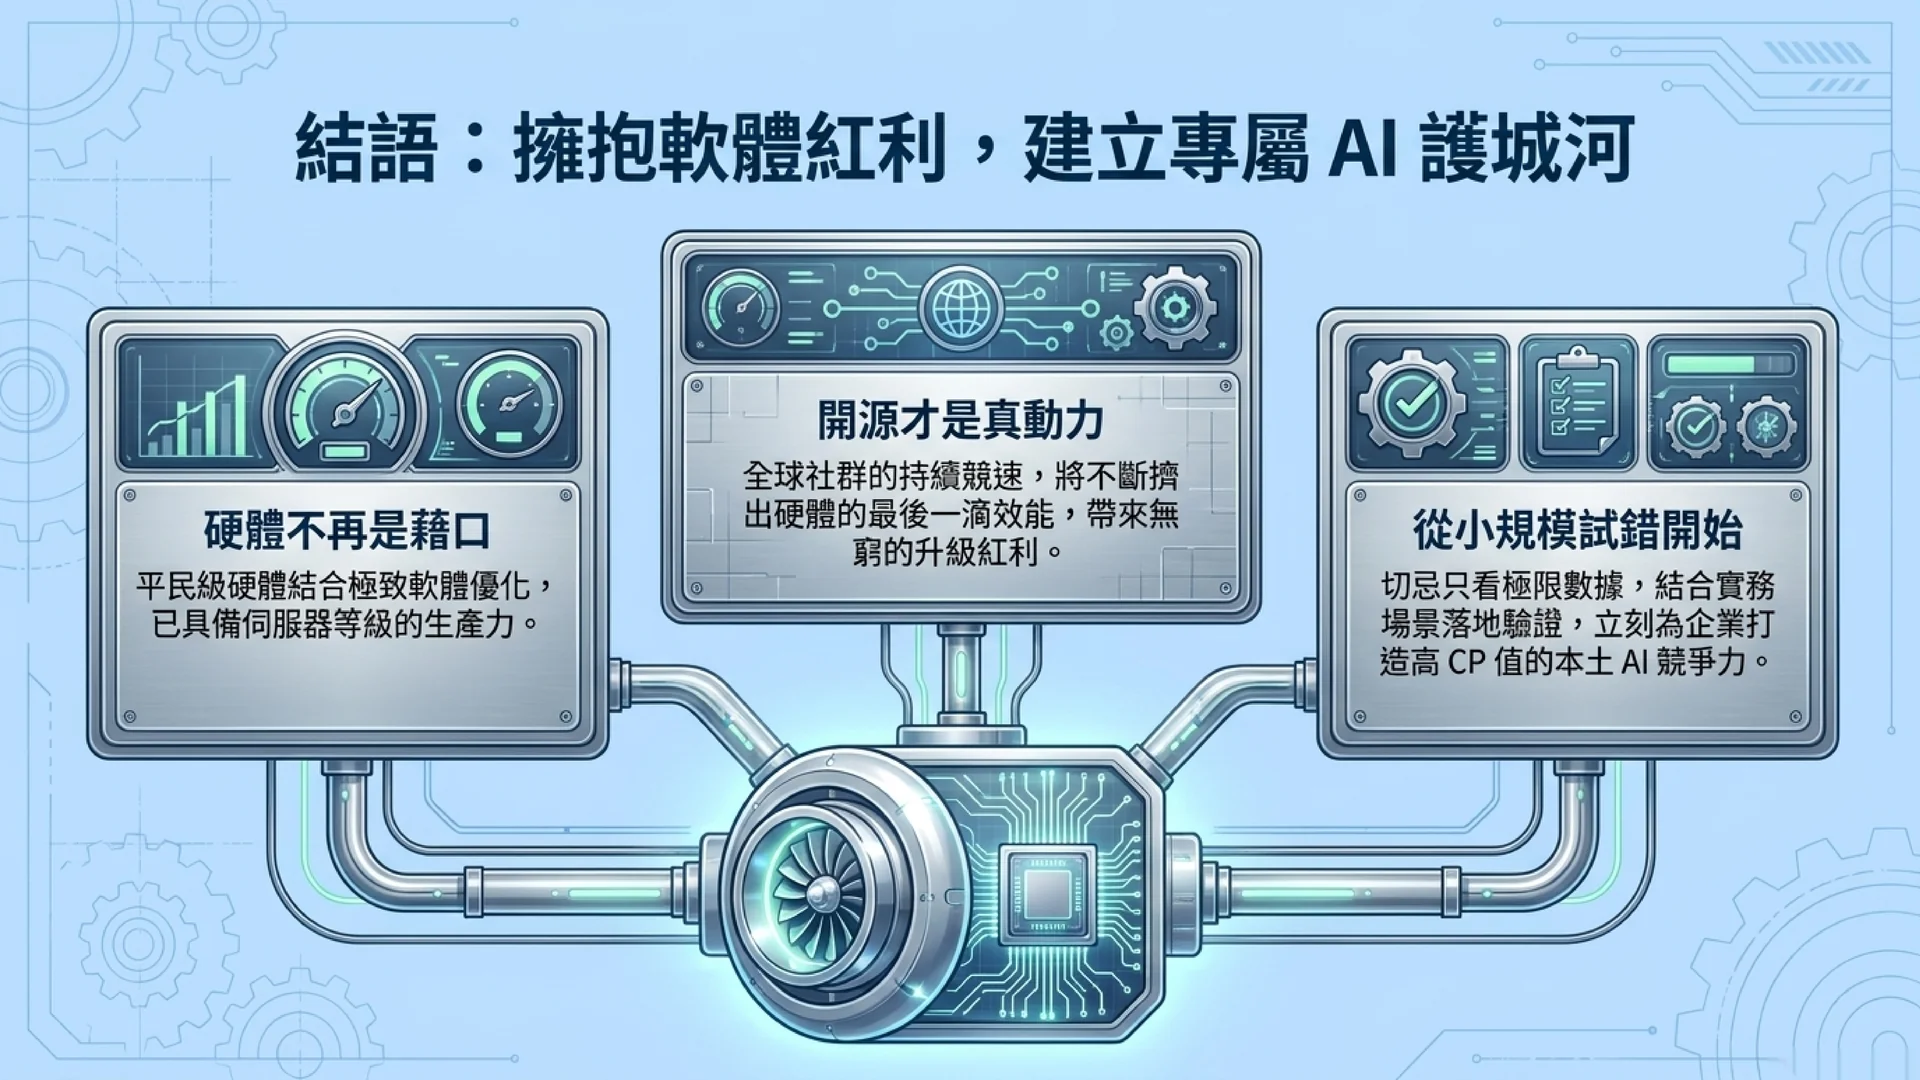
AI GPU 正在進入一個「軟體可以重新定義硬體價值」的時代。
NVFP4 模型原本不是為 AMD 這條路徑設計的。
現在透過 Online Conversion 轉成 MXFP4。
再透過新的 Kernel、推論引擎、量化與 Speculative Decoding,把原本沒有完全發揮的硬體能力一層一層榨出來。
最後,同一張 GPU,作者測到接近兩倍的效能提升。
這對 AI 開發者是一個訊號:
現在可能正是研究 AMD Local AI 生態很有意思的時間點。
而對中小企業則是另一個訊號:
地端 AI 的硬體門檻正在下降。
未來一家 5 人、10 人、20 人的公司,未必需要昂貴的資料中心 GPU,也未必所有 AI 工作都必須送到雲端 API。
一台放在公司的 Local AI Server,就可能服務 RAG、Coding、文件分析、內部 Agent 與知識庫。
所以這次最值得記住的,不是 153 Tokens/s。
也不是 AMD 有沒有打贏 RTX 5090。
真正值得注意的是:
顯卡沒換,模型沒換,軟體堆疊一改,效能就可能完全不同。
過去我們買 AI 算力,最先問的是:
「你用哪張 GPU?」
接下來更值得問的可能是:
「你的軟體堆疊,把這張 GPU 發揮到幾成?」
這才是 Local AI 下一階段真正精彩的地方。